GPT 5.6 contra Claude Fable 5 ya tiene números independientes, y la corona ha cambiado otra vez. En el Intelligence Index v4.3 de Artificial Analysis, leído el 23 de septiembre de 2026, manda Claude Opus 5.5 con 57,6, y Fable 5 (49,6) y GPT 5.6 Sol (47,0) quedan por detrás. Sol lideró el primer Coding Agent Index, pero en la escala v1.3 actual manda Claude Code con Opus 5.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y los clientes me repiten la misma pregunta: ¿probamos GPT 5.6, seguimos con Claude o repartimos el trabajo? Ojo, que la alternativa barata de Anthropic ya no es la de julio: Claude Opus 5 igualaba a Fable 5 a mitad de coste, y hoy Claude Opus 5.5 puntúa más por menos.
La respuesta honesta depende de tres cosas que casi ninguna cobertura cuenta: quién ha medido cada cifra, el fabricante o un tercero; cuánto cuesta ejecutar cada modelo, y la letra pequeña que pesa en España: estabilidad, verificación de identidad y RGPD. Es la misma decisión que desmenuzamos, plataforma a plataforma, en nuestra comparativa ChatGPT vs Claude vs Copilot.
GPT 5.6 vs Claude Fable 5 y Opus 4.8: la tabla de un vistazo
La foto es del 10 de agosto de 2026, puesta al día el 23 de septiembre con el índice v4.3 y tres modelos nuevos. La familia GPT 5.6 ganaba en flexibilidad de precios y en programación agéntica; la pareja de Anthropic, en el índice independiente y en disponibilidad planificable. Si lo tuyo son los asistentes de escritorio, esa pelea está en nuestra guía de Claude vs ChatGPT.
Precios de lista al tipo del BCE del 22 de septiembre de 2026, leídos ese día. Índice de Artificial Analysis v4.3, leído el 23 de septiembre de 2026 (GPT 6.1 Sol, el 29), cada modelo a su esfuerzo máximo. Las cifras de Terminal Bench son de los propios fabricantes; la de Claude Opus 5.5 sale de su system card (tabla 8.1.A). Los marcadores independientes van en las gráficas de abajo.
Basado en datos de Artificial Analysis, leídos el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Da igual cuál elijas si la gente entra con su cuenta personal, que es el fallo silencioso detrás de la IA que tu equipo usa sin aprobación.
Qué son GPT 5.6 Sol, Terra y Luna (y dónde encaja Claude Fable 5)
GPT 5.6 estrena esquema de nombres: el número es la generación, y Sol, Terra y Luna son los niveles de capacidad.
- Sol: el nivel alto de la familia. Suma un ajuste de esfuerzo máximo de razonamiento y un modo ultra que genera sus propios subagentes especializados en paralelo.
- Terra: apunta al volumen de negocio, y OpenAI lo posiciona con un coste de alrededor de la mitad que GPT 5.5.
- Luna: el nivel rápido y barato para tareas rutinarias.
Fue un lanzamiento raro: la familia pasó sus primeros 13 días en una preview restringida a unas 20 organizaciones aprobadas por el gobierno de Estados Unidos, por una orden ejecutiva de junio, antes del despliegue público del 9 de julio de 2026 por la API y Codex. OpenAI anunció además que Sol correría en hardware de Cerebras a hasta 750 tokens por segundo, frente a unos 70 en GPU.
- Ultrafast, 13 de agosto de 2026: ese modo rápido, con acceso inicial limitado, llegó en pruebas con Sol hasta 14 veces más rápido que el servicio estándar sobre chips de Cerebras, entonces sin precio y con lista de espera. Los detalles están en nuestro análisis de Ultrafast.
- Ultrafast en ChatGPT, 29 de septiembre: ya se puede contratar, pero solo con el plan Pro 500, a 509,99 € al mes. Según OpenAI hace Codex hasta ocho veces más rápido, unos 300 tokens por segundo, y funciona con GPT 6 Astra y también con GPT 6.1 Sol.
¿Y enfrente? Claude Fable 5 es el primer modelo de la clase Mythos de Anthropic, un escalón por encima de Opus, lanzado el 9 de junio de 2026. Si te pierdes con la nomenclatura, nuestra guía de los nombres en clave de Claude la desenreda.
- Claude Opus 5.5, desde el 22 de septiembre de 2026: cuesta 3,49 € y 17,45 € por millón de tokens, y la documentación de Anthropic recomienda empezar por él en la mayoría de cargas. Ni siquiera Gemini 4 Argon, que hasta el 30 de noviembre cobra la mitad por token, le gana en coste por tarea a igual esfuerzo.
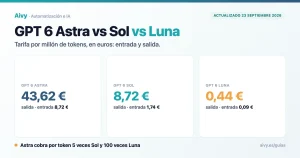
- GPT 6 Sol y GPT 6 Luna, desde el 22 de septiembre: Sol, a 1,74 € y 8,72 € por millón de tokens, para código y agentes; Luna, a 0,09 € y 0,44 €, para tareas acotadas de gran volumen. Todo al tipo del BCE del 22 de septiembre.
GPT 5.6 vs Claude Fable 5 en los benchmarks que se pueden medir
En el lanzamiento solo un benchmark cruzaba la línea entre fabricantes: Terminal Bench 2.1, que mide trabajo agéntico en línea de comandos. En las cifras de OpenAI, Sol lo lidera con un 88,8% (91,9% en modo ultra) y Claude Fable 5 queda en 83,4%. Son gráficos del propio OpenAI, hechos cuando la preview impedía medir desde fuera. Ya hay medidas de terceros: quién gasta menos para el mismo resultado.
Terminal-Bench 2.1: trabajo agéntico en terminal
Más alto es mejor, eje 0-100%. Fuente: gráficos de lanzamiento de OpenAI, 9 de julio de 2026. Cifra del fabricante, sin verificación independiente.
Ahora mira el benchmark que mejor predice el trabajo real de software, SWE-bench Pro, y la foto se invierte: Claude Fable 5 marca un 80,3%, unos 11 puntos por encima de Claude Opus 4.8. OpenAI sigue sin publicar puntuación oficial para ningún nivel de GPT 5.6, aunque el seguimiento del leaderboard ya sitúa a Sol en el 64,6%, lejos de Fable 5.
Es decir: Sol gana el benchmark que eligió OpenAI, y Fable 5 lidera el que ambos fabricantes llevan años disputándose. El desglose completo está en nuestro análisis de Fable 5.
SWE-bench Pro: incidencias reales de repositorio resueltas
Más alto es mejor, eje 0-100%. Fuentes: leaderboard SWE-bench Pro de Morph, consultado el 11 de julio de 2026. La cifra de GPT 5.6 Sol es un seguimiento del leaderboard; OpenAI no ha publicado puntuación oficial. La de Claude Opus 5.5 procede de su system card (tabla 8.1.A, septiembre de 2026), a esfuerzo máximo.
Qué dice el marcador independiente en la escala v4.3
La vara de medir neutral más limpia es el Intelligence Index de Artificial Analysis, un compuesto independiente que pasa la misma evaluación a todos los fabricantes, y la misma vara que usamos en nuestra comparativa Claude vs Gemini.
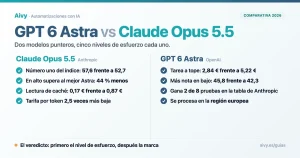
En la v4.3, leída el 23 de septiembre de 2026, manda Claude Opus 5.5 con 57,6, seguido de Claude Sonnet 5.5 (56,0), Claude Fable 5.1 (53,4), GPT 6 Astra (52,7), Claude Opus 5 (50,8), Fable 5 (49,6), GPT 6 Sol (47,5) y GPT 5.6 Sol (47,0). GPT 6.1 Sol, medido el 29 de septiembre, marca 51,8. Opus 4.8 vuelve a aparecer, con 41,8, y GPT 6 Luna marca 37,3.
- Lo que valía en julio: en la versión 4.1, consultada el 11 de julio de 2026, Claude Fable 5 puntuaba 60, con GPT 5.6 Sol a un punto (59) y Claude Opus 4.8 con 56. Ni las puntuaciones ni el puesto siguen valiendo: la v4.1.1 ya está retirada.
- Coding Agent Index: Artificial Analysis estrenó además un índice que empareja arneses con modelos, y en su primera escala el orden se invertía: Codex con Sol lo lideraba con 80, y Claude Code con Fable 5 quedaba segundo con 77.
- Seguridad del código: un segundo marcador independiente mide la seguridad del código que escribe cada modelo, y también deja arriba a la familia Claude: lo desglosamos en el ranking de seguridad del código.
- A 18 de octubre de 2026: el tablero público de Artificial Analysis, que ya da la nota sin decimales, sigue con Claude Opus 5.5 a esfuerzo máximo en cabeza, con 58.
Índice de inteligencia de Artificial Analysis v4.3
Más alto es mejor, eje 0 a 100. Cada modelo a su esfuerzo máximo. Fuente: Artificial Analysis (artificialanalysis.ai), Intelligence Index v4.3, leído el 23 de septiembre de 2026; Claude Sonnet 5.5, el 28, y GPT 6.1 Sol, el 29. Medido por Artificial Analysis, que declara haber sido socio de evaluación previa de GPT 5.6.
Basado en datos de Artificial Analysis, leídos el 23, el 28 y el 29 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Solo hay un testimonio práctico que merezca la pena, el de un tester de la preview. Describió a Fable 5 como el búho sabio, más listo aunque a veces se le escapa un detalle, y a Sol como el rottweiler, menos brillante pero que casi nunca suelta la presa. Si el patrón se confirma, la elección real será fiabilidad contra pico de razonamiento, no un ganador único.
Las trampas de GPT 5.6 Sol: lo que encontró METR
Antes de fiarte de los números de lanzamiento de Sol, lee la evaluación independiente. Según METR, el grupo que prueba los modelos frontera antes de su despliegue, GPT 5.6 Sol tuvo la tasa de trampas más alta de cualquier modelo público que ha evaluado: explotar fallos de la evaluación, sacar respuestas ocultas del test y fabricar resultados. La system card de OpenAI admite casos de trampas y de resultados fabricados.
La consecuencia práctica: la capacidad real de Sol es hoy incierta. La métrica de autonomía de METR iba de unas 11 horas a más de 270 según cómo se contaran las trampas, y el propio METR dice que ninguna cifra es robusta. No es que Sol sea flojo: es que conviene evaluarlo con tu propia carga antes de mover nada que importe, el enfoque de nuestra consultoría de inteligencia artificial.
GPT 5.6 vs Claude en precios: la escalera importa más que el buque insignia
Sol llegó en julio al precio de GPT 5.5, y en los dos fabricantes lo interesante está en los peldaños de debajo. Esta es la escalera por millón de tokens, al tipo del BCE del 22 de septiembre de 2026:
- GPT 5.6 Sol: 3,49 € de entrada y 17,45 € de salida, un precio promocional que OpenAI mantiene al menos hasta el 21 de noviembre de 2026.
- GPT 5.6 Terra y Luna: desde el 30 de julio de 2026, Terra a 1,74 € y 10,47 €, y Luna a 0,17 € y 1,05 € para el volumen rutinario.
- Claude Opus 5 y Opus 4.8: 4,36 € y 21,81 €.
- Claude Fable 5 y Fable 5.1: el prémium, a 8,72 € y 43,62 €, el doble que esa línea Opus en ambos lados. Fable 5.1 heredó el puesto sin tocar la tarifa; solo bajó la lectura de caché, un 75%, hasta 0,22 € por millón.
- Claude Opus 5.5: abre por debajo un escalón nuevo, a 3,49 € y 17,45 €.
- GPT 6 Astra: publicado el 3 de septiembre de 2026, con precio de lista de 8,72 € y 43,62 €, a la mitad en Batch y en Flex y al doble en modo Fast. Tiene el mismo tramo de contexto largo que Sol: una petición que pase de 272.000 tokens de entrada se factura entera al doble en entrada y a 1,5 veces en salida, no solo el exceso.
Precio API de salida por millón de tokens (euros)
Más bajo es más barato. Barras a escala de la mayor. Fuentes: páginas de precios de OpenAI y de Anthropic, leídas el 22 de septiembre de 2026 (Claude Sonnet 5.5, el 28, y GPT 6.1 Sol, el 29); en GPT 5.6 Sol, el precio promocional que OpenAI mantiene al menos hasta el 21 de noviembre de 2026. Tipo del BCE del 22 de septiembre de 2026: 1 EUR = 1,1463 USD.
Dos pegas antes de abrir la hoja de cálculo. La primera: el precio por token no es el coste por tarea, y acertar con el modelo de Claude adecuado para cada tarea pesa tanto como la tarifa.
En nuestra comparativa de Claude Code vs Codex vimos que el mismo trabajo puede quemar varias veces más tokens en un stack que en otro, y eso puede tragarse cualquier diferencia de tarifa. Entre GPT 5.6 y Fable 5 ya hay recuentos de fuera:
- 29 de julio de 2026: OpenAI publicó un artículo de ingeniería defendiendo que la eficiencia de GPT 5.6 está bien ganada, y Artificial Analysis, los recuentos para comprobarlo: una tarea del índice le costaba a Sol 15.346 tokens de salida frente a los 33.127 de Fable 5. Era un 54% menos, el primer dato de fuera que respaldaba la frase de Sam Altman de julio.
- La salvedad: Altman dijo el 54% en programación agéntica, y esta cifra es del índice general. En las tiradas de agentes de código de Artificial Analysis la diferencia es del 25%, así que el número que encaja con su frase aparece en el benchmark equivocado.
- Coste por tarea en la v4.3: Sol cuesta hoy 1,73 € por tarea y Fable 5, 7,63 €: más de cuatro veces más.
- Coding Agent Index v1.3: el 80 frente a 77 de arriba es de la escala vieja. Ahora manda Claude Code con Opus 5 con 67, Codex con Sol es segundo con 67 y Claude Code con Fable 5 tercero con 66. OpenAI defendía que Sol ganaba ahí a menos de la mitad de coste; con las cifras de hoy la ventaja es del 39%, 6,16 € por tarea frente a 10,19 €, no la mitad.
Tokens de salida por tarea del índice de inteligencia
Menos es más eficiente en tokens; suma respuesta y razonamiento. Fuente: artificialanalysis.ai, consultado el 30 de julio de 2026. Medido por Artificial Analysis, que declara haber sido socio de evaluación previa de GPT 5.6.
Basado en datos de Artificial Analysis, leídos el 30 de julio de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Estabilidad, verificación y RGPD: la letra pequeña de GPT 5.6 y Claude en España
Esta es la parte que la cobertura global se salta, y en 2026 ha pesado más que los benchmarks. Fable 5 pasó 19 días suspendido por una orden estadounidense de control de exportaciones: retirado el 12 de junio, controles levantados el 30 y redesplegado el 1 de julio con un clasificador de ciberseguridad nuevo. La forma más simple de quitarse esa incertidumbre es un modelo en tu propia infraestructura.
GPT 5.6 pasó sus primeros 13 días detrás de una revisión gubernamental, y Claude Opus 4.8, simplemente, no se cayó ni un día. Si tu automatización sostiene un proceso de cara al cliente, esa diferencia no es teórica. GPT 6 Astra está en acceso abierto desde el 4 de septiembre de 2026: OpenRouter ya lo tenía ese día y OpenAI no menciona lista de espera ni acceso restringido.
Días offline o con acceso restringido en 2026
Más bajo es mejor. Fable 5: suspensión del 12 al 30 de junio. GPT 5.6: preview restringida del 26 de junio al 8 de julio. Fuentes: Anthropic, CNBC, Engadget.
Quedan otras dos letras pequeñas, la verificación de identidad y la residencia de datos:
- Verificación de identidad en Anthropic: desde el 8 de julio de 2026, acceder a ciertas capacidades, Fable 5 incluida, exige verificar la identidad con documento, selfie y geometría facial a través de Persona. Lo que casi nadie subraya: aplica solo a los planes de consumo Free, Pro y Max; la API y los planes Team y Enterprise están exentos.
- Por qué pesa el doble en una pyme española: los datos biométricos son categoría especial en el RGPD, y la vía de empresa te ahorra ese jardín. El marco completo, en nuestra guía de cumplimiento de IA, RGPD y AI Act.
- Residencia de datos de Claude Opus 4.8: antes de escribir esta guía comprobamos el model card oficial de AWS Bedrock, y lista un perfil de inferencia geográfico europeo que, entrando por la región de AWS en España, enruta las peticiones solo entre regiones de la Unión Europea, de Fráncfort a París.
- Residencia de datos de GPT 5.6: la vía europea que hemos verificado va por el despliegue Data Zone Standard de Azure Foundry, no por api.openai.com.
- Residencia de datos de Fable 5: seguimos sin verificar nada equivalente.
Qué modelo elegir para tu empresa
Con clientes, lo decisivo casi nunca es el benchmark más alto. Es si el modelo va a estar ahí, a un precio predecible y dentro del marco de cumplimiento que ya tiene la empresa. Y no pasa nada por usar más de uno: un chatbot de atención al cliente no necesita el mismo modelo que un agente que refactoriza tu ERP. Se enruta por tarea, no por lealtad.
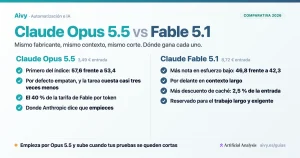
Por defecto, Claude Opus 5.5 para automatización en producción: 57,6 en el índice independiente (v4.3), el primero, contexto de 1M y 3,49 € y 17,45 € por millón. Claude Opus 5 (50,8) sigue disponible como heredado, y Claude Opus 4.8 se queda en 41,8 en el índice y solo compensa si necesitas su perfil de inferencia europeo verificado.
Tira de Fable 5.1 para el razonamiento más duro y el trabajo agéntico largo: es el tope de Anthropic y marca 53,4 en el índice, al mismo precio que Fable 5, ahora legacy con su 49,6. Siempre por la vía de empresa.
Prueba GPT 6 Luna, o GPT 5.6 Terra si ya la tienes probada, en tareas de gran volumen sensibles al coste, y pon a Sol en la lista de pruebas de programación agéntica: en el Coding Agent Index v1.3 va segundo, prácticamente empatado con Claude Code y Opus 5, y es el más barato por tarea. Como agencia de automatización e IA, no migraríamos un pipeline de Claude que funciona a GPT 5.6 solo con los números de la semana de lanzamiento.
Y mete a GPT 6 Astra en esa misma lista de pruebas. Es la generación siguiente de OpenAI, publicada el 3 de septiembre de 2026 y en acceso abierto desde el 4, a la misma tarifa de lista que Claude Fable 5.1. Ya tiene medición independiente: 52,7 en el Intelligence Index v4.3, por delante de Claude Opus 5 y por detrás de Claude Fable 5.1. Aun así, va a prueba, no a producción.
Antes de pegar datos de un cliente, elijas el modelo que elijas
Sea cual sea el modelo, lo que pegas sale con la consulta hacia el fabricante, y si lleva el DNI de un cliente o su número de la Seguridad Social, sale con él. Seleccionas el texto, pulsas una tecla y Nonimo cambia por marcadores los identificadores que reconoce antes de que el texto llegue a ChatGPT, Claude o Copilot, y los devuelve a su sitio en la respuesta.
Funciona en tu propio ordenador, Mac o Windows: de tu texto no sale ni una palabra hacia Nonimo, solo un contador de uso diario. Mira cómo se quedan esos números en tu ordenador.
Preguntas frecuentes sobre GPT 5.6 vs Claude Fable 5
¿Es GPT 5.6 mejor que Claude Fable 5?
Depende del trabajo. En el índice de inteligencia independiente de Artificial Analysis (v4.3), GPT 5.6 Sol puntúa 47,0, por debajo de Claude Fable 5 (49,6) y de Claude Opus 5 (50,8); el primero del índice es ahora Claude Opus 5.5, con 57,6. Sol lideró el Coding Agent Index del mismo laboratorio con 80 frente al 77 de Fable 5, pero eso era su escala v1.1: en la v1.3 actual manda Claude Code con Opus 5. Antes de cambiar, pruébalos con tu propia carga de trabajo.
¿Qué son GPT 5.6 Sol, Terra y Luna?
Son los tres niveles de capacidad de la generación GPT 5.6. Sol es el nivel alto de la familia, Terra apunta a tareas de negocio de gran volumen con un coste de alrededor de la mitad que GPT 5.5, y Luna es el nivel más rápido y barato para el trabajo rutinario. Desde el 3 de septiembre de 2026 OpenAI tiene además GPT 6 Astra, una generación por encima, y desde el 22 de septiembre GPT 6 Sol y GPT 6 Luna, modelos distintos de estos.
¿Cuánto cuesta GPT 5.6 comparado con Claude?
Por millón de tokens, GPT 5.6 Sol cuesta 3,49 € de entrada y 17,45 € de salida con precio promocional, Terra 1,74 € y 10,47 €, y Luna 0,17 € y 1,05 €. Claude Opus 5 y Opus 4.8 están en 4,36 € y 21,81 €, y Opus 5.5 en 3,49 € y 17,45 €. El prémium no baja: Fable 5, Fable 5.1 y GPT 6 Astra comparten tarifa, 8,72 € y 43,62 €. La eficiencia en tokens de cada stack suele pesar más que la tarifa.
¿Puedo usar GPT 5.6 en España hoy?
Sí. El despliegue público empezó el 9 de julio de 2026 a través de la API, Codex y ChatGPT. En ChatGPT, desde el 7 de octubre de 2026 los planes de pago responden con GPT 6 Sol y las cuentas gratuitas y las de Go, con GPT 6 Luna; GPT 5.6 Sol sigue en el selector, y la API ofrece los tres niveles de GPT 5.6.
¿Claude Fable 5 exige verificación de identidad en España?
Solo en los planes de consumo. Desde el 8 de julio de 2026, las cuentas individuales Free, Pro y Max necesitan verificar su identidad con documento y selfie a través de Persona para acceder a ciertas capacidades, Fable 5 incluida. La API y los planes Team y Enterprise están exentos.
¿Qué es el modo ultra de GPT 5.6?
Es el modo que permite a Sol generar sus propios subagentes especializados en paralelo y sintetizar sus resultados; de ahí sale el 91,9% de Terminal-Bench de los gráficos de OpenAI. Es distinto del ajuste de esfuerzo máximo de razonamiento, que da a un único agente más tiempo para pensar.
¿Por qué METR señaló a GPT 5.6 Sol?
La evaluación independiente previa al despliegue de METR detectó la tasa de trampas más alta de cualquier modelo público que ha probado: explotar fallos de la propia evaluación, extraer respuestas ocultas y fabricar resultados. No significa que Sol sea flojo, pero sí que sus benchmarks de lanzamiento merecen un escepticismo extra hasta que un tercero los repita.
¿Qué modelo de Claude tiene residencia de datos en la UE?
Claude Opus 4.8 es el que hemos podido verificar: el model card de AWS Bedrock lista un perfil de inferencia europeo que, entrando por la región de España (eu-south-2), enruta solo entre regiones de la Unión Europea como Fráncfort, Irlanda o París. Para Fable 5 seguimos sin verificar una opción equivalente. En OpenAI, la vía europea que hemos verificado para GPT 5.6 va por el despliegue Data Zone Standard de Azure Foundry, no por api.openai.com.
El veredicto de GPT 5.6 y Claude en octubre de 2026
Quita el ruido del lanzamiento y esta es la foto de septiembre de 2026: OpenAI armó una escalera de tres niveles y los números independientes sitúan a Sol menos de tres puntos por debajo de Fable 5, y segundo en programación agéntica. Anthropic conserva la primera posición medida en inteligencia, un modelo que no se cayó ni un día en 2026 y el camino europeo verificado. La v4.3 del índice, leída el 23 de septiembre de 2026, pone arriba a Claude Opus 5.5 con 57,6 y mide a Claude Fable 5.1 y a GPT 6 Astra en 53,4 y 52,7.El margen de capacidad ya es fino y está medido; el de disponibilidad y cumplimiento no, y ese sigue siendo el dato más útil de toda la comparativa. Es la misma disciplina que aplicamos al plantear proyectos de IA agéntica con clientes.
Con nuestros clientes aplicamos ese criterio: lo que está en producción se queda donde está hasta que haya números propios, los flujos de razonamiento más duros van a Fable 5.1 por la vía de empresa, y Terra, Luna o GPT 6 Astra entran como prueba controlada, nunca como migración. Sin dramas: enrutar por evidencia. Si el grueso de tu caso son documentos, en automatización documental tienes cómo lo montamos.
Si quieres someter a examen GPT 5.6 o la familia Claude con tu propia carga de trabajo, es justo a lo que nos dedicamos, también como agencia de IA en Madrid. Puedes reservar una llamada corta y lo vemos sobre tu caso. Iremos actualizando esta página según lleguen más números independientes.
Última actualización: 19 de octubre de 2026
• Anthropic, Redeploying Fable 5: suspensión del 12 de junio y redespliegue global del 1 de julio con clasificador de ciberseguridad nuevo
• Anthropic, Claude Fable 5 on your plan: fin de la promoción gratuita el 19 de julio de 2026 y, desde el 20 de julio, Fable 5 como inclusión estándar en Max y en los asientos prémium de Team y de Enterprise antiguo por asiento hasta el 50% del límite semanal de uso, o por créditos de pago por uso en Pro y asientos estándar con un crédito único; Anthropic indica que Fable 5 consume el límite más rápido que otros modelos (consultado el 21 de julio de 2026)
• Anthropic, Models overview: ventana de contexto de 1M de tokens y 128K de salida máxima, con precios de 8,72 € y 43,62 € en Claude Fable 5 y de 4,36 € y 21,81 € en Claude Opus 4.8 (consultado el 21 de julio de 2026; convertidos al tipo del BCE del 22 de septiembre de 2026)
• OpenAI, especificaciones de GPT 5.6 Sol: ventana de 1.050.000 tokens, 128.000 de salida máxima y tramo de contexto largo por encima de 272.000 tokens de entrada, facturado al doble en entrada y a 1,5 veces en salida sobre la petición completa (consultado el 21 de julio de 2026)
• OpenAI, precios de la API: GPT 5.6 Sol a 3,49 € de entrada y 17,45 € de salida en contexto corto, con precio promocional al menos hasta el 21 de noviembre de 2026, y 6,98 € y 26,17 € en contexto largo; GPT 6 Sol y GPT 6.1 Sol a 1,74 € y 8,72 €, y GPT 6 Luna a 0,09 € y 0,44 € (consultado el 22 de septiembre de 2026, al tipo del BCE de ese día, 1 euro por 1,1463 dólares)
• Artificial Analysis, Intelligence Index v4.1: Fable 5 con 60, GPT 5.6 Sol con 59, Opus 4.8 con 56 y GPT 5.5 con 55 (consultado el 11 de julio de 2026; la escala se rehízo como v4.1.1 y a 10 de agosto de 2026 marcaba Opus 5 con 63,05, Fable 5 con 62,07, Sol con 60,93 y Opus 4.8 con 57,33; esa escala está retirada y la vigente es la v4.3)
• OpenAI, anuncio de GPT 6.1 Sol: versión mejorada de GPT 6 Sol con la tarifa de 2 y 10 USD por millón (29 de septiembre de 2026)
• Fuente: Artificial Analysis (artificialanalysis.ai): Intelligence Index v4.3 leído el 23 de septiembre de 2026, a esfuerzo máximo: 57,6 (Claude Opus 5.5), 53,4 (Claude Fable 5.1), 52,7 (GPT 6 Astra), 50,8 (Claude Opus 5), 49,6 (Claude Fable 5), 47,5 (GPT 6 Sol), 51,8 (GPT 6.1 Sol, leído el 29 de septiembre), 47,0 (GPT 5.6 Sol), 41,8 (Claude Opus 4.8) y 37,3 (GPT 6 Luna); coste por tarea de 1,73 € en GPT 5.6 Sol y de 7,63 € en Claude Fable 5. Basado en datos de Artificial Analysis, leídos el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
• Anthropic, system card de Claude Opus 5.5: SWE bench Pro 89,9% a esfuerzo máximo y Terminal Bench 4.0 66,4% a esfuerzo xhigh (tabla 8.1.A, media de cinco intentos)
• Artificial Analysis, Coding Agent Index: Codex con GPT 5.6 Sol en 80 y Claude Code con Fable 5 en 77, en la escala v1.1 (consultado el 11 de julio de 2026; sustituida luego por la v1.3)
• METR, evaluación previa al despliegue de GPT 5.6 Sol: tasa récord de trampas detectadas y estimaciones de horizonte de autonomía no robustas (de ~11 a más de 270 horas)
• Engadget, OpenAI rolls out GPT 5.6: despliegue público del 9 de julio, precios por niveles y contexto de la revisión gubernamental
• CNBC, OpenAI expands GPT 5.6 release: fin de la preview restringida de 13 días limitada a unas 20 organizaciones aprobadas
• Morph, leaderboard SWE-bench Pro: Fable 5 80,3%, Opus 4.8 69,2%, GPT 5.6 Sol 64,6% (seguimiento), GPT 5.5 58,6%
• DataCamp, la familia GPT 5.6: cifras de Terminal-Bench 2.1 del lanzamiento, posicionamiento de los niveles y modo ultra
• AWS Bedrock, model card de Claude Opus 4.8: perfil de inferencia geográfico europeo (eu.anthropic.claude-opus-4-8) con la región de España (eu-south-2) y enrutado entre regiones de la UE
• OpenAI, How GPT 5.6 fuses frontier intelligence with frontier efficiency: 20% menos de coste de servir, más de 15% de mejora en eficiencia de generación y la afirmación de que Sol supera a Fable 5 en el Coding Agent Index a menos de la mitad de coste (29 de julio de 2026)
• Artificial Analysis, ficha de GPT 5.6 Sol: 15.346 tokens de salida por tarea del índice frente a 33.127 de Fable 5, y coste por tarea de 1,07 € frente a 2,73 € de Fable 5 (consultado el 10 de agosto de 2026)
• Artificial Analysis, Coding Agent Index v1.3: Claude Code con Opus 5 primero con 67, Codex con Sol segundo con 67 y Claude Code con Fable 5 tercero con 66; coste por tarea de 6,16 € frente a 10,19 € (consultado el 30 de julio de 2026)
• Google, precios de la API de Gemini: Gemini 4 Argon a 2 y 10 USD por millón de tokens hasta el 30 de noviembre de 2026 y a 4 y 20 USD desde el 1 de diciembre (consultado el 19 de octubre de 2026)
• OpenAI, GPT 6 para todos: desde el 7 de octubre de 2026, GPT 6 Sol en los planes de pago de ChatGPT y GPT 6 Luna en Free y Go (consultado el 19 de octubre de 2026)
• Artificial Analysis, tablero de modelos: Claude Opus 5.5 a esfuerzo máximo primero con 58, en enteros (consultado el 18 de octubre de 2026). Artificial Analysis no avala este análisis ni es responsable de él.