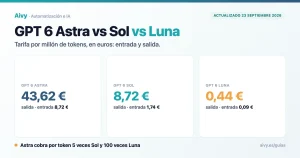
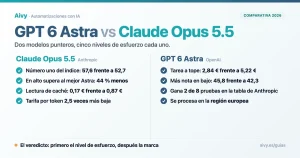
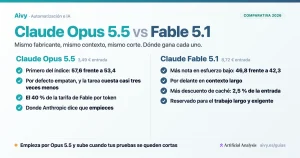
En seis semanas, los dos agentes de programación que de verdad usan mis clientes estrenaron cerebro nuevo: GPT 5.5 entró en Codex el 23 de abril y Claude Opus 4.8 en Claude Code el 28 de mayo. Desde entonces han vuelto a cambiarlo, y hoy son Claude Opus 5.5 y GPT 6.1 Sol. Las dos compañías reclaman la frontera, y las dos tienen razón según qué benchmark leas.
Llevo el éxito de cliente en Aivy, una agencia de automatización con IA, y he pasado dos semanas ejecutando los dos agentes sobre repositorios reales. Opus 4.8 encabezaba entonces los benchmarks y sostenía una base de código mucho mayor, y Codex, con GPT 5.5, llegaba antes a un cambio que funcionaba con tres o cuatro veces menos tokens. Hoy esos papeles los ocupan Opus 5.5 y GPT 6.1 Sol.
Esta guía compara Claude Code y Codex como debería sopesarlos un responsable de ingeniería: benchmarks, el efecto harness que los decide en silencio, contexto, coste en tokens, velocidad, cuotas, residencia de datos y precio. Y si lo que comparas es el modelo de chat y no el agente de terminal, nuestra comparativa ChatGPT vs Claude vs Copilot cubre ese frente.
Claude Code vs Codex de un vistazo
Las dos herramientas riman. Cada una es un agente que vive en tu terminal, edita archivos, ejecuta comandos y comprueba su propio trabajo, con superficies cloud e IDE alrededor. Las diferencias que importan son el modelo por defecto, cuánto contexto sostienen, cuántos tokens gastan y para qué están afinadas. Entre los modelos de septiembre ese consumo lo decide todo: es el empate que se resuelve por tokens.
| Aspecto | Claude Code | Codex |
|---|---|---|
| Fabricante | Anthropic | OpenAI |
| Modelo por defecto | Claude Opus 5.5 (desde Claude Code v2.1.280) | GPT 6.1 Sol (desde la CLI 0.159.1) |
| Superficies | Terminal, IDE, cloud, API | CLI, cloud/web, IDE, GitHub |
| Ventana de contexto | 1M de tokens | 272K (≈258K efectivos) |
| Intelligence Index | 57,6 con Opus 5.5 (v4.3, esfuerzo máximo, el nº1); 50,8 con Opus 5 | 47,5 con GPT 6 Sol; 47,0 con GPT 5.6 Sol |
| Eficiencia de tokens | Verboso | 3-4x más contenido |
| Precio de entrada | 18 €/mes sin IVA (Pro) | 22,99 €/mes (Plus) |
| Mejor para | Trabajo multiarchivo y de horizonte largo | Bucles de terminal rápidos y acotados |
| Modelo superior opcional | Claude Fable 5.1, el más capaz en Claude Code, con /model fable; Fable 5 queda como legacy | Sol es el mayor de los tres GPT 5.6; por encima, OpenAI publicó GPT 6 Astra en la API el 3 de septiembre de 2026 |
Basado en datos de Artificial Analysis, leídos el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Precios de suscripción en euros: Claude, de su página de precios, sin IVA, leída el 19 de octubre de 2026; ChatGPT, precio para España del 30 de septiembre de 2026. Intelligence Index v4.3 de Artificial Analysis, leído el 23 de septiembre de 2026 a esfuerzo máximo; los datos de tokens son de mayo de 2026. Los precios de la API van al tipo del BCE del 22 de septiembre de 2026, 1 euro por 1,1463 dólares.
Qué son exactamente Claude Code y Codex
Codex es el sistema agéntico de programación de OpenAI, repartido en cuatro superficies que comparten cuenta: una CLI open source para la terminal, un agente cloud con sandbox al que delegas tareas, una extensión de IDE y una integración con GitHub. Para situarlo en el mapa más amplio de los agentes de IA para empresas, ese explicador cubre los usos más allá de programar.
Claude Code es el agente de terminal de Anthropic, accesible desde las apps de Claude, la API, Amazon Bedrock, Google Cloud y Microsoft Foundry. Sus piezas son subagentes, skills y slash commands, más Dynamic Workflows, que deja a Claude escribir un script que orquesta de decenas a cientos de subagentes en segundo plano, hasta 1.000 por ejecución. El riesgo aparte es pegar código propietario en herramientas no aprobadas.
Así la lógica de orquestación vive en código y no se come la ventana de contexto principal. Dynamic Workflows ya no es una research preview: está en todos los planes de pago, y en Pro se activa desde /config. Anthropic la empareja con ultracode, que lanza esa orquestación por su cuenta con el esfuerzo en muy alto. La tabla resume qué modelo mueve hoy cada agente.
| Agente | Modelo | Para qué | API por millón de tokens, entrada / salida |
|---|---|---|---|
| Claude Code | Claude Opus 5.5, por defecto desde la v2.1.280 | La mayoría de cargas | 3,49 € / 17,45 € |
| Claude Code | Claude Fable 5.1, con /model fable | Las tareas más largas y difíciles | 8,72 € / 43,62 € |
| Claude Code | Claude Sonnet 5.5, con /model sonnet desde la v2.1.284 | El día a día, más barato | 1,74 € / 8,72 € |
| Claude Code | Claude Haiku 5.5, con /model haiku desde la v2.1.293 | Volumen y tareas acotadas | 0,09 € / 0,44 € hasta 100.000 tokens |
| Codex | GPT 6.1 Sol, por defecto desde la CLI 0.159.1, con razonamiento bajo | Programación y agentes | 1,74 € / 8,72 € |
| Codex | GPT 6 Astra | El más capaz de OpenAI | 8,72 € / 43,62 € |
| Codex | GPT 6 Sol | La versión anterior de Sol | 1,74 € / 8,72 € |
| Codex | GPT 6 Luna | Tareas acotadas de gran volumen | 0,09 € / 0,44 € |
Modelos por defecto según la documentación de Claude Code y el catálogo de la CLI de Codex, leídos el 19 de octubre de 2026. Precios de la API al tipo del BCE del 22 de septiembre de 2026, 1 euro por 1,1463 dólares.
- 23 de abril de 2026: GPT 5.5 entra en Codex, el primer modelo base totalmente reentrenado de OpenAI desde GPT 4.5. El 14 de octubre se retiró de Codex para quien entra con su cuenta de ChatGPT.
- Mayo: OpenAI publica actualizaciones de Codex casi semanales y convierte la CLI en un runtime autónomo persistente, con un modo objetivo por defecto y uso del ordenador.
- 9 de julio: GPT 5.6 sale en tres tamaños, Sol, Terra y Luna, y Sol pasa a ser el modelo de Codex. En el índice v4.3 de Artificial Analysis, leído el 23 de septiembre a esfuerzo máximo, marca 47,0, por debajo de Claude Opus 5 (50,8) y Claude Fable 5 (49,6), como cuenta nuestra guía de Claude Opus 5.
- Coding Agent Index v1.3: Claude Code con Opus 5 marca 66,74 y Codex con GPT 5.6 Sol, 66,57, un empate técnico que la web redondea a 67. La herramienta de OpenAI la explicamos en qué es Codex y en qué se diferencia del chat.
- 3 y 4 de septiembre: OpenAI anuncia GPT 6 Astra como su modelo más capaz y abre el acceso; hoy ya está en el catálogo de Codex.
- 22 de septiembre: llegan Claude Opus 5.5, por donde la documentación de Anthropic recomienda empezar en la mayoría de cargas, y GPT 6 Sol y GPT 6 Luna. Si aún no tienes claro qué es Claude Code frente al chat de Claude, lo explicamos desde cero.
- 29 de septiembre: GPT 6.1 Sol llega a Codex para Plus, Pro, Business, Enterprise y Edu, y pasa a ser el modelo por defecto de la CLI. Según OpenAI, en DeepSWE v1.1 iguala a GPT 6 Astra por una quinta parte del coste; en el índice general de Artificial Analysis marca 51,83 a máximo, entre Opus 5 y Opus 5.5.
- Meta: también ha entrado en la pelea con Muse Code, que cobra a precio de API y repasamos en la guía sobre el agente de Meta.
- Terminal o editor: los dos son agentes de terminal antes que asistentes de editor; si prefieres la IA dentro del IDE, esa categoría la cubre nuestra guía Cursor vs GitHub Copilot, y en la de OpenClaw, un agente de IA en local enseñamos un agente por dentro.
Claude Code vs Codex en los benchmarks
En el conjunto de números publicados, Opus 4.8 lidera más veces de las que persigue, pero la foto no es un barrido. Donde ambos proveedores publican cifra, el modelo de Claude Code gana la programación agéntica y el razonamiento, y el de Codex es más fuerte en tareas de estilo terminal. Léelos como estimaciones puntuales, no como veredictos: varias brechas caen dentro de las barras de error.
Benchmarks de programación y razonamiento: Opus 4.8 vs GPT 5.5 (generación anterior, mayo de 2026)
Más alto es mejor, eje 0-100%. Fuentes: system card de Opus 4.8 y Artificial Analysis (Terminal-Bench Hard). Las de Claude Opus 5.5 proceden de su system card (tabla 8.1.A, septiembre de 2026), a esfuerzo máximo; en Terminal Bench 2.1 y OSWorld Verified no hay cifra publicada de Claude Opus 5.5, y Artificial Analysis no lo ha medido en Terminal Bench Hard. La de Claude Sonnet 5.5 sale de su anuncio del 28 de septiembre de 2026, con herramientas.
Basado en datos de Artificial Analysis, leídos el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
La brecha de SWE-bench Pro, 69,2% frente a 58,6%, es la que Anthropic pone por delante, y es el benchmark más cercano al trabajo real: resolver una incidencia genuina de GitHub a lo largo de un repositorio en una pasada.
Conviene saber que ahí los dos números son mediciones de la propia Anthropic, incluida la cifra de GPT 5.5, así que trata el tamaño de la brecha como indicativo y no como dogma. En los marcadores independientes de Terminal-Bench, GPT 5.5 se pone ligeramente por delante. Y la otra mitad del tablero, Claude contra Google, la cubrimos en nuestra comparativa Claude vs Gemini.
Claude Code contra Codex en programación: el harness importa
El detalle que decide la mayoría de discusiones de benchmarks de terminal: el mismo modelo puntúa muy distinto según el harness, el andamiaje que lo ejecuta. En Terminal Bench 2.1, GPT 5.5 saca un 78,2% en el harness público neutral y un 83,4% en la Codex CLI. Opus 4.8 saca un 74,6% en el mismo harness y un 78,9% en Claude Code: los dos ganan unos cuatro puntos en casa.
El efecto harness: Terminal-Bench 2.1, mismos modelos, distinto andamiaje
Eje 0-100%. Harness nativo frente a harness público neutral. Fuente: ranking de tbench.ai (±2,2-2,5).
La lección no es quién gana por un 0,7%, sino que el agente que envuelve al modelo, con su gestión del contexto, los reintentos y las llamadas a herramientas, hace trabajo de verdad. Comparar Claude Code y Codex es comparar dos harnesses tanto como dos modelos, y tus resultados sobre tu stack son el benchmark que cuenta. Es la lógica de nuestra auditoría de automatización con IA.
Contexto largo: Claude Code y Codex ante bases de código grandes
La diferencia más clara está aquí. Claude Code trae una ventana de un millón de tokens por defecto con Opus 5.5, Sonnet 5.5, Fable 5.1 y Haiku 5.5. Codex ejecuta GPT 6.1 Sol, y el catálogo de su CLI le fija 272.000 tokens de serie y un máximo de 872.000. Con GPT 5.6 Sol, la cifra usable en sesión quedaba cerca de 258.000.
En un monorepo grande, esa es la diferencia entre sostener el servicio entero en contexto y estar realimentándolo. En esa liga ya no juega solo Gemini: GPT 6 Astra y GPT 6.1 Sol llegan a 1.050.000 tokens en la API, un 5 % por encima del millón de Claude Code, pero Codex no los usa enteros de serie. Es una carrera que repasamos en nuestra comparativa ChatGPT vs Gemini.
Ventana de contexto usable dentro del agente
Tokens sostenidos en una sesión. Fuentes: documentación de Anthropic; metadatos de la CLI de Codex de OpenAI; issues de openai/codex; Codex con GPT 6.1 Sol, según el catálogo de modelos de su CLI, leído el 19 de octubre de 2026.
El tamaño es una cosa y usarlo bien es otra. En GraphWalks, la prueba de razonamiento de contexto largo de Anthropic, Claude Opus 4.8 acierta un 68% con un millón de tokens de contexto y un 86% con 256K.
Precisión de Claude Opus 4.8 en contexto largo (GraphWalks F1)
Más alto es mejor. Fuente: System Card de Claude Opus 4.8, tabla 8.9.A.
Tokens y coste: Claude Code frente a Codex
Aquí es donde Codex devuelve el golpe, y fuerte. En tareas de programación idénticas, las pruebas independientes encontraron que Claude Code gasta entre tres y cuatro veces más tokens que Codex: 4,2 veces en un plugin de Figma, 3,6 en una integración de API y 3,2 en una app de turnos. Ese gasto compra una salida más minuciosa y determinista, pero en una factura por token se acumula rápido.
Tokens usados en la misma tarea: Codex vs Claude Code
Barras a escala dentro de cada tarea. Fuente: Morph LLM, pruebas de tarea idéntica, mayo de 2026.
Pero más barato por token no significa más barato por tarea cuando el modelo escribe tres o cuatro veces más tokens. En la v4.3 del índice de Artificial Analysis, leída el 23 de septiembre de 2026 a esfuerzo máximo, cada tarea le cuesta 3,56 € a Opus 4.8 y 2,30 € a GPT 5.5: un 55 % más para sacarle 3,4 puntos. Así queda la generación actual:
Coste por tarea en el Intelligence Index de Artificial Analysis
Barras a escala de la mayor. Cada modelo a su esfuerzo más alto medido (xhigh en GPT 5.5). Fuente: Artificial Analysis (artificialanalysis.ai), Intelligence Index v4.3, leído el 23 de septiembre de 2026 (Sonnet 5.5, el 18 de octubre, y GPT 6.1 Sol, el 29 de septiembre), al tipo del BCE del 22 de septiembre.
Basado en datos de Artificial Analysis, leídos el 23 y el 29 de septiembre y el 18 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Claude Opus 5.5: encabeza el índice con 57,6, a 5,22 € por tarea.
- Claude Sonnet 5.5: llegó el 28 de septiembre, cobra por token lo mismo que GPT 6 Sol y, según Anthropic, en CursorBench 4.0 se queda a unos dos puntos de Opus 5.5, un 55,5% frente a un 57,8%. Su tarea a máximo costaba 6,63 € el día del lanzamiento, y en el tablero del 18 de octubre, el de la gráfica, baja a 4,76 €; a alto, de 0,94 € a 0,77 €.
- GPT 6 Sol: marca 47,5 a 0,92 € por tarea.
- GPT 6.1 Sol: cobra lo mismo que GPT 6 Sol y deja la tarea del índice en 0,63 € a máximo, con 51,83 de nota. Es lo que paga quien programa con Codex por API; en los planes de ChatGPT, lo que cuenta es la cuota.
- Tarifas por token: están en la tabla de modelos de arriba; Claude Fable 5.1, el más caro de Anthropic, cobra 8,72 € y 43,62 €. Las de mayo de esta comparativa, 4 y 22 € para Opus 4.8 frente a 4 y 26 € para GPT 5.5, son de la generación anterior.
Dos matices mantienen esto justo. Opus 4.8 ya gastaba un 35% menos tokens de salida que su antecesor en tareas profesionales, así que la brecha se estrecha. Y en las suscripciones los dos entierran el coste por token en un plan plano, donde lo que sientes es la cuota. Para traducir ese gasto a euros de tu equipo, nuestra calculadora de ROI de IA te hace los números.
Precios y planes de Claude Code y Codex
Claude Code no entra en el plan gratuito de Claude: empieza en Pro, que hoy cuesta 18 € al mes sin IVA o 15 € con pago anual, y sigue con Max desde 90 € sin IVA. ChatGPT tiene Free y Go, Plus a 22,99 € y tres planes Pro, a 102,99 €, 229 € y 509,99 €. Lo que muerde es el límite, no el precio.
| Plan | Claude Code (Anthropic) | Codex (OpenAI) |
|---|---|---|
| Gratis | No incluye Claude Code | Free + Go a 7,99 €/mes |
| Entrada | Pro 18 €/mes sin IVA (15 € con pago anual) | Plus 22,99 €/mes |
| Potencia | Max 5x desde 90 € sin IVA; Max 20x sin precio publicado en euros | Pro 100, 200 o 500: 102,99 €, 229 € o 509,99 € |
| Precio API de salida | 17,45 € / 1M tokens (Opus 5.5); Opus 5, 21,81 €; Fable 5.1, 43,62 € | 8,72 € / 1M tokens (GPT 6 Sol); GPT 6 Luna, 0,44 €; GPT 5.5, la generación anterior, 26,17 € |
| Nivel superior en la API | Fable 5.1 a 8,72 y 43,62 € por millón; lectura de caché 0,22 € | GPT 6 Astra desde el 3 de septiembre de 2026, a 8,72 y 43,62 € por millón |
| Modelo de límites | Ventana de 5 horas + tope semanal | Plus: ventana de 5 horas + tope semanal; Pro: sin ventana de 5 horas |
| Mejor valor para programar a diario | Max 5x (desde 90 € sin IVA) | Pro 100 (102,99 €) |
Precios de suscripción en euros: los de Claude, de su página de precios, sin IVA, leída el 19 de octubre de 2026; los de ChatGPT, precio para España del 30 de septiembre de 2026. Los de la API, al tipo del BCE del 22 de septiembre de 2026. Las cuotas de tokens por ventana son estimaciones de la comunidad; ninguno publica números duros.
- GPT 6 Astra en la API: anunciado el 3 de septiembre de 2026 y abierto desde el 4, cuesta 8,72 € de entrada y 43,62 € de salida por millón, con la entrada cacheada a 0,87 €, la misma tarifa de lista que Claude Fable 5.1.
- Ojo con el tramo: una petición que pase de 272.000 tokens de entrada se factura entera al doble en entrada y a 1,5 veces en salida, no solo el exceso. Batch y flex van al 50 % del estándar y el modo fast, al doble.
- Ultrafast: solo en Pro 500 y en los planes Enterprise y Edu elegibles, con GPT 6 Astra y, desde el 8 de octubre, con GPT 6.1 Sol. Según OpenAI hace Codex hasta ocho veces más rápido, y ni Pro 100 ni Pro 200 lo desbloquean comprando créditos.
- Pro 200: vuelve a admitir altas, con menos uso incluido que antes.
- Dots: el agente siempre encendido de OpenAI no entra en Pro en España.
- Límites de Codex: Plus tiene una ventana de cinco horas y puede tener tope semanal; los planes Pro ya no tienen límite de cinco horas.
Claude Code mide el uso en una ventana rodante de cinco horas más un tope semanal. Anthropic dobló esos límites de cinco horas el 6 de mayo de 2026 y quitó el estrangulamiento en hora punta, pero el uso intensivo de Opus sigue tocando el techo semanal antes que Sonnet. El esfuerzo es la otra palanca sobre ese techo, como contamos en los niveles de esfuerzo de Claude Code.
Una lectura práctica: los planes de entrada valen para una o dos sesiones concentradas al día, el pair programming de jornada completa pide Max 5x o Pro 100, y el trabajo agéntico de día entero, Max 20x o Pro 200. Si lo que te frena es el tope semanal, la alternativa es ejecutar el modelo en tu propio equipo, y el gasto pasa a ser una compra.
Claude Code y Codex según los desarrolladores
Las reseñas describen Claude Code como el agente que más planifica: razona más largo, hace más preguntas aclaratorias, planta cara a un plan flojo y suele dar mejor salida visual y de diseño. Para trabajo de oficina sin terminal, Anthropic ofrece la misma idea en la app de Claude, la antigua Claude Cowork, que medimos frente a los otros grandes agentes desde España.
A Codex lo describen como el que actúa: eficiente en tokens, más rápido hasta el primer diff, con un agente revisor integrado que bloquea cambios arriesgados y un navegador dentro de la app para verificar un arreglo de punta a punta. Casi nadie mide si el código resultante es seguro, que es otro eje: lo tienes modelo a modelo en el ranking de seguridad del código con IA.
Un ingeniero de Datadog contó su cambio a Codex tras casi un año en Claude Code: alabó su criterio para usar herramientas y cómo navega tres bases de código a la vez, sin dejar Claude Code, al que llama excelente. Es el ánimo de casi todo análisis fiable: no es un nocaut, es una decisión de enrutado. El mismo patrón lo verás en nuestra comparativa Cursor vs GitHub Copilot.
¿Claude Code o Codex? Cuál elegir según tu equipo
Para una empresa, la decisión rara vez se reduce a un benchmark: pesan más la residencia de datos, el coste predecible y el encaje con la carga real. Los modelos de Claude están en Amazon Bedrock y Google Cloud, con regiones en la UE, así que con obligaciones de RGPD puedes mantener la inferencia en Europa; la API propia de Anthropic solo ofrece la global o Estados Unidos.
Del lado de OpenAI, la API ya tiene residencia europea propia, eu.api.openai.com, para GPT 6.1 Sol, GPT 6 Sol, GPT 6 Astra y GPT 6 Luna, con un recargo del 10% y un contrato de retención modificada. Si tus desarrolladores trabajan dentro de un editor y no en la terminal, nuestra guía Cursor vs Claude Code hace esta misma comparativa para ese montaje.
| Si tú… | Elige | Por qué |
|---|---|---|
| Trabajas sobre un monorepo grande | Claude Code | 1M de contexto frente a 272K |
| Ejecutas tareas de terminal rápidas y acotadas | Codex | Más rápido al primer diff, más ligero |
| Vigilas de cerca el coste en tokens | Codex | 3-4x menos tokens por tarea |
| Necesitas diffs cuidadosos y mínimos | Claude Code | Planifica más, menos fallos de código |
| Resuelves incidencias completas de GitHub | Claude Code | Mejor SWE-bench Pro medido, mayo de 2026 |
| Quieres inferencia en la UE | Claude Code | Bedrock / Google Cloud en regiones europeas |
- La vista por modelo: nuestra comparativa Claude vs ChatGPT cubre razonamiento, escritura y precios.
- El cambio de fondo: la frontera entre IA agéntica frente a IA generativa, que es justo lo que separa a estos agentes de un simple chatbot.
Claude Code o Codex: la conclusión para 2026
No hay un único ganador, y desconfía de quien te venda uno. Claude Code con Opus 5.5 es la opción más fuerte para el trabajo profundo, el contexto grande y los cambios cuidadosos, con Fable 5.1 para lo más largo, y en la gama conviene elegir entre Opus, Sonnet y Haiku. Codex con GPT 6.1 Sol es más rápido, gasta menos tokens y rinde mejor en lo acotado.
Arriba, los dos niveles han acabado en el mismo sitio: GPT 6 Astra y Claude Fable 5.1 comparten tarifa de lista, 8,72 € de entrada y 43,62 € de salida por millón, y el techo de 128.000 tokens de salida. Astra se lleva un 5 % de contexto, 1,05 millones frente a 1 millón, y el corte de conocimiento de Anthropic es dos meses más nuevo.
Un equipo de software de Melbourne con el que trabajo lo resolvió con sensatez: mantuvo las dos suscripciones, Claude Code para la arquitectura y los cambios a lo ancho del repositorio y Codex para los arreglos rápidos, y su gasto apenas se movió. Si quieres conectar agentes de programación a la forma real de trabajar de tu equipo, puedes reservar una sesión de descubrimiento gratuita con Aivy.
Empieza con los dos en el plan de entrada, Pro o Plus, y ejecútalos sobre tu propio repositorio una semana. Después comprométete con el patrón, no con la marca:
- Monorepos grandes, refactors entre servicios y planificación: Claude Code.
- Arreglos acotados, bucles de terminal y volumen alto: Codex.
- Dentro de Claude Code, empieza por Opus 5.5 y sube a Fable 5.1 solo cuando Opus 5.5 con más esfuerzo no llegue.
- Si solo cabe una suscripción, quédate con la que ya toque tu stack.
Preguntas frecuentes sobre Claude Code y Codex
¿Es Claude Code mejor que Codex?
Depende de la tarea. Claude Code (Opus 5.5 por defecto, con Fable 5.1 como nivel superior vía /model fable) lidera la mayoría de los benchmarks de programación agéntica publicados hasta agosto de 2026 y sostiene mucho más contexto, así que encaja con el trabajo grande y multiarchivo. Codex (GPT 6.1 Sol por defecto) es más rápido y, en las pruebas de tarea idéntica, usó entre tres y cuatro veces menos tokens, lo que lo hace más eficiente en coste para el día a día. Muchos equipos usan los dos.
¿Cuál usa menos tokens, Claude Code o Codex?
Codex. Las pruebas independientes en tareas idénticas encontraron que Claude Code gasta aproximadamente entre 3,2 y 4,2 veces más tokens que Codex. El uso mayor de Claude refleja una salida más minuciosa y determinista, pero cuesta más por tarea en facturación por token.
¿Qué ventana de contexto tiene cada uno?
Claude Code ejecuta por defecto Opus 5.5 con una ventana de contexto de un millón de tokens. Codex ejecuta por defecto GPT 6.1 Sol, y el catálogo de su CLI le da 272.000 tokens de serie, con un máximo de 872.000. Para repositorios grandes, la ventana de Claude Code sigue siendo una ventaja clara.
¿Cuánto cuestan Claude Code y Codex?
Codex entra en los planes gratuitos de ChatGPT; Claude Code empieza en Claude Pro, a 18 € al mes sin IVA o 15 € con pago anual, y Max arranca en 90 € sin IVA. ChatGPT va de 22,99 a 509,99 €. En la API, Claude Opus 5.5 cuesta 3,49 € de entrada y 17,45 € de salida por millón y Claude Fable 5.1, 8,72 y 43,62 €; GPT 6 Sol y GPT 6.1 Sol, 1,74 € y 8,72 €. Codex suele salir más barato por tarea.
¿Cuál es mejor para bases de código grandes?
Claude Code, normalmente. Su contexto de un millón de tokens y su SWE-bench Pro, el mejor medido en mayo de 2026, favorecen los cambios multiarchivo a lo ancho del repositorio. La ventana de 272K de Codex puede obligar a re-alimentar contexto en un monorepo grande.
¿De verdad el harness del benchmark cambia el resultado?
Sí, y de forma apreciable. En Terminal-Bench 2.1, GPT 5.5 saca un 78,2% en el harness público neutral pero un 83,4% en la propia Codex CLI de OpenAI. Opus 4.8 se mueve de forma parecida entre harnesses. Comprueba siempre qué harness usa una puntuación antes de comparar.
¿Puedo usar Claude Code y Codex a la vez?
Sí, y muchos equipos con experiencia lo hacen. Un patrón común es Claude Code para la planificación y la arquitectura y Codex para la implementación rápida y acotada. Enrutar cada tarea al agente que mejor le va suele ganar a casarse con uno.
¿Puede una empresa mantener los datos en la UE?
Sí, y por dos caminos. Los modelos de Claude, como Opus 5.5 y Fable 5.1, están en Amazon Bedrock y Google Cloud, que tienen regiones europeas, lo que ayuda a los equipos con necesidades de RGPD o de residencia contractual del dato. Del lado de OpenAI, la API tiene residencia europea propia, eu.api.openai.com, con un recargo del 10%. Confirma tu configuración concreta, porque los detalles varían por proveedor y por región.
¿El plan de entrada llega para programar?
Para uso diario ligero de una o dos sesiones concentradas, normalmente sí en cualquiera de los dos planes de entrada. La programación agéntica de jornada completa suele necesitar Max 5x o Pro 100, y el trabajo de día entero, Max 20x o Pro 200. Los agentes en paralelo y los dynamic workflows consumen cuota mucho más rápido.
Última actualización: 19 de octubre de 2026, con los modelos por defecto vigentes de cada agente, Claude Opus 5.5 y GPT 6.1 Sol. Cifras verificadas contra la documentación de los proveedores, las system cards y los rankings independientes al momento de escribir. Las puntuaciones se mueven con cada harness y versión de modelo nuevos.
• Anthropic: Claude Opus 4.8 · System Card de Opus 4.8, tablas 8.1.A / 8.9.A (SWE-bench Pro 69,2/58,6; HLE con herramientas 57,9/52,2; GraphWalks)
• Ranking Terminal-Bench (tbench.ai): Codex CLI 83,4 / Claude Code 78,9 / Terminus-2 78,2 y 74,6
• Artificial Analysis, ficha de Claude Opus 4.8: Terminal Bench Hard 58,3 frente a 60,6 de GPT 5.5, las mismas cifras leídas el 23 de septiembre de 2026.
• Fuente: Artificial Analysis (artificialanalysis.ai): Intelligence Index v4.3 leído el 23 de septiembre de 2026, a esfuerzo máximo: 57,6 (Claude Opus 5.5), 50,8 (Claude Opus 5), 47,5 (GPT 6 Sol) y 47,0 (GPT 5.6 Sol); coste por tarea de 5,22 €, 3,56 €, 2,30 €, 1,73 €, 0,92 € y 0,06 € para Opus 5.5, Opus 4.8, GPT 5.5, GPT 5.6 Sol, GPT 6 Sol y GPT 6 Luna. Claude Sonnet 5.5, leído el 28 de septiembre: 6,63 € por tarea a esfuerzo máximo y 0,94 € a esfuerzo alto. GPT 6.1 Sol, leído el 29: 51,83 y 0,63 € a esfuerzo máximo. Claude Sonnet 5.5, leído el 18 de octubre: 4,76 € por tarea a esfuerzo máximo y 0,77 € a esfuerzo alto. Basado en datos de Artificial Analysis, leídos el 23, el 28 y el 29 de septiembre y el 18 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
• Anthropic, system card de Claude Opus 5.5: SWE bench Pro 89,9% y Humanity’s Last Exam con herramientas 67,7% (tabla 8.1.A, esfuerzo máximo, media de cinco intentos).
• Claude Code, configuración de modelos: Opus 5.5 por defecto en Pro, Max, Team, Enterprise y la API desde la versión 2.1.280, que el 28 de septiembre y el 19 de octubre de 2026 sigue igual, también en Amazon Bedrock y Google Cloud; el alias sonnet apunta a Claude Sonnet 5.5 desde la versión 2.1.284 y el alias haiku a Claude Haiku 5.5 desde la 2.1.293, con su ventana nativa de un millón de tokens.
• Anthropic, anuncio de Claude Sonnet 5.5: tarifa de 2 y 10 dólares por millón, CursorBench 4.0 55,5% frente al 57,8% de Opus 5.5 y Humanity’s Last Exam con herramientas 64,5%. 28 de septiembre de 2026.
• Precios de la API de OpenAI: GPT 6 Sol a 2 y 10 dólares por millón de tokens, GPT 6 Luna a 0,10 y 0,50, GPT 6 Astra a 10 y 50 y GPT 5.5 a 5 y 30, leídos el 23 de septiembre de 2026, al tipo del BCE del 22 de septiembre, 1 euro por 1,1463 dólares.
• Precios y modelos de OpenAI Codex: modelo por defecto, planes, ventana de la CLI y límites por plan (los Pro sin ventana de cinco horas), leídos el 19 de octubre de 2026
• Registro de cambios de Codex: GPT 6.1 Sol como modelo por defecto desde la CLI 0.159.1 (29 de septiembre de 2026), Ultrafast con GPT 6.1 Sol desde el 8 de octubre y la retirada de GPT 5.5 en Codex con cuenta de ChatGPT el 14 de octubre. Leído el 19 de octubre de 2026.
• Catálogo de modelos de la CLI de Codex (GitHub): GPT 6.1 Sol en primer lugar, con razonamiento bajo de serie, 272.000 tokens de contexto y un máximo de 872.000. Leído el 19 de octubre de 2026.
• OpenAI, controles de datos de la API: residencia europea en eu.api.openai.com para GPT 6.1 Sol, GPT 6 Sol, GPT 6 Astra y GPT 6 Luna, con un recargo del 10% y retención modificada. Leído el 19 de octubre de 2026.
• OpenAI, anuncio de GPT 6.1 Sol: disponible en ChatGPT Work y Codex para Plus, Pro, Business, Enterprise y Edu, tarifa de 2 y 10 dólares por millón y cifras del fabricante en DeepSWE v1.1. 29 de septiembre de 2026.
• Issues de openai/codex (GitHub): ventana efectiva en sesión ≈258K reportada por desarrolladores
• Morph LLM: uso de tokens en tarea idéntica (3,2x-4,2x)
• Precios de Anthropic · Análisis práctico de Developers Digest · Documentación de Dynamic Workflows de Claude Code