Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre de 2026 y lo presenta como el complemento más rápido y más barato de Opus 5.5. Sobre el papel, lo es: cobra justo la mitad por token de entrada y de salida. La tentación es pasarlo todo al barato. Si lo planteas como Sonnet 5.5 vs Opus 5.5, la cuenta sale bien en unos esfuerzos y mal en otros.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y la cuenta fácil no me convence. Un modelo que cobra la mitad por token puede gastar muchos más tokens para terminar el mismo encargo. Con los datos de Artificial Analysis, Sonnet 5.5 a esfuerzo máximo empata con Opus 5.5 a muy alto, y su tarea cuesta 2,2 veces más.
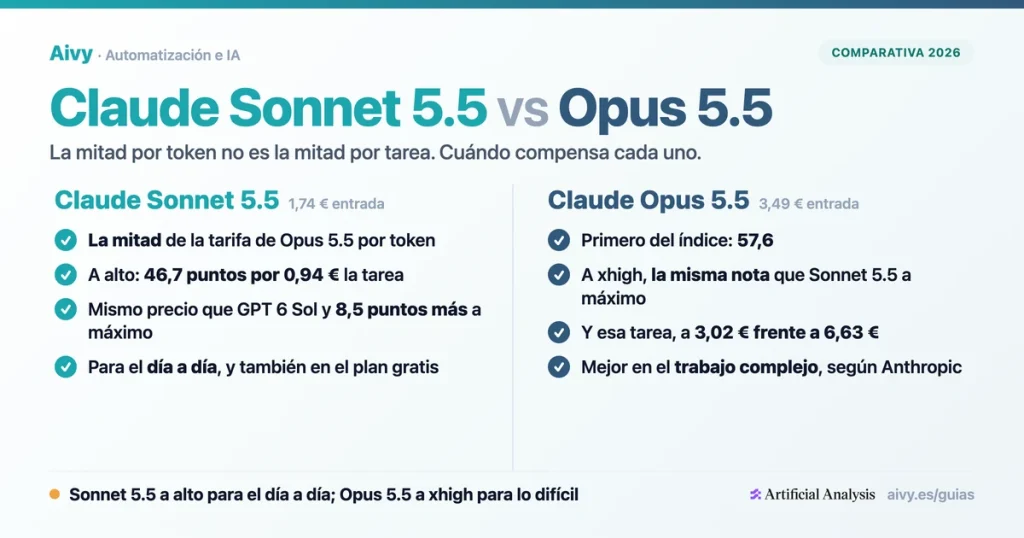
Esta guía pone el dinero delante: tarifa y coste por tarea en euros, esfuerzo por esfuerzo, y separa lo que afirma Anthropic de lo que mide un tercero. Compara también Sonnet 5.5 con GPT 6 Sol, que cobra lo mismo por token. Mi resumen cabe en una línea: Sonnet 5.5 a alto para el día a día y Opus 5.5 a muy alto para lo más difícil.
Qué trae Claude Sonnet 5.5 frente a Sonnet 5
Claude Sonnet 5.5 es el segundo modelo de la familia Claude 5.5 y llega seis días después de Opus 5.5. Según Anthropic, donde más destaca es en las tareas del día a día bien acotadas, en arreglar fallos y en preparar documentos, diapositivas y hojas de cálculo con buen acabado, y tiene buen ojo para el diseño. Opus 5.5, dice, está hecho para el trabajo complejo que pide juicio cuidadoso. El tercero, Claude Haiku 5.5, llegó el 7 de octubre de 2026.
Frente a su predecesor, Sonnet 5, la tarifa no se mueve. Anthropic asegura que genera la salida más rápido y que, en la mayor parte del trabajo, cuesta hasta un 30% menos por tarea, porque suele necesitar muchos menos tokens para lo mismo. Es la primera pista de esta guía: el ahorro llega por gastar menos, no por cobrar menos.
Los testimonios que publica Anthropic apuntan al mismo sitio. Según Balyasny, en 2.441 tareas de finanzas Sonnet 5.5 gastó unos 121.000 tokens por respuesta, frente a 497.000 de Sonnet 5. Slack habla de un 14% menos de tokens de salida, y Box, de un 12% menos de tokens en total que el modelo anterior. Son cifras de empresas que cita el fabricante, no mediciones independientes.
En la ficha, Sonnet 5.5 y Opus 5.5 comparten casi todo: un millón de tokens de contexto, 128.000 de salida máxima y el conocimiento cortado en junio de 2026. Se separan en el precio, en la latencia según la etiqueta de Anthropic, en el pensamiento (en Opus 5.5 no se apaga) y en el esfuerzo con el que arrancan en la API: alto en Sonnet 5.5, medio en Opus 5.5. Ese último detalle pesa más de lo que parece.
| Ficha | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| Lanzamiento | 28 de septiembre de 2026 | 22 de septiembre de 2026 |
| Retirada | no antes del 28 de septiembre de 2027 | no antes del 22 de septiembre de 2027 |
| Entrada y salida, por millón | 1,74 € y 8,72 € | 3,49 € y 17,45 € |
| Lectura de caché, por millón | 0,09 € | 0,17 € |
| Escritura de caché (5 minutos y 1 hora) | 2,18 € y 3,49 € | 4,36 € y 6,98 € |
| Por lotes | la mitad en entrada y salida | la mitad en entrada y salida |
| Contexto | 1.000.000 de tokens | 1.000.000 de tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Corte de conocimiento | junio de 2026 | junio de 2026 |
| Esfuerzo por defecto en la API | alto | medio |
| Latencia, en palabras de Anthropic | rápida | moderada |
| Para qué, según Anthropic | tareas del día a día bien acotadas, arreglar fallos, documentos, diapositivas y hojas de cálculo | trabajo complejo que pide juicio cuidadoso |
Fichas de Claude Sonnet 5.5 y Claude Opus 5.5, página de precios, notas de versión y anuncio de Anthropic, leídos el 28 de septiembre de 2026. Importes en euros convertidos al tipo del BCE del 22 de septiembre de 2026. La latencia es una etiqueta del fabricante, no una medida.
Hay una novedad menos vistosa. Sonnet 5.5 es el primer Sonnet que sale con salvaguardas de ciberseguridad como las de los modelos más capaces, porque según Anthropic sus capacidades en ese terreno son comparables a las de Opus 5. Las peticiones de ciberseguridad de más riesgo pasan a Sonnet 5, y también es el primer Sonnet con clasificadores contra la extracción de su razonamiento.
Precio en euros: la mitad por token
Anthropic publica y cobra en dólares, así que lo que pagas en euros baila con el cambio. Al tipo del BCE del 22 de septiembre de 2026, Sonnet 5.5 cuesta 1,74 € por millón de tokens de entrada y 8,72 € por millón de salida, lo mismo que Sonnet 5. Opus 5.5 cobra justo el doble en dólares: 3,49 € y 17,45 €. GPT 6 Sol y GPT 6.1 Sol, de OpenAI, cobran lo mismo que Sonnet 5.5 hasta los 272.000 tokens de entrada.
Sonnet 5.5 cuesta la mitad por token que Opus 5.5, y lo mismo que GPT 6.1 Sol
Euros por millón de tokens. Más bajo es más barato. Las seis barras a escala de la mayor, 17,45 €. Fuente: páginas de precios de Anthropic (leída el 28 de septiembre de 2026) y de OpenAI (ficha de GPT 6.1 Sol, leída el 29 de septiembre de 2026). Las dos publican y cobran en dólares; euros convertidos al tipo del BCE del 22 de septiembre de 2026.
Entrada, por millón de tokens
Salida, por millón de tokens
Leer de caché cuesta 0,09 € por millón en Sonnet 5.5 desde el 7 de octubre de 2026, 0,17 € en Opus 5.5 y 0,09 € en GPT 6.1 Sol. Por encima de 272.000 tokens de entrada, GPT 6.1 Sol cobra el doble en entrada y caché y 1,5 veces en salida; Anthropic no cobra recargo por contexto largo.
La letra pequeña está en la caché, que guarda lo que ya has enviado para no procesarlo entero en la siguiente petición. Escribir en ella cuesta con Sonnet 5.5 la mitad que con Opus 5.5: 2,18 € frente a 4,36 € por millón, en la de cinco minutos. Leer de ella también cuesta la mitad desde el 7 de octubre de 2026: 0,09 € frente a 0,17 €. Si tu asistente relee una y otra vez el mismo contrato, esa parte de la factura baja al pasar a Sonnet.
Hay otro mando que abarata, y mucho. La API de lotes, para trabajos que pueden esperar, descuenta un 50% en la entrada y la salida, y con Sonnet 5.5 deja subir la salida máxima a 300.000 tokens, en beta. Para una asesoría o gestoría que clasifica facturas o resume expedientes de noche, es el primer descuento que yo miraría. Y no hay recargo por contexto largo en ninguno de los dos.
Por qué la tarifa no es tu factura
Un token es un trozo de texto, y la API te cobra dos montones: los que envías (tu pregunta, el documento, el historial) y los que el modelo escribe, razonamiento incluido. La tarifa dice cuánto vale cada token. La factura es la tarifa multiplicada por cuántos tokens ha necesitado el modelo para terminar, y ese segundo número no lo fija Anthropic: lo decide el modelo sobre la marcha.
Piénsalo como dos fontaneros. Uno cobra la mitad por hora que el otro, pero si tarda mucho más en cerrar la misma avería, acaba saliendo más caro. Con los modelos pasa lo mismo, con un matiz: el mismo modelo gasta muchos o pocos tokens según cuánto le pidas que piense. Ese mando es el esfuerzo, con cinco niveles: bajo, medio, alto, muy alto (xhigh) y máximo.
Artificial Analysis, un evaluador independiente, ejecuta su índice de inteligencia v4.3 con cada modelo y cada esfuerzo, y publica la nota y lo que costó cada tarea a precio de tarifa. Tus tareas no son las suyas, así que no es tu factura; sirve para comparar a los dos con las mismas reglas. Con Sonnet 5.5, la tarea va de 0,36 € a bajo a 6,63 € a máximo.
Nivel a nivel, Sonnet 5.5 sale más barato por tarea salvo a máximo
Coste por tarea del índice de inteligencia v4.3 de Artificial Analysis, en euros, por nivel de esfuerzo. Más bajo es más barato. Barras a escala de la mayor, 6,63 €. Fuente: Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de septiembre de 2026. AA lo publica en dólares; euros convertidos al tipo del BCE del 22 de septiembre de 2026.
Esfuerzo bajo
Esfuerzo medio
Esfuerzo alto
Esfuerzo muy alto (xhigh)
Esfuerzo máximo
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Nivel contra nivel, Sonnet 5.5 cuesta menos por tarea en bajo, medio, alto y muy alto. Pero comparar el mismo nivel engaña, porque no sacan la misma nota: Opus 5.5 rinde más en cada escalón. La pregunta útil no es cuál cuesta menos a igual esfuerzo, sino cuál llega a la nota que necesitas por menos dinero. Para ver qué supone en tu volumen, tienes la calculadora de ROI.
Opus 5.5 saca más nota que Sonnet 5.5 en cada nivel de esfuerzo
Índice de inteligencia v4.3 de Artificial Analysis por nivel de esfuerzo. Más alto es mejor. Barras a escala de la mayor, 57,6. Fuente: Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de septiembre de 2026.
Esfuerzo bajo
Esfuerzo medio
Esfuerzo alto
Esfuerzo muy alto (xhigh)
Esfuerzo máximo
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Frente a Opus 5.5, donde Sonnet 5.5 no tiene rival es en alto. Marca 46,74 por 0,94 € la tarea, y ningún ajuste de Opus 5.5 da esa nota por menos dinero. Opus 5.5 a medio, su ajuste de fábrica en la API, saca 51,24 por 1,17 €: 4,5 puntos más por cerca de un 24% más de coste por tarea. El otro escalón donde gana es bajo, con 35,84 por 0,36 €, lo más barato de los dos modelos.
La trampa está en medio, el esfuerzo con el que Sonnet 5.5 arranca en las apps de Claude y en Claude Code. Ahí marca 40,74 por 0,51 € la tarea, mientras Opus 5.5 a bajo saca 42,31 por 0,48 €: más nota por menos dinero. Y se repite en muy alto: Sonnet 5.5 da 51,85 por 2,39 €, y Opus 5.5 a alto, 53,58 por 1,59 €.
A máximo, más del doble por empatar
Si solo te quedas con un dato, que sea este. Sonnet 5.5 a máximo saca 55,98 en el índice de Artificial Analysis, el tercero del tablero. Opus 5.5 a muy alto saca 55,99: un empate. Pero la tarea de Sonnet 5.5 cuesta 6,63 € y la de Opus 5.5, 3,02 €. Pagas 2,2 veces más por la misma nota o, mirado al revés, Opus 5.5 sale un 54,5% más barato.
A la misma nota, Sonnet 5.5 a máximo cuesta más del doble por tarea
Coste por tarea del índice de inteligencia v4.3 de Artificial Analysis, en euros; la nota del índice va en la etiqueta. Más bajo es más barato. Barras a escala de la mayor, 6,63 €. Fuente: Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de septiembre de 2026; euros convertidos al tipo del BCE del 22 de septiembre de 2026.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Y Opus 5.5 a máximo, el número uno del tablero con 57,6, cuesta 5,22 € la tarea: más nota que Sonnet 5.5 a máximo y menos dinero. Con la mitad de tarifa por token, eso solo cuadra de una manera: para acercarse a Opus 5.5, Sonnet 5.5 gasta más tokens. La escalera de Opus 5.5 ya la desmenuzamos en su duelo con Fable 5.1.
Anthropic reconoce otra pega de Sonnet 5.5 a máximo en una nota al pie de su tabla, aunque habla de otra prueba, no del índice de Artificial Analysis. En FrontierCode, a máximo, Sonnet 5.5 lanzaba más a menudo la skill de revisión de código de Claude Code, que reparte la revisión entre muchos subagentes. En dos casos que examinó Cognition, eso acabó en tiempo agotado o en cambios fuera del encargo. Resultado: un 46,2% a máximo frente a un 52,1% a muy alto.
Aquí Anthropic y Artificial Analysis no cuentan lo mismo. El fabricante escribe que, en los ajustes altos, Sonnet 5.5 puede rendir como Opus 5.5 a un coste parecido. En el índice independiente, a igual nota, la tarea de Sonnet 5.5 cuesta más del doble. No es que uno mienta: miden tareas distintas. Pero yo no usaría la palabra parecido, y lo comprobaría con tareas propias.
Qué dice cada benchmark y quién lo firma
En su anuncio, Anthropic publica una tabla propia con cuatro modelos. Lo primero que salta a la vista es la distancia con Sonnet 5: en Terminal Bench 4.0, de programación agéntica, pasa de un 10,3% a un 70,6%. En GDPval AA, trabajo real de 44 ocupaciones en nueve grandes sectores, queda unos 400 puntos por encima de Sonnet 5 y casi a la par de Opus 5.5: 1.844 frente a 1.846.
| Prueba | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT 6 Sol |
|---|---|---|---|---|
| Terminal Bench 4.0 (programación agéntica) | 70,6% | 10,3% | 66,4% (a muy alto) | sin dato |
| FrontierCode 1.1, conjunto principal | 46,2% a máximo; 52,1% a muy alto | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | sin dato |
| GDPval AA v2.1 (Elo) | 1.844 | 1.449 | 1.846 | 1.487 |
| AA Briefcase v1.1 (Elo) | 1.811 | 1.359 | 1.822 | 1.483 |
| Humanity’s Last Exam, con herramientas | 64,5% | 54,9% | 67,7% | sin dato |
| OSWorld 2.1 (uso del ordenador, puntuación parcial) | 80,1% | 57,0% | 81,8% | sin dato |
| Chartography (gráficos, sin herramientas) | 61,6% | 15,6% | 64,4% | 53,6% |
Cifras publicadas por Anthropic en el anuncio de Claude Sonnet 5.5, 28 de septiembre de 2026; el esfuerzo solo se indica donde Anthropic lo indica. Sin dato: Anthropic no lo publica. GDPval AA y AA Briefcase las ejecutó Artificial Analysis y las publica Anthropic: no son lecturas nuestras de su tablero. Artificial Analysis no avala este análisis ni es responsable de él.
Frente a Opus 5.5, la tabla es apretada. Sonnet 5.5 gana solo en Terminal Bench 4.0, con un 70,6% contra el 66,4% que Opus 5.5 saca en su mejor ajuste. Pierde por poco en el resto: en CursorBench se queda a unos dos puntos, en OSWorld, de uso del ordenador, marca un 80,1% frente a un 81,8%, y en FrontierCode su mejor nota, un 52,1%, no llega al 54,4% de Opus 5.5.
Contra Sonnet 5, el salto se ve también desde fuera. En el índice de Artificial Analysis, a máximo, Sonnet 5.5 marca 17,8 puntos más por 1,49 veces el coste por tarea, sin desmentir el hasta un 30% menos de Anthropic, que mide su trabajo típico. Su otra afirmación, superar en varias pruebas la mejor nota de Sonnet 5 por una décima parte del coste, en el índice casi se cumple a medio: 40,74 por 0,51 €, algo menos de la novena parte de 4,44 €.
Para programar falta una pieza: el índice de programación de Artificial Analysis aún no tiene nota de Sonnet 5.5 ni de Opus 5.5, así que solo hay cifras del fabricante. Dan ventaja a Opus 5.5 en FrontierCode y CursorBench, y a Sonnet 5.5 en Terminal Bench 4.0. Con eso no declaro ganador: probaría los dos con código propio, y si aún dudas de herramienta, mira Claude Code frente a Codex.
Sonnet 5.5 frente a GPT 6 Sol: mismo precio, otra nota
Dentro de la gama GPT 6, Sol es el rival natural de Sonnet 5.5, porque cobra lo mismo por token. En la tabla de Anthropic, Sonnet 5.5 le gana con holgura en GDPval AA, AA Briefcase y Chartography. El fabricante avisa de que OpenAI corrigió un fallo de Sol con imágenes y esas notas pueden no estar al día, aunque la misma nota no espera grandes cambios. En FrontierCode depende del esfuerzo: a muy alto, 52,1% frente a 49,3%; a máximo, Sol queda por delante.
| Modelo | Entrada y salida, por millón | Índice de AA a máximo | Coste por tarea a máximo |
|---|---|---|---|
| Claude Sonnet 5.5 | 1,74 € y 8,72 € | 56,0 | 6,63 € |
| Claude Opus 5.5 | 3,49 € y 17,45 € | 57,6 | 5,22 € |
| GPT 6 Sol | 1,74 € y 8,72 € | 47,5 | 0,92 € |
| GPT 6.1 Sol | 1,74 € y 8,72 € | 51,8 | 0,63 € |
| Claude Sonnet 5 | 1,74 € y 8,72 € | 38,2 | 4,44 € |
Tarifas de Anthropic y OpenAI, convertidas al tipo del BCE del 22 de septiembre de 2026. Índice y coste por tarea: Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de septiembre de 2026 (GPT 6.1 Sol, el 29), cada modelo a su esfuerzo máximo. Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
En el índice independiente, a máximo, Sonnet 5.5 saca 8,45 puntos más que GPT 6 Sol, 55,98 frente a 47,53, pero su tarea cuesta 7,2 veces más: 6,63 € frente a 0,92 €. Mismo precio por token, factura muy distinta. En cambio, Sonnet 5.5 a alto, con 46,74 por 0,94 €, queda casi a la par de Sol a máximo, que marca 47,53 por 0,92 €.
O sea: a máximo, Sonnet 5.5 da más nota, pero compra cada punto muy caro. Y si te basta el nivel de Sol, Sonnet 5.5 a alto se queda un pelo por debajo por casi lo mismo. Con textos largos la tarifa se separa: por encima de 272.000 tokens de entrada, Sol cobra el doble en entrada y caché y 1,5 veces en salida. Si tu duda es de app y no de API, mira Claude frente a ChatGPT.
Desde el 29 de septiembre, el rival de OpenAI al mismo precio es GPT 6.1 Sol, la versión mejorada de Sol. En Artificial Analysis, a muy alto casi empata con Sonnet 5.5, 51,04 frente a 51,85, y su tarea cuesta 0,34 € frente a 2,39 €. A alto marca 50,24 por 0,28 €, y Sonnet 5.5, 46,74 por 0,94 €. A máximo, Sonnet 5.5 saca más nota, 55,98 frente a 51,83, pero a 6,63 € la tarea frente a 0,63 €.
Qué modelo y qué esfuerzo para cada trabajo
La recomendación de Anthropic viene con una reserva a favor de Opus. Según el anuncio, Sonnet 5.5 complementa mejor a Opus 5.5 a esfuerzos bajos, donde cuesta menos por tarea. Y en sus pruebas y en las de probadores externos, Opus 5.5 sigue siendo claramente más fuerte en el trabajo complejo y abierto que pide juicio sostenido. Que lo diga el día que lanza Sonnet 5.5 le da más peso, no menos.
Con eso y con los datos de arriba, yo ordenaría la decisión como una escalera. Empiezas por lo barato y subes solo cuando tus pruebas demuestran que el escalón de abajo se queda corto. La tabla pone a cada peldaño su nota y su coste por tarea en Artificial Analysis; la columna del tipo de trabajo es criterio mío, no del fabricante ni del evaluador.
| Tipo de trabajo | Por dónde empezaría | Índice de AA · coste por tarea |
|---|---|---|
| Mucho volumen y poca dificultad: clasificar, extraer, resumir | Sonnet 5.5 a bajo | 35,8 · 0,36 € |
| Si Sonnet 5.5 a bajo se queda corto | Opus 5.5 a bajo | 42,3 · 0,48 € |
| Tareas acotadas del día a día: correos, informes, fallos sencillos | Sonnet 5.5 a alto | 46,7 · 0,94 € |
| Trabajo serio con criterio: análisis, código de varios ficheros | Opus 5.5 a medio o alto | 51,2 · 1,17 € y 53,6 · 1,59 € |
| Lo más difícil: agentes largos, decisiones caras | Opus 5.5 a muy alto (xhigh) | 56,0 · 3,02 € |
| Lo que no recomiendo | Sonnet 5.5 a máximo | 56,0 · 6,63 € |
Recomendación de Aivy. Cifras: índice de inteligencia v4.3 y coste por tarea de Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de septiembre de 2026; euros convertidos al tipo del BCE del 22 de septiembre de 2026. Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Abajo, Sonnet 5.5 a bajo para trabajo repetitivo con una respuesta fácil de comprobar, como clasificar correos o extraer campos de albaranes. Es el terreno de la automatización documental: si una regla valida el resultado, pagar más nota no sale a cuenta. Si falla, Opus 5.5 a bajo cuesta un tercio más, 0,48 € la tarea, y puntúa más.
Desde el 7 de octubre de 2026 hay además un escalón por debajo: Claude Haiku 5.5, a 0,09 € de entrada y 0,44 € de salida por millón con prompts de hasta 100.000 tokens. En el índice de Artificial Analysis saca 43,4 a máximo, más que Sonnet 5.5 a medio, aunque su coste por tarea aún no lo ha medido. Para clasificar y extraer a volumen, es el primero que probaría yo.
El peldaño del día a día es Sonnet 5.5 a alto. Encaja con lo que Anthropic le atribuye: tareas acotadas, fallos, documentos y hojas de cálculo. En la API ya arranca ahí. En las apps y en Claude Code arranca en medio, justo el escalón donde Opus 5.5 a bajo le gana, así que súbelo a mano: en la app, desde el menú de modelo junto al botón de enviar; en Claude Code, con /effort. Lo de alto es criterio mío, por el índice, no de Anthropic.
Si alto se queda corto, no subiría Sonnet 5.5 a muy alto, porque Opus 5.5 a alto le gana en nota y cuesta menos por tarea. Cambiaría de modelo: Opus 5.5 a medio o alto para lo que ya no está tan acotado, como un informe que cruza varias fuentes o un cambio de código que toca varios módulos. El resto de la gama lo repasa nuestra guía de qué modelo de Claude usar.
Arriba, Opus 5.5 a muy alto para lo más difícil, 55,99 por 3,02 € la tarea, y a máximo solo cuando un punto más de nota se traduce en dinero o en riesgo. En OpenAI, GPT 6 Astra a máximo marca 52,67 por 2,84 €, por debajo de Opus 5.5 a muy alto. Y Sonnet 5.5 a máximo no lo pondría nunca: si alguien lo tiene puesto por si acaso, es el primer ajuste que revisaría.
Qué significa para las empresas españolas
Empiezo por el plan. Según la página de Sonnet de Anthropic, cualquiera puede usar Sonnet 5.5 en Claude.ai, en la web, en iOS y en Android, y la página de planes incluye Sonnet también en el gratuito. Opus 5.5 pide un plan de pago, y Claude Pro cuesta 22 € al mes con IVA. Lo que Anthropic no dice es si Sonnet 5.5 pasa a ser el modelo por defecto de la app: míralo en la tuya.
Si tratas datos personales, dónde se procesan importa de cara al RGPD, y la respuesta de la API directa de Anthropic es incómoda. Solo admite inferencia global, la de serie, o en Estados Unidos, que cuesta 1,1 veces la tarifa. Solo en Europa, hoy, no hay opción, ni para Sonnet 5.5 ni para Opus 5.5. Y el espacio de trabajo, donde se guardan los datos, solo puede estar en Estados Unidos.
La alternativa es pasar por un gran proveedor de nube. Sonnet 5.5 está en AWS, Google Cloud y Microsoft Azure, y en Bedrock y Google Cloud los puntos de acceso regionales cuestan un 10% más que los globales. Qué regiones europeas sirven ya Sonnet 5.5 en cada una no lo dicen las fuentes de esta guía. Míralo en la consola de cada nube antes de firmar nada, sin darlo por supuesto.
La retención es otra cosa. Sonnet 5.5 está disponible con retención cero de datos, igual que Opus 5.5 y Sonnet 5, pero que el proveedor no guarde lo que le mandas no dice nada de dónde lo procesa. Son dos compromisos distintos, y conviene no mezclarlos en un contrato ni en un registro de actividades. Lo básico del RGPD y el AI Act lo tienes en nuestra guía de cumplimiento.
Un último aviso para la app. Sus clasificadores de seguridad miran también la memoria, los conectores, los resultados de búsqueda y los ficheros. Si uno se activa por ciberseguridad ofensiva, la petición se repite en Sonnet 5 dentro de la misma conversación, con aviso; las de biología y las que intentan extraer su razonamiento se bloquean. Conviene saber que una respuesta puede venir de otro modelo.
Pasar de Sonnet 5 sin romper nada
Si tienes código escrito para Sonnet 5, cambiar el nombre del modelo en la llamada no basta. Según las notas de versión de la API, hay cinco maneras de que se rompa. La primera: para apagar el pensamiento previo ya no se manda disabled, sino between_tools, que solo funciona a esfuerzo alto o menos. La segunda: forzar el uso de herramientas, con tool_choice en any o tool, devuelve un error 400.
La tercera: los bloques de pensamiento van atados al modelo y a la conversación, y solo sirven en la cuenta que los generó o en una vinculada. La cuarta: en la API de Claude y en Google Cloud ya no se acepta la herramienta antigua de uso del ordenador, computer_20251124. La quinta: la herramienta advisor rechaza como asesores a Opus 4.8, Opus 4.7 y Sonnet 5. Aparte, temperature, top_p o top_k fuera de su valor predeterminado también dan error 400.
En Claude Code, Sonnet 5.5 no es el modelo por defecto en ningún plan: Claude Code arranca con Opus 5.5 en Pro, Max, Team, Enterprise y la API de Anthropic. Sonnet 5.5 se elige con /model sonnet y pide la versión 2.1.284 o posterior. El modo opusplan usa Opus para planificar y Sonnet para ejecutar: reparte el trabajo entre los dos modelos dentro de una misma sesión.
Y una trampa para quien trabaja a través de una nube: el alias sonnet solo apunta a Sonnet 5.5 en la API de Anthropic. En Claude Platform on AWS apunta a Sonnet 4.6, y en Amazon Bedrock, Google Cloud y Microsoft Foundry, a Sonnet 4.5. Si quieres el nuevo, fija la versión a mano; si no, harás tus pruebas con un Sonnet anterior sin saberlo.
Echa las cuentas por tarea, no por token
Sería cómodo resumir Sonnet 5.5 como un Opus a mitad de precio, y los datos no lo permiten. Cobra la mitad por token, pero lo que pagas depende de cuántos tokens gasta, y eso lo decide sobre todo el esfuerzo. A bajo y a alto es la mejor compra de los dos. A medio, muy alto y máximo, siempre hay un ajuste de Opus 5.5 que da más nota por menos dinero.
Mi reparto para una pyme sería sencillo. Sonnet 5.5 a alto para el trabajo de cada día, fijado a mano allí donde arranque en medio, y a bajo para el volumen fácil de comprobar. Opus 5.5 para lo que pide juicio, a muy alto si es lo más difícil. Y entre los dos, una muestra de tareas reales de tu equipo para ver dónde cae el corte, que es por donde empieza cualquier consultoría de IA.
Estas notas y estos costes son del día del lanzamiento, salen de pruebas ajenas y los euros se moverán con el dólar. El tablero de Artificial Analysis cambia a menudo y desde el 7 de octubre la gama tiene también Haiku 5.5, así que vuelve a echar números antes de tocar producción. Si quieres repartir tus cargas entre los dos modelos con tus propios datos, reserva una llamada y lo vemos.
Sonnet 5.5 vs Opus 5.5: preguntas frecuentes
¿Cuánto cuesta Claude Sonnet 5.5 en euros?
Al tipo del BCE del 22 de septiembre de 2026, Sonnet 5.5 cuesta 1,74 € por millón de tokens de entrada y 8,72 € por millón de salida, lo mismo que Sonnet 5. Es la mitad que Opus 5.5, que cobra 3,49 € y 17,45 €. La API de lotes descuenta un 50%. Anthropic cobra en dólares, así que el importe en euros se mueve con el cambio.
¿Cuál gasta menos por tarea, Sonnet 5.5 u Opus 5.5?
Depende del esfuerzo. Con datos de Artificial Analysis y frente a Opus 5.5, Sonnet 5.5 gana a bajo, con 0,36 € la tarea, y a alto, con 46,74 puntos por 0,94 €. A medio, muy alto y máximo siempre hay un ajuste de Opus 5.5 con más nota por menos dinero. A máximo, Sonnet 5.5 cuesta 6,63 € la tarea; Opus 5.5 a muy alto, con igual nota, 3,02 €.
¿Cuál es mejor para programar?
No hay veredicto independiente: el índice de programación de Artificial Analysis aún no ha medido a ninguno de los dos. En la tabla de Anthropic, Sonnet 5.5 gana en Terminal Bench 4.0, con un 70,6% frente a un 66,4%, y Opus 5.5 va delante en FrontierCode y CursorBench. Son cifras del fabricante: yo probaría los dos con código propio antes de decidir.
¿Sonnet 5.5 está en mi plan de Claude, también en el gratuito?
Sí. Según la página de Sonnet de Anthropic, cualquiera puede usar Sonnet 5.5 en Claude.ai, y la página de planes incluye Sonnet también en el gratuito. Opus 5.5 solo está en los planes de pago, y Claude Pro cuesta 22 € al mes con IVA en España. Lo que Anthropic no aclara es si Sonnet 5.5 pasa a ser el modelo por defecto de la app.
¿Sonnet 5.5 sustituye a Opus 5.5?
No. Anthropic lo presenta como un complemento más rápido y más barato, fuerte en tareas acotadas del día a día, fallos, documentos y hojas de cálculo. Para el trabajo complejo y abierto que pide juicio sostenido, dice que Opus 5.5 sigue siendo claramente más fuerte. Y a igual nota en Artificial Analysis, Opus 5.5 a muy alto cuesta menos de la mitad por tarea que Sonnet 5.5 a máximo.
¿Qué modelo usa Claude Code por defecto?
Claude Opus 5.5, en Pro, Max, Team, Enterprise y la API de Anthropic. Sonnet 5.5 no es el predeterminado en ningún plan: se elige con /model sonnet y pide la versión 2.1.284 o posterior. Ojo, porque el alias sonnet solo apunta a Sonnet 5.5 en la API de Anthropic; en Bedrock, Google Cloud o Microsoft Foundry apunta a un Sonnet anterior y hay que fijar la versión a mano.
¿Qué cambia en la API al pasar de Sonnet 5 a Sonnet 5.5?
Cinco cosas pueden romper tu código. El pensamiento previo se apaga con between_tools, no con disabled. Forzar herramientas da error 400. Los bloques de pensamiento van atados al modelo y a la conversación. La herramienta antigua de uso del ordenador ya no vale en la API de Claude ni en Google Cloud. Y advisor rechaza como asesores a Opus 4.8, Opus 4.7 y Sonnet 5.
¿Es mejor Sonnet 5.5 que GPT 6 Sol?
A máximo y en el índice de Artificial Analysis, sí, con la misma tarifa por token: Sonnet 5.5 saca 8,45 puntos más que GPT 6 Sol, pero su tarea cuesta 7,2 veces más, 6,63 € frente a 0,92 €. A alto, Sonnet 5.5 queda casi a la par de Sol a máximo, en nota y en coste. Y por encima de 272.000 tokens de entrada, Sol cobra más. Desde el 29 de septiembre está GPT 6.1 Sol, con la misma tarifa: a muy alto, 51,04 por 0,34 € la tarea.
Última actualización: 7 de octubre de 2026
- Anthropic, anuncio de Claude Sonnet 5.5: posicionamiento frente a Opus 5.5, la mejora de velocidad y el hasta un 30% menos por tarea frente a Sonnet 5, la tabla de pruebas con sus notas al pie, esfuerzos por defecto, salvaguardas, retención cero, disponibilidad y el anuncio de Haiku 5.5. 28 de septiembre de 2026.
- Anthropic, anuncio de Claude Haiku 5.5: lanzamiento, precio con el tramo por encima de 100.000 tokens y la rebaja de la lectura de caché de Sonnet 5.5. 7 de octubre de 2026.
- Anthropic, ficha de Claude Sonnet 5.5: contexto, salida máxima, corte de conocimiento, esfuerzo por defecto, latencia según Anthropic, tarifas completas y fecha de retirada. Leída el 28 de septiembre de 2026.
- Anthropic, ficha de Claude Opus 5.5: lanzamiento, fecha de retirada, esfuerzo por defecto y pensamiento siempre activo. Leída el 28 de septiembre de 2026.
- Anthropic, notas de versión de la Claude Platform: los cinco cambios que pueden romper código escrito para Sonnet 5 y los bloques de pensamiento atados a la cuenta, leídas el 28 de septiembre de 2026; la lectura de caché de Sonnet 5.5 a 0,10 dólares por millón, el 7 de octubre.
- Anthropic, precios de la API: tarifas, lotes, que todos los precios van en dólares, la ausencia de recargo por contexto largo y el 10% de los puntos de acceso regionales de Amazon Bedrock y Google Cloud. Leída el 28 de septiembre de 2026.
- Anthropic, residencia de datos: las opciones de inferencia global y en Estados Unidos, el espacio de trabajo solo en Estados Unidos y el recargo de 1,1 veces. Leída el 28 de septiembre de 2026.
- Anthropic, página de Claude Sonnet: que cualquiera puede usar Sonnet 5.5 en Claude.ai, en web, iOS y Android. Leída el 28 de septiembre de 2026.
- Claude, planes y precios: qué familias de modelos incluye cada plan (Sonnet en Free, Pro y Max; Opus solo en los de pago). Leída el 28 de septiembre de 2026.
- Claude, por qué cambió de modelo tu conversación con Sonnet 5.5: qué peticiones pasan a Sonnet 5 y cuáles se bloquean. Leída el 28 de septiembre de 2026.
- Claude, cambiar el modelo, el esfuerzo y el pensamiento: el menú de modelo junto al botón de enviar, el selector de esfuerzo de Sonnet 5.5 y que su pensamiento no se apaga en la app. Leída el 28 de septiembre de 2026.
- Claude Code, configuración de modelos: el modelo por defecto de cada plan y proveedor, a qué versión apunta el alias sonnet en cada uno, la versión mínima y el modo opusplan. Leída el 28 de septiembre de 2026.
- OpenAI, precios de la API: tarifas de GPT 6 Sol y su recargo por encima de 272.000 tokens de entrada. Leída el 22 de septiembre de 2026.
- OpenAI, anuncio de GPT 6.1 Sol: mejora de GPT 6 Sol con la tarifa de 2 y 10 USD por millón de tokens y la caché a 0,10 USD, 29 de septiembre de 2026. Ficha en la documentación de OpenAI, con el recargo por encima de 272.000 tokens, leída el mismo día.
- Fuente: Artificial Analysis (artificialanalysis.ai): índice de inteligencia v4.3 de Claude Haiku 5.5 a máximo, leído el 7 de octubre de 2026, e índice y coste por tarea por nivel de esfuerzo de Claude Sonnet 5.5, Claude Opus 5.5, GPT 6 Sol, Claude Sonnet 5, Claude Fable 5.1 y GPT 6 Astra, datos leídos el 28 de septiembre de 2026, y GPT 6.1 Sol, leído el 29. Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
- Data API de Artificial Analysis: el índice de programación, sin medir (null) para Claude Sonnet 5.5 ni para Claude Opus 5.5 en ninguno de sus cinco esfuerzos, a 28 de septiembre de 2026.
- Banco Central Europeo, tipo de cambio de referencia: 1 euro = 1,1463 dólares estadounidenses el 22 de septiembre de 2026, usado en todas las conversiones de esta guía.