Claude Opus 5.5 salió el 22 de septiembre de 2026 y GPT 6 Astra lleva en la calle desde el día 3, así que toda comparativa GPT 6 Astra vs Claude Opus 5.5 acaba en la misma duda: cambiar o quedarse. En el índice de Artificial Analysis, lo que más mueve la nota y el coste por tarea no es la marca: es el nivel de esfuerzo.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y me paso más horas cuadrando lo que promete el fabricante con lo que puede pagar el cliente que mirando benchmarks. Por eso esta guía no se queda en quién gana: mira cuánto cuesta cada nota y a qué nivel de esfuerzo se consigue.
Separo tres fuentes que no pesan lo mismo: el índice de Artificial Analysis, que mide a los dos con la misma batería; la tabla que Anthropic publicó con su modelo; y las dos tarifas de lista, pasadas a euros. Si vienes de la comparativa con Fable 5.1, aquí cambian las cuentas. Y donde algo no está medido, lo digo en vez de rellenar el hueco.
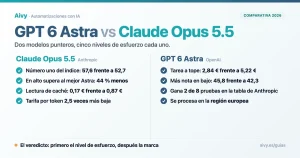
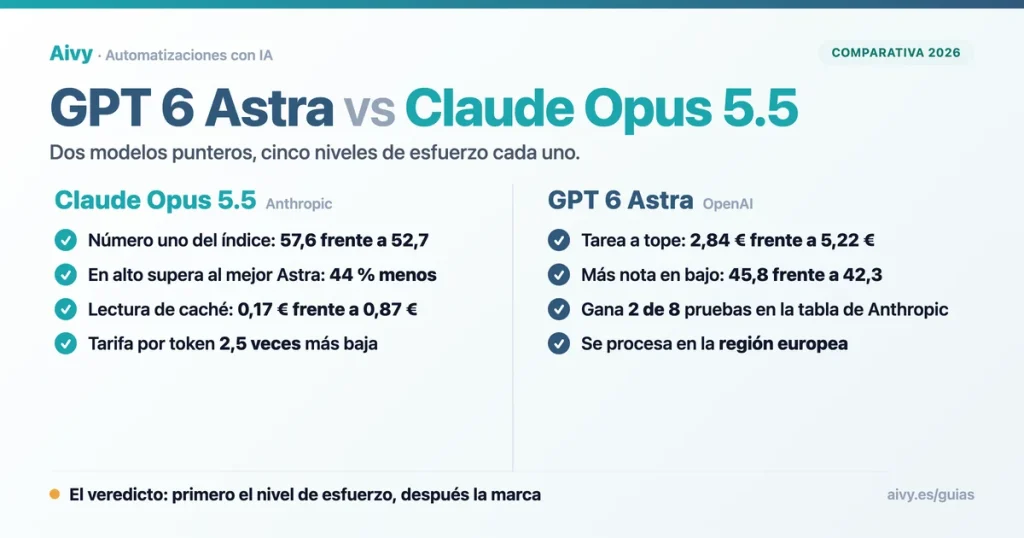
GPT 6 Astra vs Claude Opus 5.5 de un vistazo
Empiezo por el esfuerzo muy alto, porque ahí la comparación se tuerce. Según la versión 5 del índice de Artificial Analysis, Claude Opus 5.5 a esfuerzo muy alto saca 57,0. GPT 6 Astra a máximo, su escalón más alto, se queda en 56,9. Opus 5.5, un escalón por debajo de su techo, alcanza a Astra en el suyo. Y su tarea cuesta 5,43 € frente a 5,61 €: un 3 % menos.
Ahora baja un escalón. A esfuerzo alto, Astra saca 54,8 y Opus 5.5, 51,7, y la tarea de Astra cuesta menos, 2,91 € frente a 3,11 €. A máximo contra máximo, Opus 5.5 saca 58,4 frente a 56,9, pero su tarea cuesta 9,02 € frente a 5,61 €: 1,61 veces más, aunque la tarifa por token de Astra sea 2,5 veces más cara.
| Cara a cara | Claude Opus 5.5 (high) | Claude Opus 5.5 (max) | GPT 6 Astra (high) | GPT 6 Astra (max) | Claude Sonnet 5.5 (high) | Claude Sonnet 5.5 (max) |
|---|---|---|---|---|---|---|
| Índice de inteligencia v5 | 51,7 | 58,4 | 54,8 | 56,9 | 41,1 | 54,2 |
| Coste por tarea del índice | 3,11 € | 9,02 € | 2,91 € | 5,61 € | 1,47 € | 9,00 € |
| Tokens por segundo (18 de octubre) | 83 | 97 | 54 | 65 | 111 | 140 |
| Tarifa de entrada, por millón | 3,49 € | 3,49 € | 8,72 € | 8,72 € | 1,74 € | 1,74 € |
| Tarifa de salida, por millón | 17,45 € | 17,45 € | 43,62 € | 43,62 € | 8,72 € | 8,72 € |
| Leer un millón de tokens de caché | 0,17 € | 0,17 € | 0,87 € | 0,87 € | 0,09 € | 0,09 € |
Índice, coste por tarea (tarifa estándar, lectura del 22 de septiembre, igual el 18 de octubre; Claude Sonnet 5.5, del 18 de octubre) y velocidad (18 de octubre): Fuente: Artificial Analysis (artificialanalysis.ai). Artificial Analysis mide Claude con su modelo de reserva activado; la velocidad de Claude Sonnet 5.5 sale de su Data API. Las tres filas de tarifa son los precios publicados por Anthropic y OpenAI. Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Qué es cada modelo y por qué manda el nivel de esfuerzo
Claude Opus 5.5 es, según Anthropic, el primer modelo de la familia Claude 5.5, que después completaron Sonnet 5.5 y Haiku 5.5. GPT 6 Astra, que OpenAI lanzó el 3 de septiembre, es su modelo insignia. Por debajo, OpenAI sacó el 29 de septiembre GPT 6.1 Sol, la versión mejorada de GPT 6 Sol:
- Claude Opus 5.5: 1.000.000 de tokens de contexto y 128.000 de salida máxima, con el conocimiento cortado en junio de 2026, y no se retirará antes del 22 de septiembre de 2027.
- GPT 6 Astra: 1.050.000 tokens de contexto, los mismos 128.000 de salida y el corte en el 30 de abril.
- GPT 6.1 Sol: según su anuncio, casi iguala a Astra en programación con agentes, uso del ordenador y trabajo profesional por la quinta parte de su tarifa, y cobra lo mismo que Claude Sonnet 5.5. En las gráficas de esta guía va como referencia, en gris azulado: el duelo sigue siendo entre Astra y Opus 5.5.
Los dos se regulan con un dial de cinco escalones: low, medium, high, xhigh y max, que aquí llamo bajo, medio, alto, muy alto y máximo. Opus 5.5 viene en medio por defecto, cuando Opus 5 venía en alto, y su pensamiento es adaptativo y siempre activo. Astra razona en todos los niveles, con bajo como mínimo, y su ficha no dice cuál trae: mira qué envía tu integración.
En la versión 5 del índice de Artificial Analysis, Opus 5.5 recorre casi 24 puntos de bajo a máximo, de 34,5 a 58,4, y Astra unos 14, de 43,0 a 56,9. En coste, Opus 5.5 va de 0,88 € a 9,02 € la tarea, unas 10 veces, y Astra de 1,28 € a 5,61 €. Cambiar de nivel mueve más la nota que cambiar de modelo.
Índice de inteligencia v5 por nivel de esfuerzo
Más es mejor. Cada barra es un nivel de esfuerzo de un modelo. Barras a escala de 60 puntos. Crédito: Artificial Analysis, índice de inteligencia v5, leído el 28 de octubre de 2026; GPT 6.1 Sol, en gris azulado.
En esa lectura, por encima de todos quedaba Gemini 4 Carbon, de Google, con 59,4 a alto. El 9 de noviembre llegó Claude Fable 5.2, con 64,6 a máximo.
Basado en datos de Artificial Analysis, leídos el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Benchmarks: un árbitro independiente y la tabla de Anthropic
La primera prueba es el índice de Artificial Analysis, que pasa a todos los modelos por la misma batería y desde octubre va por su versión 5. Su índice agéntico mide a Astra, 51,0 a máximo, pero no a Opus 5.5, y el de programación de Opus 5.5 aparece sin medir: nadie puede decir que gane o pierda programando según Artificial Analysis. En la versión 5 ya los supera los supera Gemini 4 Carbon.
Opus 5.5 fue hasta el 9 de noviembre el primero de lo que se vende, pero no barre. En la tasa de no alucinación, una de las métricas de AA Omniscience, Astra saca 0,4866 frente a 0,4139 de Opus 5.5 a máximo (lectura del 22 de septiembre), y en GPQA Opus 5.5 está sin medir. Y un matiz de montaje: a Claude lo mide con su modelo de reserva activado (with fallback) y a Astra no.
Fable 5.2, el nuevo tope de Anthropic, se mete en este duelo por arriba: en la lectura del 9 de noviembre saca 56,4 a esfuerzo medio, casi lo mismo que Astra a máximo (56,9), por 3,40 € la tarea frente a 5,58 €. A máximo llega a 64,6, pero cada tarea cuesta 23,71 €.
La segunda fuente es la tabla 8.1.A de la system card de Opus 5.5, del propio Anthropic: ocho filas traen cifra para los dos y Astra gana dos, AutomationBench y Terminal Bench Science 0.1. Es favorable a Opus 5.5 de entrada, porque la eligió su fabricante, y Anthropic no hizo las pruebas de Astra: toma sus cifras de lo que publica cada desarrollador o de los tableros.
| System card, tabla 8.1.A | Claude Opus 5.5 | GPT 6 Astra | Lo que dice la letra pequeña |
|---|---|---|---|
| Terminal Bench 4.0 | 66,4 % | 57,9 % | No es el mismo esfuerzo: Claude a xhigh, Astra a high, que es lo que reportó OpenAI. Error típico de 2,6 puntos para Opus 5.5. Fuera de la card, Moonshot AI da a su modelo abierto Kimi K3.1 Pro un 65,7 %, cifra suya, y a Astra un 58,2 %, el mejor resultado publicado de Astra |
| GDPval AA v2.1 (Elo) | 1846 | 1542 | La midió un tercero, según Anthropic |
| AA Briefcase v1.1 | 1822 | 1569 | La midió un tercero, según Anthropic |
| Humanity’s Last Exam, con herramientas | 67,7 % | 57,2 % | Las dos cifras con herramientas |
| HealthBench Professional | 65,6 % | 63,4 % | 2,2 puntos a favor de Claude |
| FrontierCode v1.1 (Main) | 54,4 % | 53,3 % | La fila más ajustada, 1,1 puntos. Claude puntúa más a esfuerzo medio (54,6 %) que a máximo |
| AutomationBench | 40,0 % | 41,4 % | La hizo Zapier sin modelos de reserva: según el anuncio de Anthropic, cada parada de las salvaguardas contó como fallo |
| Terminal Bench Science 0.1 | 58,7 % | 64,6 % | Error típico de 3,5 a 4,8 puntos por modelo según la card, cercano a la diferencia |
Cifras del fabricante. Anthropic no midió las de GPT 6 Astra: según su propia nota, salen de lo que publica cada desarrollador o de sus tablas de clasificación. Resultados de Claude Opus 5.5 a esfuerzo máximo salvo Terminal Bench 4.0.
- Esfuerzos distintos: la primera fila, Terminal Bench 4.0, compara la mejor nota de cada uno, pero a esfuerzos distintos, y en Terminal Bench Science el error típico se acerca a la diferencia.
- Fuera de la tabla: en FrontierSWE v2, 34 tareas larguísimas que midió Proximal, Astra saca un 65,5 % frente al 62,3 %, y Anthropic reconoce a su modelo segundo. Que un fabricante publique dónde pierde le da credibilidad.
- Sin rival al lado: el 89,9 % de Opus 5.5 en SWE bench Pro llega sin cifra de Astra: no decide nada.
- La cautela de Anthropic: a estos niveles, los márgenes de los benchmarks son una guía menos fiable de las diferencias reales, y en su propio uso la distancia entre Opus 5.5 y Claude Fable 5.1 es menor de lo que dicen las cifras. Cómo se reparte esa familia lo cuento en qué modelo de Claude usar.
Precios y coste por tarea para una empresa española
OpenAI y Anthropic publican y facturan en dólares, y aquí todo está convertido al tipo del BCE del 22 de septiembre de 2026: un euro, 1,1463 dólares, el mismo en toda la guía. Lo que pague tu empresa se moverá con el cambio aunque la tarifa no se toque; si quieres echar números con tus volúmenes, está la calculadora de ROI.
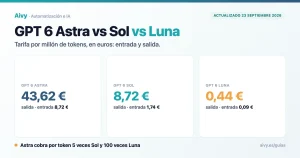
- De lista: Opus 5.5 cuesta 3,49 € por millón de tokens de entrada y 17,45 € por millón de salida; Astra cobra 8,72 € y 43,62 €, 2,5 veces más en las dos líneas.
- Por lotes, la mitad: Opus 5.5, 1,74 € y 8,72 €; Astra, 4,36 € y 21,81 €.
- Modo rápido de Anthropic, en Claude Code y en su plataforma: 6,98 € y 34,89 €.
Tarifa de lista por millón de tokens, en euros
Menos es más barato. Precios publicados, no consumo medido. Los dos paneles a escala de 43,62 €. Fuentes: páginas de precios de Anthropic y OpenAI, 22 de septiembre de 2026; Claude Sonnet 5.5, 28 de septiembre; GPT 6.1 Sol, 29 de septiembre. Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Entrada, por millón de tokens
Salida, por millón de tokens
Pero la tarifa no es la factura. Una tarea cuesta la tarifa por los tokens que el modelo gasta hasta acabarla, y ningún fabricante lo publica. Artificial Analysis sí lo mide, y ahí la ventaja de 2,5 veces se evapora: a esfuerzo alto, los dos quedan a 20 céntimos, 3,11 € Opus 5.5 y 2,91 € Astra, y con la versión 5 la nota es para Astra, 54,8 frente a 51,7.
A máximo contra máximo, Astra acaba la tarea por 5,61 € y Opus 5.5 por 9,02 €. De alto a máximo, Opus 5.5 multiplica su coste por 2,9 para pasar de 51,7 a 58,4 puntos. Y a medio, su valor por defecto, queda lejos del mejor Astra, 48,1 frente a 56,9, aunque por un 61 % menos: 2,20 € frente a 5,61 €.
Coste por tarea del índice según el nivel de esfuerzo
Menos es mejor. Barras a escala de 10 €. Crédito: Artificial Analysis, coste por tarea del índice de inteligencia v5 a tarifa estándar, leído el 28 de octubre de 2026. Convertido a 1 euro = 1,1133 dólares, tipo del BCE del 28 de octubre de 2026.
Basado en datos de Artificial Analysis, leídos el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Abajo, la nota es de Astra: a bajo saca 43,0 frente a 34,5, y a medio, 51,5 frente a 48,1, y cuesta 1,28 € frente a 0,88 € y 2,45 € frente a 2,20 €.
- El argumento del fabricante: Anthropic afirma que en FrontierCode, a su esfuerzo por defecto, Opus 5.5 le gana a Astra gastando alrededor de una quinta parte de su coste por tarea, y que en Terminal Bench 4.0 lo iguala con cerca del 40 %. Son cifras de Anthropic sobre su propio modelo.
- ¿Y Claude Sonnet 5.5? Anthropic lo lanzó el 28 de septiembre y cobra la mitad que Opus 5.5 por token, 1,74 € y 8,72 €. Con la versión 5, a esfuerzo alto saca 41,1 por 1,47 € la tarea: menos nota que los dos, pero más barato que ambos. A máximo llega a 54,2, por debajo de Astra, por 9,00 € la tarea, casi lo mismo que Opus 5.5 a máximo.
La caché de prompts, donde se abre la brecha para los agentes
En la lectura de caché la brecha pasa de 2,5 a 5 veces: Opus 5.5 lee un millón de tokens cacheados por 0,17 € y Astra por 0,87 €. Es lo que un agente paga en cada paso, porque relee su contexto cada vez que decide algo. La escritura es menos frecuente: 4,36 € el millón en Opus 5.5 con la caché de cinco minutos y 10,90 € en Astra.
Por eso, en un proyecto de agentes de IA, esta fila suele pesar más que la de entrada. Y por encima de 272.000 tokens la distancia se abre otra vez: Astra dobla su lectura de caché a 1,74 € por millón y Anthropic no se mueve. Diez veces, justo en el trabajo que pasa de ese umbral: un agente que relee el manual interno en cada paso.
Es Opus 5.5 el que ha bajado, no Astra el que ha subido. Opus 5 leía caché a 0,44 € y Opus 5.5 a 0,17 €, un 60 % menos, y GPT 6 Sol, que OpenAI presentó junto a Luna, empata con él. Claude Sonnet 5.5 y GPT 6.1 Sol leen más barato, a 0,09 €, y en porcentaje de su entrada gana Fable 5.1, con un 2,5 %.
Leer un millón de tokens de caché, en euros
Menos es más barato. Por encima de 272.000 tokens de entrada, OpenAI dobla la tarifa de caché de toda la petición; Anthropic cobra la ventana entera a tarifa normal. Los dos paneles a escala de 1,74 €. Fuentes: páginas de precios de Anthropic y OpenAI, 22 de septiembre de 2026; Claude Sonnet 5.5, releída el 19 de octubre; GPT 6.1 Sol, 29 de septiembre. Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Petición de menos de 272.000 tokens
Petición de más de 272.000 tokens
El tramo de los 272.000 tokens de Astra
Astra tiene una cláusula que está en su ficha pero se pasa por alto, y cambia la factura. Cuando una petición pasa de 272.000 tokens, OpenAI la cobra entera al doble en entrada y en caché, y a 1,5 veces en salida, desde el primer token y no solo el exceso. En euros, 17,45 € de entrada, 65,43 € de salida y 1,74 € de caché por millón.
Anthropic hace lo contrario y lo pone por escrito: una petición de 900.000 tokens se cobra al mismo precio por token que una de 9.000. Con ventanas de un millón de tokens en los dos modelos, el umbral se cruza antes de lo que parece: en sectores como el de las asesorías y gestorías, donde cada cliente arrastra años de papeles, un expediente completo puede pasarlo en una sola llamada.
La consecuencia es de diseño antes que de compra. Si vas a meter documentos grandes en Astra, compensa trocear y recuperar solo lo necesario en vez de volcarlo todo en cada llamada, algo básico en cualquier proyecto de automatización documental.
Velocidad y latencia: lo que cambia de un día a otro
Aquí todo va con fecha. El índice y el coste por tarea salieron idénticos el 22 y el 23 de septiembre; la latencia, no. Lo que sí aguanta es el ritmo de escritura: según Artificial Analysis, en tokens por segundo Opus 5.5 va más rápido que Astra en todos los esfuerzos. A esfuerzo alto, el 18 de octubre, 83 frente a 54. Gemini 4 Carbon, por su parte, escribe más rápido que Astra.
Tokens de salida por segundo según el nivel de esfuerzo
Más es mejor. Mediana medida por Artificial Analysis en su tablero del 18 de octubre de 2026, la misma lectura para los cuatro modelos. Barras a escala de 140.
El 18 de octubre ya tienen velocidad medida Claude Opus 5.5 y Claude Sonnet 5.5 a esfuerzo máximo, que en septiembre faltaban. La velocidad cambia de un día a otro: mide con tus prompts.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Empezar a responder es otra historia. El primer fragmento de respuesta de Opus 5.5 a esfuerzo alto pasó de 12,65 segundos el 22 de septiembre a 39,80 el 23, y aun así ese día arrancaba antes que Astra a alto, que tardó 79,00. Bajando el esfuerzo se invierte: a medio, el 23 de septiembre, Astra soltó su primer fragmento en 6,19 segundos y Opus 5.5 en 24,35.
| Primer fragmento de respuesta, en segundos | 22 de septiembre | 23 de septiembre |
|---|---|---|
| Claude Opus 5.5 (xhigh) | 170,23 | 160,33 |
| Claude Opus 5.5 (high) | 12,65 | 39,80 |
| Claude Opus 5.5 (medium) | 22,48 | 24,35 |
| Claude Opus 5.5 (low) | 7,03 | 7,03 |
| GPT 6 Astra (max) | 323,74 | 342,30 |
| GPT 6 Astra (high) | 79,00 | 79,00 |
| GPT 6 Astra (medium) | 6,36 | 6,19 |
| GPT 6 Astra (low) | 2,86 | 2,79 |
Tiempo hasta el primer fragmento de respuesta, en dos lecturas del tablero público. Claude Opus 5.5 a esfuerzo máximo no tiene latencia medida en ninguna de las dos. Fuente: Artificial Analysis (artificialanalysis.ai).
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Así que Opus 5.5 es más rápido es falso como regla general. A esfuerzo bajo, la respuesta completa del 23 de septiembre quedó en 13,19 segundos para Astra y 13,49 para Opus 5.5, y arriba los dos tardan minutos: Opus 5.5 a muy alto, 160,33 segundos hasta el primer fragmento, y Astra a máximo, 342,30. Opus 5.5 a máximo, entonces sin medir, marcó 556,94 el 18 de octubre.
- Con una persona esperando, como un chatbot con clientes en horario de oficina: alto o por debajo, y la espera medida con tus prompts, porque la tabla de un día no vale para el siguiente.
- Lo que se procesa de noche puede subir a muy alto o máximo. En una empresa española esto lo decide más el horario que el proveedor.
Dónde se procesan tus datos si tu empresa está en Europa
Ningún benchmark contesta una pregunta que pesa en cualquier revisión seria: dónde se procesan los datos. Y aquí la comparación se da la vuelta. OpenAI tiene una región Europa, que cubre el Espacio Económico Europeo y Suiza, con almacenamiento y procesamiento, y GPT 6 Astra figura entre sus modelos con procesamiento europeo, según su guía de datos:
- La letra pequeña de OpenAI: hay que pasar por ventas para ver si eres elegible, estar aprobado para los controles de vigilancia de abusos (abuse monitoring) y firmar una Modified Retention amendment. Los endpoints de residencia cobran un recargo del 10 % en los modelos publicados desde el 5 de marzo de 2026, Astra incluido, y no cubren los datos de sistema, como metadatos, uso o facturación.
- Anthropic: su API no tiene opción europea. La documentación, consultada el 23 de septiembre y de nuevo el 19 de octubre, solo admite Estados Unidos o enrutado global como geografía de inferencia, y los datos en reposo del espacio de trabajo solo pueden estar en Estados Unidos. Fijarlo en Estados Unidos cuesta 1,1 veces la tarifa.
- Nubes de terceros: Anthropic dice que los endpoints regionales de Bedrock y Google Cloud llevan un 10 % de sobreprecio, pero no he comprobado si Opus 5.5 está en alguna región europea de esas nubes.
Anthropic dice que Opus 5.5 se puede usar con retención de datos cero, y OpenAI también la contempla para su región europea. Pero residencia y retención son preguntas distintas para el RGPD: una dice dónde se guarda y se procesa el dato, y la otra si se guarda y cuánto tiempo. Ninguna te hace cumplir por sí sola; el marco general está en la guía de RGPD y AI Act.
Un aviso más. Anthropic declara que Opus 5.5 es más propenso que modelos anteriores a seguir instrucciones maliciosas en texto que el usuario pega en su propio prompt, y OpenAI dice en su card que Astra es su primer modelo en el nivel Critical de capacidad en ciberseguridad. Son marcos distintos. Si en tu empresa se pegan documentos sin control, terreno de la shadow AI, lo primero importa.
Qué modelo elegiría para un proyecto de cliente
Cada fabricante habla de sus propios modelos. Anthropic escribe que, si no sabes cuál usar, empieces por Claude Opus 5.5 para la mayoría de cargas y pases a su gama Fable, desde el 9 de noviembre Claude Fable 5.2, para el razonamiento exigente o el trabajo agéntico largo. OpenAI, en su índice de modelos, propone empezar por GPT 6 Astra, su modelo insignia, y bajar a GPT 6.1 Sol para equilibrar coste y nota.
- La nota del mejor Astra, pagando algo menos: empezaría por Opus 5.5 a esfuerzo muy alto, que lo iguala, con una décima más, y cuesta un 3 % menos por tarea. A esfuerzo alto, en cambio, la cuenta es de Astra.
- Con una persona esperando: mide antes la espera. El 23 de septiembre, Opus 5.5 a alto tardó 39,80 segundos en su primer fragmento y Astra a medio, 6,19.
- Sin nadie esperando la respuesta: la cuenta sale al revés, y Astra a máximo termina la tarea por 5,61 € frente a 9,02 €.
Opus 5.5 a máximo te da el primer puesto de lo que se puede contratar, y eso se paga a sabiendas, para trabajo donde equivocarse sale caro. Astra tiene bazas que no salen en el índice: en FrontierSWE v2 saca más nota (las herramientas de programación las comparo en Claude Code frente a Codex), y si el procesamiento en Europa por la API propia es requisito, de los dos solo OpenAI lo documenta hoy.
| Lo que vas a montar | Por dónde empezaría | Coste por tarea del índice | Por qué |
|---|---|---|---|
| La nota del mejor Astra, pagando algo menos | Claude Opus 5.5, xhigh | 5,43 € | Iguala al mejor Astra en el índice, con una décima más. Si hay alguien esperando, mide la espera: cambia de un día a otro |
| Agentes que releen un contexto largo | Claude Opus 5.5, el nivel que pida la tarea | según el nivel | La lectura de caché cuesta 0,17 € el millón frente a 0,87 €, y la distancia sube a diez veces por encima de 272.000 tokens |
| Trabajo desatendido a esfuerzo máximo | GPT 6 Astra, max | 5,61 € | 56,9 puntos en el índice por el 62 % de lo que cuesta el máximo de Claude. Por lotes, los dos cobran la mitad |
| Clasificar y enrutar a volumen | GPT 6 Astra, low | 1,28 € | 43,0 puntos frente a 34,5 de Claude a low. En las lecturas del 22 y el 23 de septiembre, la respuesta completa tardó prácticamente lo mismo en los dos: elige por nota y precio |
| Datos que deben procesarse en Europa | GPT 6 Astra, con residencia europea | el del nivel elegido, más el recargo del 10 % de OpenAI | OpenAI lo procesa en su región europea si pasas por ventas; la API de Anthropic solo ofrece Estados Unidos o enrutado global |
Coste por tarea a tarifa estándar, lectura del 22 de septiembre: Fuente: Artificial Analysis (artificialanalysis.ai). El recargo del 10 % es de OpenAI. Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Una advertencia: ninguna de estas cifras sale de tus documentos, tu idioma ni tu proceso. Por eso las pruebas propias pesan más que cualquier clasificación pública, más aún con diferencias de uno o dos puntos. Para eso sirve una consultoría de IA bien planteada: medir con tu carga real, escalón por escalón, antes de firmar nada.
Preguntas frecuentes sobre GPT 6 Astra vs Claude Opus 5.5
¿Cuál es mejor, GPT 6 Astra o Claude Opus 5.5?
En la versión 5 del índice independiente de Artificial Analysis, Claude Opus 5.5: saca 58,4 a esfuerzo máximo frente a 56,9 de GPT 6 Astra, y a muy alto ya alcanza al mejor Astra; a esfuerzo alto, en cambio, saca menos que Astra al mismo nivel. Pero en la tabla del propio Anthropic, Astra se lleva dos de las ocho pruebas con cifra para los dos, y puntúa más en FrontierSWE v2. Antes de subir a máximo, mira cuánto cuesta y cuánto tarda cada nivel de esfuerzo.
¿Cuál sale más barato?
Depende del esfuerzo. Astra cobra 2,5 veces más por token, pero a esfuerzo máximo su tarea del índice cuesta 5,61 € frente a 9,02 € de Opus 5.5. A esfuerzo alto casi empatan en coste, 2,91 € y 3,11 €, con más nota para Astra. Y Opus 5.5 a muy alto alcanza al mejor Astra por un 3 % menos. Fuera del duelo, GPT 6.1 Sol cobra la quinta parte que Astra y su tarea sale a 1,14 € a máximo.
¿Cuánto cuestan GPT 6 Astra y Claude Opus 5.5 en España?
Los dos facturan en dólares. Al tipo del BCE del 22 de septiembre de 2026, Claude Opus 5.5 cuesta 3,49 € por millón de tokens de entrada y 17,45 € de salida. GPT 6 Astra, 8,72 € y 43,62 €, y por encima de 272.000 tokens cobra toda la petición a 17,45 € y 65,43 €.
¿Cuál conviene para agentes?
Por coste, Claude Opus 5.5. Un agente relee su contexto en cada paso, y la lectura de caché cuesta 0,17 € por millón en Opus 5.5 frente a 0,87 € en GPT 6 Astra: cinco veces menos, y diez por encima de 272.000 tokens. Pero en FrontierSWE v2, con tareas ultralargas, puntúa más Astra: prueba los dos con tus flujos largos.
¿Cuál responde antes?
Depende del esfuerzo y del día. Según Artificial Analysis, el 23 de septiembre de 2026 Claude Opus 5.5 a esfuerzo alto tardaba 39,80 segundos en soltar el primer fragmento de respuesta frente a 79,00 de GPT 6 Astra a alto; el día anterior, Opus 5.5 a alto había tardado 12,65. A esfuerzo medio, Astra respondía antes: 6,19 segundos frente a 24,35. Opus 5.5 a máximo, sin medir en septiembre, marcó 556,94 segundos el 18 de octubre.
¿Puedo procesar los datos en Europa con alguno de los dos?
Por la API directa del fabricante, solo con GPT 6 Astra: OpenAI tiene una región Europa con procesamiento, sujeta a pasar por ventas para ver si eres elegible, a una Modified Retention amendment y a un recargo del 10 %. La API de Anthropic solo ofrece Estados Unidos o enrutado global. Y la residencia, por sí sola, no garantiza el cumplimiento del RGPD.
¿Claude Opus 5.5 es tan bueno como Claude Fable 5.1?
Anthropic dice que rinde a su nivel en la mayoría del trabajo y aconseja, si no sabes cuál usar, empezar por Opus 5.5 y pasar a la gama Fable, hoy Fable 5.2, para el razonamiento exigente o el trabajo agéntico largo. Cómo quedaban en la generación anterior lo cuento en Opus 5 frente a Fable 5.
¿Y Claude Fable 5.2 supera a GPT 6 Astra?
En nota, sí: en la versión 5 del índice de Artificial Analysis, leída el 9 de noviembre de 2026, Fable 5.2 saca 64,6 a máximo y 61,8 a alto, frente a 56,9 de Astra a máximo. Y por token cobra menos: 7,15 € y 35,74 € por millón, frente a 8,93 € y 44,67 € de Astra al tipo del BCE de ese día.
¿Se puede usar Claude Opus 5.5 en AWS, Google Cloud o Azure?
Sí. Anthropic dice que Opus 5.5 está disponible en todas las plataformas, incluidas AWS, Google Cloud y Microsoft Azure. Por separado, dice que se puede usar con retención de datos cero, sin precisar en qué plataformas. No he comprobado si está en alguna región europea de Bedrock o Google Cloud, y la propia Anthropic avisa de que los endpoints regionales de esas nubes llevan un 10 % de sobreprecio.
Primero el nivel de esfuerzo, después la marca
Con la versión 5, Opus 5.5 necesita esfuerzo muy alto para alcanzar a Astra a máximo, y entonces cuesta un 3 % menos. Súbelo a máximo y su tarea cuesta 1,66 veces más, y la barata pasa a ser la del rival; de alto para abajo, la nota es de Astra. Con una excepción: si tu agente relee mucho contexto, la caché vuelve a poner la marca por delante.
Si revisara hoy un proyecto, lo primero que buscaría es un agente que sigue en el esfuerzo del día en que se montó. No parece roto, pero gasta de más o piensa de menos. El arreglo es pequeño: cada tarea, al escalón más barato que siga pasando tus pruebas. Si quieres que lo revisemos con tus prompts reales, reserva una llamada y lo miramos juntos.
Última actualización: 9 de noviembre de 2026
- Anthropic, anuncio de Claude Opus 5.5: tarifas de lista y de caché, modo rápido, el 40 % menos que Opus 5 en cargas típicas, las afirmaciones de coste frente a GPT 6 Astra en FrontierCode y Terminal Bench 4.0, la nota de que Zapier hizo AutomationBench sin modelos de reserva, la cautela sobre los márgenes de los benchmarks, las plataformas y la retención de datos cero. 22 de septiembre de 2026.
- OpenAI, anuncio de GPT 6.1 Terra: en Agents' Last Exam a esfuerzo máximo, 3 veces más eficiente en tokens que Claude Opus 5.5 y a un cuarto de su precio por token, unas 9 veces menos coste por tarea, cifras del fabricante. Tarifa de su ficha, 1 y 5 dólares por millón, al tipo del BCE del 26 de octubre de 2026, 1 euro por 1,1188 dólares. Índice de Artificial Analysis, 51,0 a máximo en la versión 5, leída el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él. 26 de octubre de 2026.
- Anthropic, anuncio de Claude Sonnet 5.5: tarifa igual que Sonnet 5, más de un 30 % más rápido y hasta un 30 % menos por tarea, y Opus 5.5 para el trabajo complejo. 28 de septiembre de 2026.
- Moonshot AI, anuncio de Kimi K3.1 Pro: 65,7 % en Terminal Bench 4.0 frente al 66,4 % de Claude Opus 5.5 y al 58,2 % de GPT 6 Astra, que Moonshot toma como el máximo publicado en el blog de cada fabricante o en la tabla oficial de la prueba. Cifras de Moonshot, no verificadas por terceros. 23 de octubre de 2026.
- Anthropic, documentación de Claude Opus 5.5: ventana de contexto, salida máxima, corte de conocimiento, niveles de esfuerzo y el medio por defecto, pensamiento adaptativo siempre activo y el compromiso de no retirarlo antes del 22 de septiembre de 2027. Consultada el 22 de septiembre de 2026.
- Anthropic, resumen de modelos: la recomendación de empezar por Claude Opus 5.5 y reservar Claude Fable 5.1, y el paso de Claude Opus 5 a la lista de modelos heredados. Consultado el 22 de septiembre de 2026.
- Anthropic, system card de Claude Opus 5.5: la tabla 8.1.A (página 174) con su nota metodológica, y del capítulo 8 los resultados de FrontierSWE v2, SWE bench Pro, FrontierCode por nivel de esfuerzo y el error típico de Terminal Bench Science, además de la regresión con instrucciones pegadas en el prompt. 22 de septiembre de 2026.
- Anthropic, precios de la API: lectura de caché de Claude Opus 5.5 y su porcentaje frente al de Claude Fable 5.1, lotes, precio de la ventana larga y el 10 % de sobreprecio de los endpoints regionales de Bedrock y Google Cloud. Consultada el 22 y el 23 de septiembre de 2026; la tarifa de Claude Sonnet 5.5 y la ventana larga a precio normal, el 28; la lectura de caché de Claude Sonnet 5.5, 0,10 dólares por millón, el 19 de octubre.
- Anthropic, residencia de datos: las geografías de inferencia disponibles, Estados Unidos o global, la del espacio de trabajo y el multiplicador de 1,1 por fijar Estados Unidos. Consultada el 23 de septiembre y el 19 de octubre de 2026.
- OpenAI, ficha de GPT 6 Astra: tarifas de entrada, salida y entrada en caché, ventana de contexto, salida máxima, corte de conocimiento, niveles de esfuerzo y el recargo por encima de 272.000 tokens de entrada. Consultada el 22 de septiembre de 2026.
- OpenAI, precios de la API: tarifas de tramo largo y por lotes de GPT 6 Astra, lectura de caché de GPT 6 Sol y escritura de caché. Consultada el 22 de septiembre de 2026.
- OpenAI, índice de modelos: la recomendación de empezar por GPT 6 Astra si no sabes por dónde empezar y de GPT 6.1 Sol para equilibrar coste y nota. Consultado el 22 de septiembre y el 19 de octubre de 2026.
- OpenAI, GPT 6 y otros modelos en ChatGPT: desde el 7 de octubre de 2026, GPT 6 Pro con Astra en el chat de Pro, Business y Enterprise.
- OpenAI, anuncio de GPT 6.1 Sol: casi el nivel de Astra por la quinta parte de su tarifa, según OpenAI, y la tarifa de 2 y 10 dólares por millón con la caché a 0,10. 29 de septiembre de 2026.
- OpenAI, guía de datos y residencia: la región Europa (Espacio Económico Europeo y Suiza) con almacenamiento y procesamiento, la lista de modelos con procesamiento europeo, los requisitos de ventas, abuse monitoring y Modified Retention amendment, la exclusión de los datos de sistema y el recargo del 10 % para modelos publicados desde el 5 de marzo de 2026. Consultada el 22 de septiembre de 2026.
- OpenAI, system card de GPT 6 Astra: su clasificación como primer modelo de OpenAI en el nivel Critical de capacidad en ciberseguridad según su marco de preparación. Consultada el 22 de septiembre de 2026.
- Fuente: Artificial Analysis (artificialanalysis.ai): índice de inteligencia v5 y coste por tarea por nivel de esfuerzo de Claude Opus 5.5, Sonnet 5.5, GPT 6 Astra y GPT 6.1 Sol, índice agéntico de GPT 6 Astra y Gemini 4 Carbon a alto, leídos el 28 de octubre de 2026 al tipo del BCE de ese día, 1 euro por 1,1133 dólares. Tokens por segundo, primer fragmento de respuesta y respuesta completa, en el tablero público leído el 22 y el 23 de septiembre de 2026 (Claude Sonnet 5.5, el 28, con su velocidad de la Data API de ese día; GPT 6.1 Sol, el 29, con su velocidad de la Data API de ese día), y la subpuntuación de no alucinación de AA Omniscience del 22 de septiembre. Releído el 18 de octubre de 2026: mismas cifras para Claude Opus 5.5 y GPT 6 Astra, y coste por tarea nuevo para Claude Sonnet 5.5. El índice de programación, sin medir para Claude Opus 5.5, sale de su Data API, leída el 23 de septiembre de 2026. Las gráficas y tablas basadas en estos datos llevan su logotipo o su crédito. Basado en datos de Artificial Analysis. Artificial Analysis no avala, valida ni aprueba este análisis ni sus conclusiones, y no es responsable de ellos.
- Google, anuncio de Gemini 4 Carbon: 28 de octubre de 2026; su modelo más potente, primero para un grupo de ciberdefensores y después para los socios del programa Fairwind, sin fecha para el resto.
- Banco Central Europeo, tipo de cambio de referencia: 1 euro = 1,1463 dólares el 22 de septiembre de 2026, usado en todas las conversiones de esta guía.
- Anthropic, anuncio de Claude Fable 5.2: 9 de noviembre de 2026; 8 y 40 dólares por millón de tokens, convertidos al tipo del BCE de ese día, 1 euro por 1,1193 dólares.
- Artificial Analysis, lectura del 9 de noviembre: Claude Fable 5.2 a medio, alto y máximo (56,4, 61,8 y 64,6; 3,40 €, 8,11 € y 23,71 € por tarea) y GPT 6 Astra a máximo (56,9, 5,58 €). Artificial Analysis no avala este análisis ni es responsable de él.
Las cifras del índice reflejan el tablero tal como estaba el 22 y el 23 de septiembre de 2026, el 28 para Claude Sonnet 5.5 y el 29 para GPT 6.1 Sol; la lectura del 18 de octubre solo cambió el coste por tarea de Claude Sonnet 5.5. Cambian cuando los modelos se vuelven a medir. Las cifras de benchmarks atribuidas a Anthropic son del propio fabricante.