Anthropic lanzó Claude Opus 5.5 el 22 de septiembre de 2026, tres semanas después de Claude Fable 5.1, y su documentación trae un consejo directo: si no sabes cuál usar, empieza por Opus 5.5 y deja Fable 5.1 para razonamiento exigente o para cuando a más esfuerzo tus pruebas se queden cortas. En el duelo Claude Opus 5.5 vs Fable 5.1, quien fabrica los dos te manda primero al barato.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y los consejos de un fabricante los leo con lupa. Esta vez el índice independiente de Artificial Analysis lo respalda: Opus 5.5 a esfuerzo máximo supera a Fable 5.1 a máximo, y la tarea del índice le sale más barata. Aun así, Anthropic sigue mandando a Fable 5.1 el razonamiento exigente.
Las dos cosas son ciertas, y por eso esta guía no corona a nadie. Pasa a euros la tarifa y el coste por tarea, separa quién midió cada cifra y explica por qué el esfuerzo con el que arranca cada modelo cambia la factura. Si vienes de nuestra comparativa anterior, el escalón barato ha cambiado de nombre y de precio: ahora es Opus 5.5.
Qué es Claude Opus 5.5 y qué comparte con Fable 5.1
Claude Opus 5.5 es el primer modelo de la familia Claude 5.5, y Anthropic lo presenta para programación agéntica de largo recorrido y trabajo de conocimiento. A Fable 5.1 le reserva el razonamiento exigente y el trabajo agéntico largo. En el índice de Artificial Analysis, Opus 5.5 le quitó el número uno a Fable 5.1. Sonnet 5.5 llegó el 28 de septiembre, y Haiku 5.5, el 7 de octubre.
Sobre el papel son casi gemelos: un millón de tokens de contexto, 128.000 de salida máxima, conocimiento cortado en junio de 2026 y pensamiento adaptativo siempre encendido. En su tabla comparativa, Anthropic solo los separa en el precio, la latencia según su propia etiqueta y el esfuerzo por defecto, medio frente a alto. Con Fable 5.1 no compras más memoria ni conocimiento más fresco: compras profundidad de razonamiento.
| Ficha | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Lanzamiento | 22 de septiembre de 2026 | 1 de septiembre de 2026 |
| Retirada | no antes del 22 de septiembre de 2027 | no antes del 1 de septiembre de 2027 |
| Contexto | 1.000.000 de tokens | 1.000.000 de tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Corte de conocimiento | junio de 2026 | junio de 2026 |
| Pensamiento | adaptativo, siempre activo | adaptativo, siempre activo |
| Esfuerzo por defecto | medio | alto |
| Latencia, en palabras de Anthropic | moderada | más lenta |
| Para qué, según Anthropic | programación agéntica de largo recorrido y trabajo de conocimiento | razonamiento exigente y trabajo agéntico de largo recorrido |
Documentación de modelos y ficha de Claude Opus 5.5 de Anthropic, leídas el 22 de septiembre de 2026. La latencia es una etiqueta del fabricante, no una medida.
Fable 5.1 no está de salida. Llegó el 1 de septiembre junto a Claude Mythos 5.1, como contamos en su lanzamiento, y sigue en la tabla de modelos actuales. Lo que cambia es el peldaño de abajo: Opus 5.5 ocupa la casilla de Claude Opus 5, que pasa a la lista de heredados y sigue disponible.
Cuánto cuestan y el selector de esfuerzo
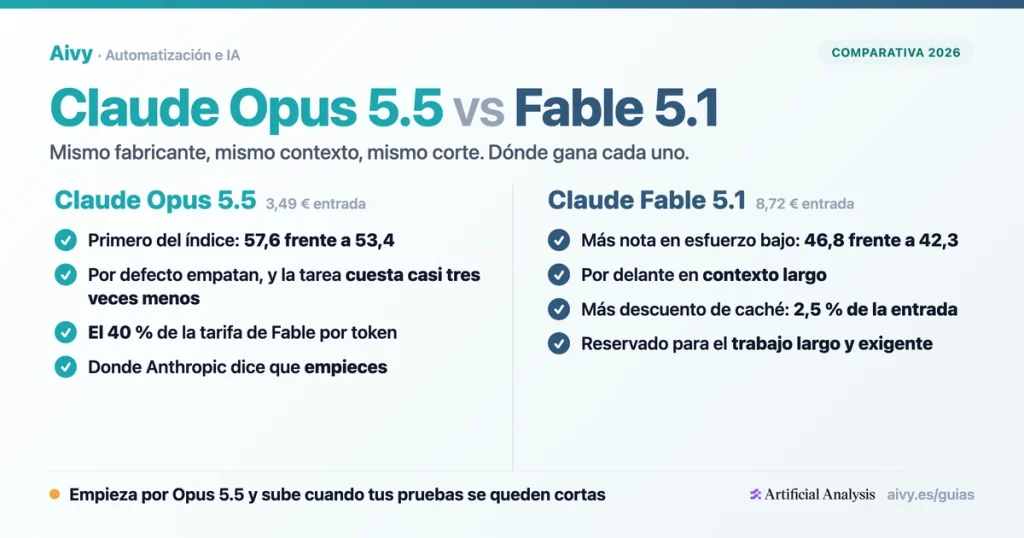
Anthropic publica y cobra en dólares, así que los importes de esta guía van en euros al tipo del BCE del 22 de septiembre de 2026. Opus 5.5 cuesta 3,49 € por millón de tokens de entrada y 17,45 € de salida; Fable 5.1, 8,72 € y 43,62 €. Opus 5.5 sale un 60% más barato en las dos líneas: Fable 5.1 cuesta dos veces y media por token.
Opus 5.5 baja la tarifa de Opus 5 y cuesta un 60% menos que Fable 5.1
Euros por millón de tokens. Más bajo es más barato. Las diez barras a escala de la mayor, 43,62 €. Fuente: página de precios de Anthropic, leída el 22 y el 23 de septiembre de 2026; Claude Sonnet 5.5, el 28, y Claude Haiku 5.5, el 7 de octubre, con prompts de hasta 100.000 tokens. Anthropic publica y cobra en dólares; convertido al tipo del BCE del 22 de septiembre de 2026.
Entrada, por millón de tokens
Salida, por millón de tokens
- Frente a Claude Opus 5: que cobra 4,36 € y 21,81 €, el nuevo baja un 20% por token.
- Ojo con el 40% del anuncio: Anthropic dice que ejecutar Opus 5.5 cuesta un 40% menos que ejecutar Opus 5 porque cobra menos por token y gasta menos tokens por tarea, en cargas típicas. Se mide contra Opus 5, no contra Fable 5.1, y no es una tarifa: tokens un 40% más baratos no hay.
- Leer de caché un millón de tokens: cuesta 0,17 € con Opus 5.5, 0,22 € con Fable 5.1 y 0,44 € con Opus 5. Sobre la tarifa en dólares, sin redondeos, Opus 5.5 cobra un 20% menos que Fable 5.1 y un 60% menos que Opus 5.
- El descuento de la caché: sobre su propia tarifa de entrada, Fable 5.1 descuenta más. Releer le cuesta el 2,5% de lo que cobra por un token nuevo, y a Opus 5.5, el 5%.
Leer de caché sale más barato con Opus 5.5, aunque Fable 5.1 descuente más sobre su entrada
Euros por millón de tokens leídos de caché. Más bajo es más barato. Barras a escala de la mayor, 0,44 €. Fuente: página de precios de Anthropic, leída el 22 y el 23 de septiembre de 2026 (Claude Sonnet 5.5, con su rebaja, y Claude Haiku 5.5, el 7 de octubre), convertida al tipo del BCE del 22 de septiembre de 2026.
Respecto a su propia tarifa de entrada, la lectura cuesta el 10% en Opus 5 y en Haiku 5.5, el 5% en Opus 5.5 y en Sonnet 5.5, que desde el 7 de octubre de 2026 lee a la mitad que Opus 5.5, y el 2,5% en Fable 5.1. Sobre la tarifa en dólares, sin el redondeo del cambio, Opus 5.5 lee un 60% más barato que Opus 5 y un 20% más barato que Fable 5.1.
Importa porque, según el anuncio de Anthropic, las lecturas de caché son la mayor parte del coste del trabajo agéntico y de programación. En esa línea Opus 5.5 aventaja a Fable 5.1 en un 20%, no en un 60%: a igualdad de tokens, cuanto más relea tu carga el mismo contexto, más se estrecha la distancia de tarifa. Para echar tus propias cuentas, tienes la calculadora de ROI.
El segundo mando es el esfuerzo: bajo, medio, alto, muy alto y máximo. El pensamiento no se apaga en ninguno de los dos, y no arrancan igual: Opus 5.5 viene en medio y Fable 5.1 en alto. Tampoco hay recargo por contexto largo: una petición de 900.000 tokens paga lo mismo por token que una de 9.000, al contrario que el tramo de 272.000 tokens de GPT 6 Astra.
Gasto de tokens en la práctica: lo que cuesta una tarea
La factura es la tarifa por los tokens que el modelo gasta hasta terminar, y el esfuerzo mueve mucho ese segundo número: con Opus 5.5 va de 0,88 € a 9,02 € la tarea. Artificial Analysis, un evaluador independiente, publica el coste por tarea de su índice de inteligencia, ya en la versión 5, para cada modelo y cada esfuerzo. Es lo más parecido a una factura publicada, aunque no sea la tuya.
- Con los ajustes de fábrica, que es lo que te llevas si no tocas nada: Opus 5.5 en medio marca 48,1 y la tarea le sale a 2,20 €; Fable 5.1 en alto marca 47,0 por 6,79 €. Opus 5.5 saca algo más de nota, y aun así Fable 5.1 cuesta unas tres veces más por tarea: 6,79 € entre 2,20 € da 3,08.
- Con el mismo ajuste en los dos, la distancia de coste sigue ahí. En alto contra alto, Opus 5.5 saca 4,7 puntos más y Fable 5.1 cuesta unas 2,2 veces lo que él, 6,79 € frente a 3,11 €. En medio contra medio son 5,1 puntos y unas 2,3 veces, 5,01 € frente a 2,20 €.
A cada nivel de esfuerzo, la tarea de Fable 5.1 cuesta más que la de Opus 5.5
Euros por tarea del índice de inteligencia v5. Más bajo es mejor. Barras a escala de la mayor, 11,71 €. Fuente: Artificial Analysis (artificialanalysis.ai), leído el 28 de octubre de 2026. Convertido al tipo del BCE del 28 de octubre de 2026.
Máximo
Muy alto
Alto
Medio
Bajo
Opus 5.5 en máximo, 9,02 € la tarea, cuesta menos que Fable 5.1 en muy alto, 9,78 €, y casi lo mismo que Sonnet 5.5 en máximo, 9,00 €.
Basado en datos de Artificial Analysis, leídos el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
La cuenta que más me interesa es otra. Opus 5.5 en alto marca 51,7 a 3,11 € la tarea, y el mejor Fable 5.1, en muy alto, 49,7 a 9,78 €: Opus 5.5 saca dos puntos más por menos de un tercio. Y arriba del todo, Opus 5.5 en máximo cuesta algo menos que Fable 5.1 en muy alto, 9,02 € frente a 9,78 €, y saca 8,7 puntos más.
Anthropic suma una prueba interna: al traducir HAProxy de C a Rust, las dos reescrituras pasaron casi todas sus pruebas de regresión, pero Opus 5.5 terminó en 9,5 horas frente a 12 y costó un 51% menos. Una sola prueba, y del fabricante, no de campo.
Qué dicen los benchmarks y quién los ha medido
Aquí se mezclan tres fuentes, y conviene separarlas en tres montones: el fabricante, con la system card y el anuncio de Anthropic; Artificial Analysis, que mide por su cuenta; y Cursor y Proximal, cuyas cifras llegan publicadas en la system card. Los tres ponen a Opus 5.5 delante de Fable 5.1, pero no por el mismo margen. Fuera de Anthropic, en cambio, Gemini 4 Carbon ya supera a Opus 5.5 a máximo en el índice v5.
Empiezo por el independiente: en la versión 5 del índice de Artificial Analysis, tope contra tope, Opus 5.5 marca 58,4 y Fable 5.1, 49,0: 9,4 puntos más, y la tarea un 23,0% más barata, 9,02 € frente a 11,71 €. Opus 5.5 va de 34,5 a 58,4, 23,9 puntos de punta a punta; Fable 5.1 arranca más alto, en 38,5, y solo llega a 49,7, en muy alto. En bajo el orden se da la vuelta.
Opus 5.5 va delante desde medio hacia arriba; en bajo manda Fable 5.1
Índice de inteligencia v5 por nivel de esfuerzo. Más alto es mejor. Barras a escala de la mayor, 58,4 puntos. Fuente: Artificial Analysis (artificialanalysis.ai), leído el 28 de octubre de 2026, con un decimal.
Máximo
Muy alto
Alto
Medio
Bajo
Fable 5.1 saca más en muy alto (49,7) que en máximo (49,0). Sonnet 5.5 en máximo (54,2) queda por debajo de Opus 5.5 en muy alto (57,0). En esa lectura, por encima de todos quedaba Gemini 4 Carbon, de Google, con 59,4 a esfuerzo alto; el 9 de noviembre llegó Claude Fable 5.2, con 64,6 a máximo.
Basado en datos de Artificial Analysis, leídos el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Las pruebas que forman el índice: con dato de los dos a máximo y leídas el 22 de septiembre, Opus 5.5 gana en GDPval, Terminal Bench 4.0, Humanity’s Last Exam, SciCode y CritPt, y sobre todo en no alucinar, dentro de AA Omniscience: 0,4139 frente a 0,2742. Fable 5.1 se queda con dos, que cuento más abajo.
- La tabla del fabricante: la 8.1.A de la system card pone a Opus 5.5 delante de Fable 5.1 en todas las filas que traen a los dos. El margen más ancho es Terminal Bench 4.0, 66,4 frente a 55,8, con un error típico de 2,6 puntos para Opus 5.5 y de 1,6 a 2 para los demás: esa distancia sí es ancha. Los más estrechos, OSWorld 2.0 parcial y Humanity’s Last Exam con herramientas, se quedan en 1,1 y 2,1 puntos.
| Evaluación | Claude Opus 5.5 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|---|
| SWE bench Pro | 89,9 | 81,2 | 79,2 |
| SWE bench Multilingual | 93,9 | 89,1 | 89,5 |
| SWE bench Multimodal | 61,4 | 54,7 | 59,4 |
| FrontierCode v1.1 (Main) | 54,4 | 50,3 | 48,0 |
| Terminal Bench 4.0 (Opus 5.5 en muy alto) | 66,4 | 55,8 | 52,3 |
| Terminal Bench Science 0.1 | 58,7 | 52,6 | 29,0 |
| Humanity’s Last Exam, sin herramientas | 64,4 | 60,9 | 56,6 |
| Humanity’s Last Exam, con herramientas | 67,7 | 65,6 | 63,6 |
| OSWorld 2.0, parcial y estricta | 81,8 y 48,7 | 80,7 y 42,8 | 74,0 y 37,2 |
| HealthBench Professional | 65,6 | 62,1 | 59,8 |
| GDPval AA v2.1 (Elo) | 1846 | 1735 | 1708 |
| AA Briefcase v1.1 | 1822 | 1678 | 1673 |
| AutomationBench | 40,0 | 31,4 | 26,9 |
Cifras del fabricante, no independientes: system card de Claude Opus 5.5, tabla 8.1.A (página 174), 22 de septiembre de 2026. Opus 5.5 con pensamiento adaptativo a esfuerzo máximo y media de cinco intentos, salvo Terminal Bench 4.0, en muy alto. Las cifras de los demás modelos salen, según Anthropic, de sus fichas o de los marcadores publicados.
Las filas GDPval AA y AA Briefcase también las publica Anthropic en su system card: no son lecturas nuestras del tablero de Artificial Analysis, y Artificial Analysis no avala este análisis ni es responsable de él.
Y el propio Anthropic rebaja su tabla: en el anuncio escribe que, a este nivel, los márgenes de los benchmarks guían peor las diferencias reales, y que en su uso la distancia entre los dos es más estrecha. Con Gemini 4 Argon pasa algo parecido: a igual esfuerzo Opus 5.5 le saca algo más de un punto en el índice independiente. Y por fuera de Anthropic ya aprieta un modelo abierto.
- CursorBench 4.0, medido por Cursor: Opus 5.5 saca un 57,8% en máximo y Fable 5.1 un 51,8%, a 15,07 € la tarea; Opus 5.5 en alto ya marca un 56,0%, por más o menos la cuarta parte de ese coste. Un matiz: el 52,5% de Opus 5.5 en medio frente al 51,8% de Fable 5.1 lo da el anuncio de Anthropic, no Cursor.
- FrontierSWE v2, de Proximal: 34 tareas de programación muy largas, con su propio arnés y todos los modelos en máximo. Opus 5.5 queda segundo con un 62,3%, detrás de GPT 6 Astra, con un 65,5%, y delante de Fable 5.1, con un 56,3%.
- El hueco: el índice de programación de Artificial Analysis no tenía nota de Opus 5.5 en ningún esfuerzo a 23 de septiembre.
| Prueba | Claude Opus 5.5 | Claude Fable 5.1 | Kimi K3.1 Pro |
|---|---|---|---|
| Terminal Bench 4.0 | 66,4 | 55,8 | 65,7 |
| BenchCAD, con herramientas | 96,2 | 92,6 | 92,7 |
| BenchCAD, sin herramientas | 73,0 | 60,6 | 72,8 |
| Alucinación en Hallu Bench Hard, con herramientas (más bajo es mejor) | 15,0 | 23,3 | 8,3 |
| Índice de Artificial Analysis v5, a esfuerzo máximo | 58,4 | 49,0 | 46,0 |
Kimi K3.1 Pro es el modelo de pesos abiertos que Moonshot AI lanzó el 23 de octubre de 2026. Las cuatro primeras filas son cifras de Moonshot, no verificadas por terceros, salvo el 55,8 de Fable 5.1 en Terminal Bench, de la system card de Anthropic.
Hallu Bench Hard es una prueba interna de Moonshot con preguntas pensadas para pillar al modelo, no la tasa de error del uso diario. La última fila es de Artificial Analysis, versión 5, leída el 28 de octubre, con un decimal. Artificial Analysis no avala este análisis ni es responsable de él.
Claude Opus 5.5 vs Fable 5.1 vs Opus 5 vs Sonnet 5.5
Ahora, los dos junto a Claude Opus 5, el escalón de abajo hasta ahora, los dos Sonnet, Sonnet 5 y Sonnet 5.5, y Haiku 5.5, el más barato de los seis desde el 7 de octubre. Precio y ficha son de Anthropic; índice y coste por tarea, de Artificial Analysis.
| Claude Opus 5.5 | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 | Claude Sonnet 5.5 | Claude Haiku 5.5 | |
|---|---|---|---|---|---|---|
| Estado | actual | actual | heredado, sigue disponible | heredado, sigue disponible | actual | actual |
| Entrada por millón de tokens | 3,49 € | 8,72 € | 4,36 € | 1,74 € | 1,74 € | 0,09 € (0,44 € por encima de 100.000 tokens) |
| Salida por millón de tokens | 17,45 € | 43,62 € | 21,81 € | 8,72 € | 8,72 € | 0,44 € (2,18 € por encima de 100.000 tokens) |
| Lectura de caché por millón | 0,17 € | 0,22 € | 0,44 € | no está en nuestras fuentes | 0,09 € (desde el 7 de octubre) | 0,01 € |
| Esfuerzo por defecto | medio | alto | medio | alto | alto | medio |
| Contexto | 1.000.000 de tokens | 1.000.000 de tokens | 1.000.000 de tokens | no está en nuestras fuentes | 1.000.000 de tokens | 1.000.000 de tokens |
| Índice AA v5 a esfuerzo máximo | 58,4 | 49,0 | Sin nota en la v5 | Sin nota en la v5 | 54,2 | 36,2 |
| Coste por tarea del índice a máximo | 9,02 € | 11,71 € | Sin dato en la v5 | Sin dato en la v5 | 9,00 € | 0,37 € |
| Para qué | la mayoría de cargas, según Anthropic | razonamiento exigente y trabajo agéntico de largo recorrido | lo que aún no has migrado | la misma tarifa que Sonnet 5.5, que lo mejora según Anthropic | tareas acotadas del día a día, según Anthropic | volumen y latencia: clasificar, extraer, enrutar, según Anthropic |
Estado, precios, esfuerzo y contexto: documentación y página de precios de Anthropic, leídas el 22 y el 23 de septiembre de 2026 (Claude Sonnet 5.5, el 28), con los precios convertidos al tipo del BCE del 22 de septiembre de 2026. Índice y coste por tarea: Artificial Analysis (artificialanalysis.ai), versión 5, leída el 28 de octubre de 2026, al tipo del BCE de ese día. La fila Para qué de Opus 5 y Sonnet 5 es criterio nuestro.
Basado en datos de Artificial Analysis (artificialanalysis.ai), leídos el 22, el 23 y el 28 de septiembre y el 18 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Sonnet 5: es la mejor prueba de que la tarifa no es la factura. Por token cuesta la mitad que Opus 5.5, 1,74 € y 8,72 € frente a 3,49 € y 17,45 €, pero en la v4.3, la última que lo midió, a esfuerzo máximo la tarea del índice le salía a 4,44 € y marcaba 38, mientras Opus 5.5 en medio marcaba 51,24 a 1,17 €. Desde la llegada de Sonnet 5.5, Anthropic ya lo lista como heredado.
- Sonnet 5.5: lanzado el 28 de septiembre, lo lleva más lejos. Con la misma tarifa que Sonnet 5, a máximo marca 54,2, por debajo de Opus 5.5 en muy alto, y su tarea cuesta 9,00 €, 1,7 veces los 5,43 € de Opus 5.5. En alto, en cambio, da 41,1 por 1,47 €. Anthropic lo pone para tareas acotadas del día a día y sigue reservando a Opus 5.5 el trabajo complejo.
- Sonnet 5.5 frente a GPT 6.1 Sol: cobran lo mismo, pero la factura por tarea de esos dos no se parece: Sol saca 51,83 a máximo en Artificial Analysis por 0,63 € la tarea.
- Haiku 5.5: llegó el 7 de octubre. Cobra 0,09 € de entrada y 0,44 € de salida por millón con prompts de hasta 100.000 tokens, y 0,44 € y 2,18 € por encima. En el índice marca 43,4 a máximo, por encima de Sonnet 5 y lejos de Opus 5.5. Su coste por tarea no estaba medido el 7 de octubre; el 18, Artificial Analysis ya le ponía 0,18 € a máximo. Anthropic lo pone para volumen y latencia, no para el trabajo complejo.
- Opus 5: tiene poco sentido para trabajo nuevo. Cuesta más que Opus 5.5 en entrada, salida y caché, y el 22 de septiembre marcaba 50,78 a máximo, por debajo de Opus 5.5 en medio. Al día siguiente Artificial Analysis ya lo daba por obsoleto y lo había sacado de su tabla.
Para saber cuándo te basta Haiku 5.5 y cuándo te hace falta el resto de la gama, repasa nuestra guía de modelos.
Qué recomienda Anthropic y dónde sigue ganando Fable 5.1
La documentación de modelos de Anthropic lo dice sin rodeos: si no sabes cuál usar, empieza por Claude Opus 5.5 en la mayoría de las cargas, y usa su gama Fable, desde el 9 de noviembre Fable 5.2, para razonamiento exigente y trabajo agéntico de largo recorrido, o cuando tus pruebas con Opus 5.5 a más esfuerzo se queden cortas. No es un relevo. Yo lo leo como una escalera de tres peldaños:
- Primer peldaño: Opus 5.5 en medio, su ajuste de fábrica.
- Segundo: el mismo Opus 5.5 subiendo a alto, muy alto y máximo, con tus pruebas en cada paso.
- Tercero: Fable 5.2, que desde el 9 de noviembre ocupa el sitio de Fable 5.1. Salvo en razonamiento exigente o trabajo agéntico largo, que Anthropic manda directo ahí, no subes porque el trabajo parezca difícil, sino porque el segundo peldaño ha fallado en algo que puedes enseñar.
Hay además una razón técnica a favor de ese sentido. En la API de Claude, Fable 5.1 lee los bloques de pensamiento de Opus 5.5, así que si subes a mitad de conversación el razonamiento hecho se conserva. Opus 5.5 no lee los de ningún modelo Fable: si bajas, esos bloques se descartan, la petición sale bien y no se cobran, pero el razonamiento se pierde.
Para los agentes de IA que se pasan trabajo entre modelos, esto pesa mucho. Mi regla: sube por fallos medidos sobre tu propio banco de pruebas, no por una impresión, y no bajes dentro de la misma conversación.
- Donde Fable 5.1 sigue ganando: con datos de los dos, justo en el terreno que Anthropic le reserva. En el índice de Artificial Analysis, a máximo, gana el razonamiento en contexto largo, 0,8533 frente a 0,8467, y el acierto bruto de conocimiento en AA Omniscience, 0,6723 frente a 0,6622. Márgenes pequeños, pero medidos por quien no vende ninguno.
- La letra pequeña del acierto: Fable 5.1 acierta algo más, pero Opus 5.5 alucina bastante menos, 0,4139 frente a 0,2742 en la prueba de no alucinación. La prueba de informes de Anthropic, otra cifra del fabricante, empuja al mismo lado: 16 de 18 informes de Opus 5.5 pasaron su listón de calidad, y ni Fable 5.1 ni Opus 5 lo pasaron en ningún intento. Si tu riesgo es una cifra falsa dicha con aplomo, quédate en Opus 5.5.
- El esfuerzo bajo: aparte queda el bajo, que ya has visto: 4,0 puntos para Fable 5.1, fuera del terreno que Anthropic le reserva.
Qué significa para las empresas españolas
Para una empresa española hay cinco cosas que mirar antes de elegir, y ninguna sale en los benchmarks:
- La moneda: Anthropic cobra en dólares, así que lo que pagas en euros se mueve con el cambio y estas cifras son la foto de un día. Lo que no se mueve es la proporción: Fable 5.1 cuesta dos veces y media lo que Opus 5.5 por token de entrada y de salida, haga lo que haga el euro.
- Dónde se procesan los datos: la API directa de Anthropic solo admite hoy inferencia global, la de por defecto, o en Estados Unidos, que cuesta 1,1 veces la tarifa: no hay opción solo en Europa para ninguno de los dos. Amazon Bedrock tiene puntos de acceso regionales y Google Cloud, multirregionales para estos modelos, los dos con un 10% de recargo, pero no he comprobado qué regiones europeas sirven cada modelo. Eso se mira en cada consola.
- La retención: Anthropic dice que Opus 5.5, como los Opus anteriores, está disponible con retención cero de datos, que no quiere decir que los datos se procesen en Europa. Y la documentación de Claude Code avisa de que, bajo retención cero, algunas organizaciones no pueden usar Fable en Claude Code. Para el encaje legal, empieza por nuestra guía de cumplimiento.
- El plan: Claude Code arranca en Opus 5.5, en esfuerzo medio, en Pro, Max, Team, Enterprise y la API de Anthropic desde la versión 2.1.280, y también en Amazon Bedrock, Google Cloud y Claude Platform on AWS; en Microsoft Foundry arranca en Sonnet 4.5. Ningún modelo Fable es el predeterminado: se elige con
/model fable. En Pro, Fable 5.1 se paga aparte, con créditos de uso de pago por uso, y en una sesión interactiva Claude Code te pide permiso antes; en Max, que entre en el plan depende del plan y del tipo de puesto. - Las salvaguardas: según Anthropic, Opus 5.5 es el primer Opus que sale con salvaguardas de una clase parecida a las de Fable 5.1 en ciberseguridad, biología y destilación, y todas desvían a otro modelo de forma transparente. Un rechazo, además, llega con un HTTP 200 y el motivo de parada refusal, no como error. En una asesoría o gestoría que procesa facturas sin nadie mirando, conviene contar esos rechazos aparte.
Qué nivel de esfuerzo usar y cuándo
Mi punto de partida es el modelo por el que Anthropic aconseja empezar, en su esfuerzo de fábrica: Opus 5.5 en medio. Ojo con la trampa de migración número uno: si cambias Fable 5.1 por Opus 5.5 y tu código no fija el esfuerzo, el nuevo razona menos, porque arranca en medio y no en alto. Fija el esfuerzo a mano.
| Esfuerzo | Índice Opus 5.5 | Tarea Opus 5.5 | Índice Fable 5.1 | Tarea Fable 5.1 | Índice Sonnet 5.5 | Tarea Sonnet 5.5 | Para qué en Opus 5.5 |
|---|---|---|---|---|---|---|---|
| Bajo | 34,5 | 0,88 € | 38,5 | 4,03 € | 25,3 | 0,46 € | tareas acotadas y de mucho volumen; aquí gana Fable 5.1 en nota, así que antes haz tus propias pruebas |
| Medio | 48,1 (por defecto) | 2,20 € | 43,0 | 5,01 € | 30,3 | 0,70 € | el primer peldaño: el modelo que recomienda Anthropic, con su ajuste de fábrica |
| Alto | 51,7 | 3,11 € | 47,0 (por defecto) | 6,79 € | 41,1 (por defecto) | 1,47 € | cuando medio falla en tus pruebas; ya supera al mejor Fable 5.1 |
| Muy alto | 57,0 | 5,43 € | 49,7 | 9,78 € | 49,6 | 3,68 € | si alto no basta; menos de la mitad del coste de Fable 5.1 en máximo |
| Máximo | 58,4 | 9,02 € | 49,0 | 11,71 € | 54,2 | 9,00 € | el último peldaño; cuesta algo menos que Fable 5.1 en muy alto |
Índice de inteligencia v5 y coste por tarea del índice de Artificial Analysis (artificialanalysis.ai), leídos el 28 de octubre de 2026, con el coste convertido al tipo del BCE de ese día. La columna Para qué es criterio nuestro, no de Artificial Analysis ni de Anthropic. El esfuerzo por defecto de Sonnet 5.5 en la API es alto.
Basado en datos de Artificial Analysis (artificialanalysis.ai), leídos el 22, el 23 y el 28 de septiembre y el 18 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
El bajo es la única fila donde gana Fable 5.1: 38,5 frente a 34,5, a unas 4,6 veces el coste por tarea (4,03 € frente a 0,88 €). Pero Opus 5.5 en medio marca 48,1 por 2,20 €, más nota que Fable 5.1 en bajo y por menos dinero. Si pensabas poner Fable 5.1 en bajo para ahorrar en una automatización documental, prueba antes Opus 5.5 en medio.
- Si las pruebas se quedan cortas: subiría a alto antes que cambiar de modelo, porque ahí Opus 5.5 ya supera al mejor Fable 5.1. Muy alto, a 5,43 € la tarea, le saca 8,0 puntos a Fable 5.1 en máximo.
- El máximo: lo dejaría para cuando cada punto cuenta, porque es el salto de coste más grande en euros de la escalera: de 5,43 € a 9,02 €.
- Subir no siempre mejora: en FrontierCode, según Anthropic, el mejor resultado de Opus 5.5 está en medio, un 54,6%, y empeora al subir porque la corrección penaliza los cambios fuera del encargo; Fable 5.1 se queda en un 52,8% en su mejor esfuerzo. El peldaño correcto se mide, no se supone. El detalle de cada escalón, con coste y espera, está en qué nivel de esfuerzo de Claude usar en cada tarea.
- La velocidad, sin cifras: en las lecturas de Artificial Analysis del 22 y del 23 de septiembre, Opus 5.5 sacó la salida más rápido que Fable 5.1 en cada esfuerzo donde los dos estaban medidos. No doy cifras porque se mueven de un día a otro. A máximo, Opus 5.5 entonces no tenía velocidad medida; en la lectura del 18 de octubre ya la tiene, y el orden se mantiene a máximo y en muy alto.
Quien venga de Opus 5 tiene además cuatro cambios que rompen código, y los tres primeros valen también para Fable 5.1:
- El pensamiento: ya no se puede desactivar.
- Las herramientas: forzar su uso da un error 400.
- Los bloques de pensamiento: van atados al modelo.
- El uso del ordenador, solo en Opus 5.5: retira la versión antigua de esa herramienta en la API de Claude y en Google Cloud.
- La vista por defecto: una app que enseña el progreso entre herramientas se queda callada.
- Más pensamiento por turno: Opus 5.5 piensa más por turno que Opus 5 con el mismo esfuerzo, así que Anthropic pide repetir el barrido de esfuerzos y dejar margen en
max_tokens.
Y ahora Claude Fable 5.2: a qué Fable se sube hoy
El 9 de noviembre Anthropic lanzó Claude Fable 5.2, y la pregunta de esta guía cambia de destino: si Opus 5.5 se queda corto, ya no se sube a Fable 5.1. Fable 5.2 cobra 7,15 € y 35,74 € por millón de tokens, menos que Fable 5.1, y Anthropic sigue aconsejando empezar por Opus 5.5.
Fable 5.2 frente a Opus 5.5 y Fable 5.1: nota y coste por tarea
Índice de inteligencia v5, eje de 0 a 100; en cada barra, el coste por tarea en euros. Fuente: Artificial Analysis (artificialanalysis.ai), leído el 9 de noviembre de 2026, convertido al tipo del BCE del 9 de noviembre (1 € = 1,1193 dólares).
El mejor Fable 5.1 de esta lectura es muy alto, 50,0 por 9,69 €. La velocidad de Fable 5.2 aún está sin medir. No se compara con las gráficas del 28 de octubre de esta guía.
Basado en datos de Artificial Analysis, leídos el 9 de noviembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
En la lectura del 9 de noviembre, Fable 5.2 a alto saca 61,8 por 8,11 € la tarea, más nota que Opus 5.5 a máximo, 59,1 por 8,97 €. Y a bajo, 53,9 por 2,77 €, por encima de Opus 5.5 a alto. Fable 5.1 queda por debajo de los dos en cualquier ajuste: su mejor nota es 50,0, a muy alto.
Lo que no cambia: por token, Fable 5.2 cuesta el doble que Opus 5.5, gasta antes el límite de los planes y a máximo la tarea sale a 23,71 €. Mi escalera sigue empezando en Opus 5.5 en medio; lo que cambia es el último peldaño, que ahora es Fable 5.2 a alto. Los cinco esfuerzos están en nuestra guía de niveles de esfuerzo de Claude.
Empieza barato y sube con pruebas
La lectura rápida es que ganó el barato, y en el índice independiente así fue. La útil es otra: el fabricante pone a Opus 5.5 delante y avisa de que la distancia real es menor, Artificial Analysis enseña dos empates que valen dinero y Fable 5.1 conserva dos ventajas pequeñas justo en el terreno que Anthropic le reserva. En la app hay otra pega: entre los planes individuales, Fable solo entra en la cuota de Max.
Si lo montara hoy, cogería un puñado de tareas reales, las pasaría por Opus 5.5 en medio, en alto y en muy alto, y solo entonces probaría Fable 5.2 con las que siguieran fallando. Como en la API de Claude subir a mitad de conversación no borra el razonamiento, no pierdes lo que ya ha pensado. Si prefieres no hacerlo solo, es la revisión que cubre nuestra consultoría de IA.
Ninguna de estas cifras sale de tus documentos ni de tu proceso, y a 23 de septiembre a Opus 5.5 aún le faltaba nota en el índice de programación de Artificial Analysis. Mira la fecha al pie antes de fiarte de estos números. Si quieres que veamos juntos qué cargas tuyas van en cada peldaño, reserva una llamada cuando te venga bien.
Claude Opus 5.5 vs Fable 5.1: preguntas frecuentes
¿Cuánto cuestan Claude Opus 5.5 y Fable 5.1 en euros?
Al tipo del BCE del 22 de septiembre de 2026, Opus 5.5 cuesta 3,49 € por millón de tokens de entrada y 17,45 € por millón de salida; Fable 5.1, 8,72 € y 43,62 €. Leer de caché sale a 0,17 € y 0,22 €. Anthropic cobra en dólares, así que lo que pagas se mueve con el cambio.
¿Cuál de los dos gasta menos por tarea?
Opus 5.5, en cada esfuerzo frente al mismo esfuerzo de Fable 5.1. Según la versión 5 del índice de Artificial Analysis, cada uno en su ajuste de fábrica, Opus 5.5 saca algo más de nota, 48,1 frente a 47,0, y la tarea cuesta 2,20 € con Opus 5.5 y 6,79 € con Fable 5.1. Incluso en bajo, donde Fable 5.1 puntúa más, su tarea cuesta unas 4,6 veces más.
¿Cuál es mejor para programar?
Empieza por Opus 5.5. En las cifras de Anthropic va delante en SWE bench Pro, 89,9 frente a 81,2, y en Terminal Bench 4.0. En CursorBench, medido por Cursor, y en FrontierSWE v2, que midió Proximal, también supera a Fable 5.1. Lo que falta es la nota de Artificial Analysis: su índice de programación aún no ha medido Opus 5.5.
¿Fable 5.1 entra en mi plan de Claude?
Depende del plan. En Max, los modelos Fable entran en el plan hasta la mitad del límite semanal; en Pro se pagan aparte, con créditos de uso, salvo en la semana de lanzamiento de Fable 5.2, del 9 al 16 de noviembre. Según la documentación de Claude Code, en las sesiones interactivas te pide permiso antes de tirar de esos créditos.
¿Claude Opus 5.5 sustituye a Fable 5.1?
No. Anthropic recomienda empezar por Opus 5.5 en la mayoría de las cargas y reserva su gama Fable para el razonamiento exigente y el trabajo agéntico largo. Desde el 9 de noviembre, el Fable de cabeza es Fable 5.2, más barato por token que Fable 5.1, que sigue en la tabla de modelos actuales, con retirada no antes del 1 de septiembre de 2027.
¿Merece la pena Claude Fable 5.2 frente a Opus 5.5?
Para el día a día, no: Anthropic sigue aconsejando Opus 5.5, y Fable 5.2 cobra el doble por token. Para lo que Opus 5.5 no resuelve, sí: según Artificial Analysis, Fable 5.2 a alto saca 61,8 por 8,11 € la tarea, más que Opus 5.5 a máximo, 59,1 por 8,97 €.
¿Qué modelo usa Claude Code por defecto?
Claude Opus 5.5, en esfuerzo medio, en Pro, Max, Team, Enterprise y la API de Anthropic; necesita la versión 2.1.280 de Claude Code o una posterior. En Microsoft Foundry el predeterminado es Sonnet 4.5. Ningún modelo Fable es el predeterminado en ningún plan ni proveedor, así que Fable 5.1 hay que elegirlo a mano.
¿Qué cambia en la API al pasar a Opus 5.5?
El pensamiento ya no se desactiva: pedirlo apagado o fijar un presupuesto manual da un error 400, igual que forzar el uso de herramientas. Los bloques de pensamiento van atados al modelo y, en la API de Claude y en Google Cloud, cambia la versión de la herramienta de uso del ordenador. Y el esfuerzo por defecto baja a medio: vuelve a probar los niveles.
¿Sigue disponible Claude Opus 5?
Sí, como modelo heredado. Pero cuesta más que Opus 5.5 en entrada, salida y caché, 4,36 € y 21,81 € por millón, y en la v4.3 del índice de Artificial Analysis, el 22 de septiembre, marcaba 50,78 a máximo, frente a 57,62 de Opus 5.5; la versión 5 ya no lo mide. Anthropic calcula que, en cargas típicas, ejecutar Opus 5.5 cuesta un 40% menos que ejecutar Opus 5.
Última actualización: 9 de noviembre de 2026
- Anthropic, ficha de Claude Opus 5.5: tabla comparativa de contexto, salida máxima, precio, latencia según Anthropic, pensamiento, esfuerzo por defecto y corte de conocimiento de Opus 5.5, Fable 5.1 y Sonnet 5. Leída el 22 de septiembre de 2026.
- Anthropic, novedades de Claude Opus 5.5: los cuatro cambios que rompen código, los bloques de pensamiento entre modelos, el esfuerzo por defecto, el barrido de esfuerzos y los rechazos con HTTP 200. Leída el 22 de septiembre de 2026.
- Anthropic, documentación de modelos: la recomendación de empezar por Opus 5.5, las descripciones de cada modelo, las listas de modelos actuales y heredados y las fechas de retirada. Leída el 22 de septiembre de 2026; la ficha de Claude Sonnet 5.5 (contexto y esfuerzo por defecto), el 28, y la de Claude Haiku 5.5, el 7 de octubre.
- Anthropic, precios de la API: tarifas de entrada, salida, caché y lotes, la nota de que todos los precios y pagos son en dólares, la ausencia de recargo por contexto largo y el recargo del 10% de los puntos de acceso regionales de Amazon Bedrock y Google Cloud. Leída el 22 y el 23 de septiembre de 2026; Claude Haiku 5.5 y la lectura de caché de Sonnet 5.5 a 0,10 dólares, el 7 de octubre.
- Anthropic, residencia de datos: las opciones de inferencia global y en Estados Unidos, su recargo de 1,1 veces. Leída el 23 de septiembre de 2026.
- Anthropic, system card de Claude Opus 5.5: la tabla 8.1.A (página 174), FrontierCode, FrontierSWE v2 de Proximal y CursorBench 4.0 de Cursor. 22 de septiembre de 2026.
- Anthropic, anuncio de Claude Opus 5.5: el 40% frente a Opus 5, la caché como mayor parte del coste, HAProxy, CursorBench en medio, la prueba de informes, salvaguardas, retención cero y la llegada de Sonnet 5.5 y Haiku 5.5. 22 de septiembre de 2026.
- Anthropic, anuncio de Claude Sonnet 5.5: la tarifa, igual que Sonnet 5, el 30% más rápido y hasta un 30% menos por tarea, y Opus 5.5 para el trabajo complejo. 28 de septiembre de 2026.
- Anthropic, anuncio de Claude Haiku 5.5: precio con el tramo por encima de 100.000 tokens, uso previsto y la rebaja de la lectura de caché de Sonnet 5.5. 7 de octubre de 2026.
- Claude Code, configuración de modelos: el modelo por defecto en cada plan y proveedor, la versión 2.1.280, Fable fuera de los predeterminados, los créditos de uso y el aviso sobre retención cero. Leída el 23 de septiembre de 2026.
- Claude, modelos Fable en tu plan: Fable 5 y 5.1 sobre créditos de uso en Pro y como parte estándar del plan en Max. Leída el 23 de septiembre de 2026.
- Anthropic, anuncio de Claude Fable 5.2: lanzamiento del 9 de noviembre de 2026, tarifa de 8 y 40 dólares por millón de tokens y Opus 5.5 como punto de partida para la mayoría de cargas.
- Claude, ofertas de lanzamiento de Fable 5.2: Fable incluido en Pro y en los asientos estándar de Team del 9 al 16 de noviembre de 2026. Leída el 9 de noviembre de 2026.
- Anthropic, retirada de modelos: Fable 5.1 activo, con retirada no antes del 1 de septiembre de 2027. Leída el 9 de noviembre de 2026.
- Fuente: Artificial Analysis (artificialanalysis.ai): índice de inteligencia v5 y coste por tarea por nivel de esfuerzo de Claude Opus 5.5, Fable 5.1, Sonnet 5.5 y Haiku 5.5, Kimi K3.1 Pro a máximo y Gemini 4 Carbon a alto, leídos el 28 de octubre de 2026, al tipo del BCE de ese día, 1 euro por 1,1133 dólares. Las cifras de Claude Opus 5 y Sonnet 5 son de la v4.3, del 22 y el 23 de septiembre, la última que los midió. Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
- Google, anuncio de Gemini 4 Carbon: 28 de octubre de 2026; su modelo más potente, primero para un grupo de ciberdefensores y después para los socios del programa Fairwind, sin fecha para el resto.
- Data API de Artificial Analysis: el índice de programación, sin medir para Claude Opus 5.5 en ningún esfuerzo. Leída el 23 de septiembre de 2026.
- Banco Central Europeo, tipo de cambio de referencia: 1 euro = 1,1463 dólares estadounidenses el 22 de septiembre de 2026, usado en todas las conversiones de esta guía.
- Artificial Analysis, lectura del 9 de noviembre: índice v5 y coste por tarea de Claude Fable 5.2 (64,6, 61,8 y 53,9 a máximo, alto y bajo), Opus 5.5 (59,1 y 51,8) y Fable 5.1 (49,2 y 50,0), convertidos al tipo del BCE del 9 de noviembre de 2026, 1 euro = 1,1193 dólares. Artificial Analysis no avala este análisis ni es responsable de él.
- OpenAI, anuncio de GPT 6.1 Sol: versión mejorada de GPT 6 Sol con la tarifa de 2 y 10 dólares por millón de tokens, disponible en ChatGPT Work y Codex para los planes de pago y todavía no en el chat, 29 de septiembre de 2026.
- Anthropic, documentación de modelos, releída: la misma recomendación de empezar por Opus 5.5, Sonnet 5 en la lista de heredados y las tarifas de Opus 5.5 y Fable 5.1 sin cambios. Leída el 19 de octubre de 2026.
- Anthropic, precios de la API, releída: puntos de acceso regionales en Amazon Bedrock y multirregionales en Google Cloud para estos modelos, con un 10% de recargo. Leída el 19 de octubre de 2026.
- Claude Code, configuración de modelos, releída: Opus 5.5 por defecto también en Amazon Bedrock, Google Cloud y Claude Platform on AWS, y Sonnet 4.5 en Microsoft Foundry. Leída el 19 de octubre de 2026.
- Artificial Analysis, tablero de modelos: Opus 5.5 a máximo primero con 58 y Fable 5.1 con 53, en enteros, el coste por tarea de Haiku 5.5 a máximo y la velocidad de Opus 5.5 a máximo. Leído el 18 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Moonshot AI, anuncio de Kimi K3.1 Pro: modelo de pesos abiertos con pesos completos antes del 4 de noviembre, y sus cifras en Terminal Bench 4.0, BenchCAD y Hallu Bench Hard frente a Opus 5.5 y Fable 5.1, que Moonshot toma de la system card de Anthropic. 23 de octubre de 2026.
- Artificial Analysis, ficha de Kimi K3.1 Pro: 55,1 en el índice v4.3, leída el 23 de octubre de 2026, y 46,0 en la versión 5, leída el 28 de octubre. Artificial Analysis no avala este análisis ni es responsable de él.