En seis días de septiembre de 2026 salieron los dos modelos más capaces del momento: Claude Fable 5.1 el día 1 y GPT 6 Astra el día 3. Cuestan lo mismo de lista, caben lo mismo en contexto y sacan casi la misma nota. El 22 de septiembre Claude Opus 5.5 los adelantó a los dos en el índice de Artificial Analysis, pero entre ellos la pregunta útil sigue sin ser cuál gana, porque en lo medible empatan.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y la pregunta que me llega no es esa. Es cuánto va a costar la factura a final de mes. Ahí sí hay diferencia, y es grande: uno hace el mismo trabajo con la mitad de los tokens.
Hay una segunda historia debajo, y conviene contarla antes que los números. La cifra que más se repetía sobre Fable 5.1, un 81,2% en SWE bench Pro, circuló dos semanas sin fuente hasta que Anthropic la publicó el 22 de septiembre, y de Astra sigue sin haber ninguna. Si vienes de la comparativa de la generación anterior, esto es lo que ha cambiado.
Qué son GPT 6 Astra y Claude Fable 5.1
Los dos son el tope de gama de su casa. Google tiene el suyo, Gemini 4 Argon, que a igual esfuerzo puntúa más que Astra pero aún no se vende. Astra sube a 1.050.000 tokens de contexto y 128.000 de salida máxima, con el conocimiento cortado el 30 de abril de 2026. Fable 5.1 se queda en 1.000.000 de contexto y los mismos 128.000 de salida, pero con el corte en junio de 2026, dos meses más fresco.
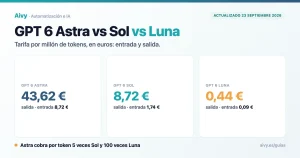
El precio de lista es idéntico: 8,72 € de entrada y 43,62 € de salida por millón de tokens en los dos. Es la primera vez que los dos buques insignia coinciden al céntimo. Lo contamos el día del lanzamiento en la ficha de Astra y en la de Claude Fable 5.1.
| Ficha | GPT 6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Claude Sonnet 5.5 | GPT 6.1 Sol | GPT 6 Luna |
|---|---|---|---|---|---|---|
| Fabricante | OpenAI | Anthropic | Anthropic | Anthropic | OpenAI | OpenAI |
| Ventana de contexto | 1.050.000 tokens | 1.000.000 tokens | 1.000.000 tokens | 1.000.000 tokens | 1.050.000 tokens | 1.050.000 tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens | 128.000 tokens | 128.000 tokens | 128.000 tokens | 128.000 tokens |
| Corte de conocimiento | 30 de abril de 2026 | junio de 2026 | junio de 2026 | junio de 2026 | 30 de abril de 2026 | 18 de mayo de 2026 |
| Precio de lista por millón | 8,72 € entrada · 43,62 € salida | 8,72 € entrada · 43,62 € salida | 3,49 € entrada · 17,45 € salida | 1,74 € entrada · 8,72 € salida | 1,74 € entrada · 8,72 € salida | 0,09 € entrada · 0,44 € salida |
| Índice de inteligencia AA v4.3 | 52,7 | 53,4 | 57,6, primero | 56,0 | 51,8 | 37,3 |
Fichas de las documentaciones de OpenAI y Anthropic. Índice de Artificial Analysis (artificialanalysis.ai), versión v4.3, leído el 23 de septiembre de 2026 (Claude Sonnet 5.5, el 28, y GPT 6.1 Sol, con su ficha, el 29), cada modelo a su esfuerzo máximo. Precios convertidos al tipo del BCE del 22 de septiembre de 2026.
Basado en datos de Artificial Analysis, leídos el 23 y el 28 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
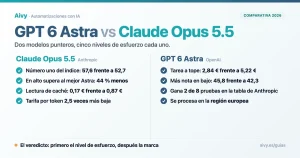
Desde el 22 de septiembre de 2026 Anthropic ofrece además Claude Opus 5.5, a 3,49 € y 17,45 € por millón de tokens al tipo del BCE del 22 de septiembre, y su documentación recomienda empezar por ahí en la mayoría de cargas. Google le ha respondido con Gemini 4 Argon, aunque a igual esfuerzo Opus 5.5 gasta menos por tarea y es el único de los dos que se puede contratar.
Desde el 22 de septiembre de 2026 OpenAI ofrece además GPT 6 Sol, a 1,74 € y 8,72 € por millón de tokens, para código y agentes, y GPT 6 Luna, a 0,09 € y 0,44 €, para tareas acotadas de gran volumen, al tipo del BCE del 22 de septiembre.
Y el 29 de septiembre lanzó GPT 6.1 Sol, que en estas tablas ocupa el sitio de GPT 6 Sol con la misma tarifa. Según OpenAI, casi iguala a Astra en programación con agentes, uso del ordenador y trabajo profesional por la quinta parte de su precio. En el índice de Artificial Analysis marca 51,8, a menos de un punto de Astra y a punto y medio de Fable 5.1.
El empate de Terminal Bench: la puntuación y lo que cuesta cada punto
Terminal Bench 4.0 es de las pocas pruebas donde los dos modelos están medidos por un tercero, el Laude Institute con Stanford, y con el mismo andamiaje para todos. Astra marca 58,2% y Fable 5.1 marca 57,9%. Tres décimas. Los márgenes de error son de 2,8 y 3,8 puntos, así que los intervalos se solapan casi enteros: es un empate estadístico, no una victoria.
Lo interesante está en la letra pequeña de la misma tabla, que publica también los tokens y el coste de esa corrida. Astra llega a su 58,2% con 1.500 millones de tokens y 2.839 €. Fable 5.1 llega a su 57,9% con 2.700 millones y 5.335 €. Mismo resultado, casi el doble de gasto.
Terminal Bench 4.0: tareas resueltas
Más alto es mejor, eje 0 a 100%. Cada modelo en su esfuerzo máximo y con su propio agente. Fuente: leaderboard oficial de Terminal Bench, consultado el 7 de septiembre de 2026.
Márgenes del 95%: Astra 55,4 a 61,0 · Fable 5.1 54,1 a 61,7. Se solapan, así que la diferencia de 0,3 puntos no distingue a un modelo del otro.
Consultado de nuevo el 23 de septiembre de 2026: Claude Opus 5.5, GPT 6 Sol y GPT 6 Luna aún no figuran en este leaderboard. Anthropic publica para Opus 5.5 un 66,4% con su propio arnés y esfuerzo muy alto, una medida que no es comparable con esta tabla.
SWE bench: solo hay cifra oficial para Fable 5.1
Aquí está la sorpresa. La prueba que todo el mundo cita para programación, SWE bench, no apareció en el anuncio de ninguno de los dos. OpenAI presentó su tabla de código con Terminal Bench 4.0, DeepSWE y FrontierCode, y sigue sin dar SWE bench de Astra. Anthropic presentó la suya con Terminal Bench, OSWorld, CursorBench y AutomationBench, y no publicó el SWE bench Pro de Fable 5.1 hasta el 22 de septiembre.
Tampoco estaban en el marcador oficial. Cuando consultamos el leaderboard de SWE bench Pro que mantiene Scale AI, el 7 de septiembre, no figuraba ninguno de los dos, y el mejor Claude que sí aparecía se quedaba en 51,9%. El repositorio oficial de envíos verificados no tiene un solo modelo puntero de 2026: los últimos envíos son de junio de 2025.
Y hay una razón de fondo. El propio OpenAI auditó SWE bench Pro en julio de 2026 y retiró su recomendación de usarlo: estima que alrededor del 30% de las tareas están rotas. Lo comprobó con un filtro automático, una auditoría asistida y una campaña de anotación con ingenieros. Es el mismo camino que ya recorrió con SWE bench Verified.
La cifra que circulaba sin fuente, y que ahora la tiene
A principios de septiembre, cualquier comparativa de Fable 5.1 traía un 81,2% en SWE bench Pro presentado como primer puesto absoluto. No estaba en el anuncio de Anthropic, y las cuatro webs que se lo atribuían a la ficha técnica del modelo no enlazaban la página concreta. Por eso aquí no lo dimos como dato.
El 22 de septiembre Anthropic lo publicó por fin, en la tabla de resumen de la system card de Claude Opus 5.5: 81,2% para Fable 5.1, 79,2% para Claude Opus 5 y 89,9% para Opus 5.5. La cifra era buena; lo que faltaba era la fuente. Sigue siendo una nota del fabricante con su propio arnés, y de Astra esa fila no trae ninguna.
Hay algo peor circulando. Parte de la cobertura le adjudica a Fable 5.1 un 95,0% en SWE bench Verified y un 80,0% en Pro. Esas cifras son de Claude Fable 5, el modelo de junio, reetiquetadas. Un agregador que recopila 113 resultados de SWE bench Verified lo dice en su propia cabecera: verificados por terceros, cero.
La lección práctica es la de siempre en este oficio, y la aplicamos igual cuando montamos una consultoría de IA: antes de creerte una cifra, mira quién la midió y con qué andamiaje. Una nota del fabricante no es una nota independiente, aunque la repitan veinte medios.
Eficiencia de tokens: el mismo resultado con 2,6 veces menos
Este es el dato que cambia la factura. Artificial Analysis mide, además de la nota, cuántos tokens de salida gasta cada modelo por tarea. En Terminal Bench v2.1, Astra con esfuerzo alto saca 89,9% gastando 5.787 tokens de salida por tarea. Fable 5.1 con esfuerzo alto saca el mismo 89,9% gastando 15.161. Son los totales de la corrida repartidos entre las 89 tareas de la prueba.
Misma nota y misma tarifa por token, pero 2,6 veces más tokens. Como los dos cobran 43,62 € por millón de salida, esa diferencia va entera a la factura. En un flujo que procese unos cientos de tareas al día, es la diferencia entre una automatización que sale a cuenta y otra que no.
Tokens de salida por tarea, para la misma nota
Los dos marcan 89,9% en Terminal Bench v2.1 con esfuerzo alto. Barras a escala del mayor. Fuente: Artificial Analysis, consultado el 7 de septiembre de 2026.
2,6 veces más tokens de salida para exactamente la misma puntuación.
Claude Opus 5.5, GPT 6 Sol y GPT 6 Luna no tienen medida de Terminal Bench v2.1 en Artificial Analysis a 23 de septiembre de 2026.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
El patrón se repite donde se mire. En el índice de programación de Artificial Analysis, Fable 5.1 saca 81,6 puntos y Astra 76,9: gana Fable por 4,7 puntos. Pero la tarea le cuesta 6,66 € frente a 2,84 €. Traducido a coste por punto, Astra sale un 55% más barato. Si te interesa el detalle de la gama Claude, lo desglosamos en qué modelo de Claude usar.
Coste por punto de capacidad
Euros por punto del índice de programación: coste por tarea del índice de inteligencia entre la nota de programación, a esfuerzo máximo. Más bajo es mejor. Barras a escala del mayor. Fuente: Artificial Analysis (artificialanalysis.ai), tablero y Data API leídos el 23 de septiembre de 2026, al tipo del BCE del 22 de septiembre. Claude Opus 5.5, GPT 6 Sol y GPT 6 Luna aún no tienen índice de programación.
Basado en datos de Artificial Analysis, leídos el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Los tres índices de Artificial Analysis, y dónde se abre el hueco
Artificial Analysis no publica un índice, publica tres: inteligencia general, programación y trabajo agéntico. Fable 5.1 le gana a Astra los tres a esfuerzo máximo, pero el margen no es igual: en inteligencia general son 0,7 puntos, en programación 4,7 y en agéntico 6,6. Ese último es el que importa si vas a meter el modelo dentro de un agente que trabaja solo. Y en inteligencia general los dos quedan ya por debajo de Claude Opus 5.5, con 57,6.
Los tres índices, a esfuerzo máximo
Más alto es mejor, eje 0 a 100. Fuente: Artificial Analysis (artificialanalysis.ai). Inteligencia general, índice v4.3 leído el 23 de septiembre de 2026; programación, Data API del mismo día; trabajo agéntico, Data API del 8 de septiembre, que ya no lo sirve. Opus 5.5, Sonnet 5.5, GPT 6.1 Sol y Luna no tienen aún nota de programación ni de trabajo agéntico. Claude Sonnet 5.5, inteligencia general leída el 28 de septiembre, y GPT 6.1 Sol, el 29.
Basado en datos de Artificial Analysis, leídos el 23, el 28 y el 29 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Ahora el dial del esfuerzo, que es donde se decide el dinero. Astra en esfuerzo muy alto marca 52,4 y la tarea le sale a 2,01 €. Fable 5.1 en máximo marca 53,4 y la tarea le sale a 6,66 €. Son 3,3 veces más dinero por un punto. Y Claude Opus 5.5 en esfuerzo alto marca 53,6, más que los dos, por 1,59 €. Casi nadie hace esa cuenta antes de elegir el escalón de arriba.
Coste por tarea, escalón por escalón
Euros por tarea del índice de inteligencia. Más bajo es mejor. Barras a escala de la mayor. Fuente: Artificial Analysis (artificialanalysis.ai), índice v4.3 leído el 23 de septiembre de 2026 (Sonnet 5.5, el 28, y GPT 6.1 Sol, el 29), al tipo del BCE del 22 de septiembre.
Basado en datos de Artificial Analysis, leídos el 23, el 28 y el 29 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Y hay una tercera variable que casi nadie mira: lo que tardan en soltar la primera palabra. A esfuerzo máximo los dos son lentos de verdad, 311,5 segundos Fable 5.1 y 342,3 Astra. Bajando Fable 5.1 a esfuerzo medio, la espera cae a 10,1 segundos. Treinta veces menos, el mismo modelo, cuatro puntos menos de índice.
Segundos hasta la primera palabra
Mediana. Más bajo es mejor. Barras a escala de la mayor. Fuente: Artificial Analysis (artificialanalysis.ai), tablero leído el 23 de septiembre de 2026. Claude Opus 5.5 a esfuerzo máximo, sin medir.
Basado en datos de Artificial Analysis, leídos el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Y ahora la línea que le da la vuelta a todo lo anterior, y que es la única de las dos tarifas donde no empatan: leer de caché cuesta 0,22 € por millón con Fable 5.1 y 0,87 € con Astra. Cuatro veces más. Claude Opus 5.5 y Claude Sonnet 5.5 la dejan en 0,17 €. Si tu carga relee el mismo contexto una y otra vez, un agente que recarga el repositorio o una herramienta documental que consulta el mismo expediente, ahí Astra pierde buena parte de su ventaja.
Precios y coste por tarea para una empresa española
Aquí hay una pega que casi nadie menciona y que sí importa desde Madrid o Barcelona: ninguno de los dos fabricantes publica precios en euros. Anthropic lo dice en la cabecera de su página de tarifas, todos los precios en dólares, y en la de facturación, todos los pagos en dólares. OpenAI hace lo mismo. No hay lista europea ni tarifa regional.
Eso significa que lo que paga una empresa española se mueve con el cambio, y que el presupuesto de un proyecto largo se hace sobre una moneda que no controlas. Cuando dimensionamos un proyecto de automatización documental lo dejamos escrito en el contrato, porque a doce meses vista la diferencia se nota.
| Por millón de tokens | GPT 6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Claude Sonnet 5.5 | GPT 6.1 Sol | GPT 6 Luna |
|---|---|---|---|---|---|---|
| Entrada | 8,72 € | 8,72 € | 3,49 € | 1,74 € | 1,74 € | 0,09 € |
| Salida | 43,62 € | 43,62 € | 17,45 € | 8,72 € | 8,72 € | 0,44 € |
| Entrada cacheada | 0,87 € | 0,22 €, cuatro veces menos | 0,09 € | 0,17 € | 0,17 € | 0,01 € |
| Peticiones de más de 272.000 tokens | 17,45 € entrada y 65,43 € salida | sin tramo | sin tramo | sin tramo | 3,49 € entrada y 13,09 € salida | 0,17 € entrada y 0,65 € salida |
| Moneda de facturación | dólares | dólares | dólares | dólares | dólares | dólares |
Precios de lista de las documentaciones de OpenAI y Anthropic; GPT 6.1 Sol, leído el 29 de septiembre. Convertidos al tipo del BCE del 22 de septiembre de 2026, 1 EUR = 1,1463 USD.
El tramo de los 272.000 tokens de Astra
Astra tiene una cláusula que no aparece en ninguna tabla comparativa y que puede doblar la factura sin avisar. Cuando una petición supera los 272.000 tokens de entrada, esa petición entera se factura al doble en entrada y a una vez y media en salida. No es solo el exceso: es toda la llamada, desde el primer token.
Desde el 22 de septiembre GPT 6 Sol y GPT 6 Luna llevan la misma cláusula, y GPT 6.1 Sol desde el 29, y en la generación 6 el tramo dobla también la lectura de caché. Claude Opus 5.5 y Claude Sonnet 5.5, como Fable 5.1, cobran la ventana entera a la tarifa normal.
En euros son 17,45 € de entrada y 65,43 € de salida por millón, frente a los 8,72 € y 43,62 € habituales. Con una ventana de 1.050.000 tokens, el tramo se cruza antes de lo que parece: un expediente completo, un repositorio mediano o una conversación larga con documentos adjuntos lo pasan sin esfuerzo.
La consecuencia práctica es de diseño, no de precio. Si vas a meter documentos grandes, conviene trocear y recuperar solo lo que hace falta en vez de volcarlo todo. Es lo que hacemos en los proyectos de automatización contable, donde el volumen de entrada es lo que dispara el coste.
Qué recomienda cada fabricante, que no es lo que parece
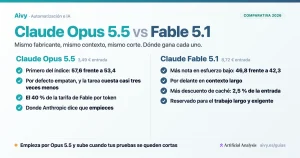
Anthropic dice algo que sorprende viniendo de quien vende el modelo más caro: para la mayoría de las cargas, empieza por Claude Opus 5.5, que salió el 22 de septiembre. Reserva Fable 5.1 para el razonamiento exigente y el trabajo agéntico largo, o para cuando tus propias pruebas con Opus 5.5 a más esfuerzo se queden cortas.
Es un consejo honesto y encaja con los números. En el índice v4.3, Opus 5.5 marca 57,6 a esfuerzo máximo contra los 53,4 de Fable 5.1, y la tarea le cuesta 5,22 € frente a 6,66 €. A esfuerzo alto baja a 1,59 € y sigue por encima de Fable 5.1. Lo comparamos a fondo en Opus 5 frente a Fable 5.
El 28 de septiembre Anthropic añadió Claude Sonnet 5.5, a 1,74 € y 8,72 €, una quinta parte de la tarifa de Fable 5.1 y de Astra. En el índice marca 56,0 a máximo, por encima de los dos, pero su tarea cuesta 6,63 €: casi lo mismo que Fable 5.1 al máximo y más del doble que Astra. Anthropic lo pone para tareas acotadas del día a día, no para el trabajo complejo.
Del lado de OpenAI el patrón es parecido. En sus propias mediciones de eficiencia, Astra en esfuerzo alto rinde igual que en máximo gastando bastante menos, así que el peldaño de arriba tampoco se paga solo. La regla que aplicamos con clientes es sencilla: sube de escalón solo cuando una prueba tuya lo justifique, nunca por defecto.
Qué modelo elegiría para un proyecto de cliente
Con lo que hay medido hoy, para automatización en producción empezaría por Astra. Empata en la única prueba independiente con andamiaje común, gasta 2,6 veces menos tokens para la misma nota y sale un 55% más barato por punto de capacidad. En cargas de volumen esa diferencia decide si el proyecto sale a cuenta. Para el trabajo sensible que no compensa mandar fuera, la comparación cambia con los modelos abiertos que puedes alojar tú.
Iría a Fable 5.1 en dos casos. Cuando el trabajo es de razonamiento largo y una prueba propia demuestre que Astra se queda corto, y cuando el corte de conocimiento de junio importe frente al de abril. Para todo lo demás, la recomendación del propio Anthropic de empezar por Opus 5.5 sigue siendo la más sensata.
Y una advertencia que vale más que cualquier benchmark: mide tú. Ninguna de estas cifras se ha corrido sobre tus documentos, tu idioma ni tu proceso. En las asesorías con las que trabajamos el orden de los modelos cambia en cuanto entran facturas reales. Si quieres que lo veamos sobre tu caso, reserva una llamada corta y lo miramos juntos.
Preguntas frecuentes sobre GPT 6 Astra y Claude Fable 5.1
¿Cuál es mejor, GPT 6 Astra o Claude Fable 5.1?
Depende de lo que midas. Fable 5.1 gana los tres índices de Artificial Analysis, pero por poco en inteligencia general, 53,4 frente a 52,7, y por más en trabajo agéntico, 58,2 frente a 51,6. En Terminal Bench 4.0 empatan dentro del margen de error. Pero Astra llega a esos resultados con menos tokens y menos coste, así que por capacidad comprada gana Astra.
¿Cuánto cuesta cada uno para una empresa española?
Los dos cuestan lo mismo de lista: 8,72 € de entrada y 43,62 € de salida por millón de tokens. Ninguno publica precios en euros, así que ambos facturan en dólares y lo que pagas se mueve con el cambio. La diferencia real de coste no está en la tarifa, está en cuántos tokens gasta cada uno.
¿Se puede usar ya GPT 6 Astra?
Sí. OpenAI lo presentó el 3 de septiembre de 2026 y abrió el acceso a todo el mundo al día siguiente. Está disponible por API en los puntos de acceso de respuestas, chat y lotes. No admite ajuste fino, incrustaciones, generación de imágenes ni voz en tiempo real. Y OpenAI está cerrando su plataforma de ajuste fino: no admite cuentas nuevas desde mayo y dejará de entrenar el 6 de enero de 2027.
¿Cuál gasta menos tokens?
Astra, con diferencia. En Terminal Bench v2.1 medido por Artificial Analysis, los dos sacan 89,9% con esfuerzo alto, pero Astra gasta 5.787 tokens de salida por tarea y Fable 5.1 gasta 15.161. Son 2,6 veces más para el mismo resultado, y a la misma tarifa por token eso va entero a la factura.
¿Hay cifras de SWE bench de estos modelos?
Solo de uno. Anthropic publicó el 22 de septiembre de 2026 el 81,2% de Fable 5.1 en SWE bench Pro, en la system card de Claude Opus 5.5. De Astra no hay cifra: el anuncio de OpenAI no incluye SWE bench. El propio OpenAI auditó SWE bench Pro en julio de 2026 y retiró su recomendación: estima que cerca del 30% de las tareas están rotas.
¿Es cierto que Fable 5.1 saca 81,2% en SWE bench Pro?
Sí. Anthropic lo publicó el 22 de septiembre de 2026 en la tabla de resumen de la system card de Claude Opus 5.5: 81,2% para Fable 5.1, 79,2% para Claude Opus 5 y 89,9% para Opus 5.5. Es una cifra del fabricante con su propio arnés, no una medición independiente, y OpenAI sigue sin publicar SWE bench para Astra.
¿Qué es el tramo de los 272.000 tokens?
Es la cláusula de precio de Astra, y GPT 6 Sol, GPT 6.1 Sol y GPT 6 Luna la tienen igual. Si una petición supera los 272.000 tokens de entrada, esa petición completa se cobra al doble en entrada y a una vez y media en salida, no solo la parte que se pasa. Con documentos grandes conviene trocear la entrada en lugar de volcarla entera.
¿Cuál elijo para una pyme?
Para automatización en producción, Astra por coste por resultado. Para razonamiento largo donde tus propias pruebas demuestren que hace falta, Fable 5.1. Y antes de decidir, mira Claude Opus 5.5, que salió el 22 de septiembre de 2026: es lo que recomienda hoy el propio Anthropic como punto de partida y cuesta bastante menos que su buque insignia.
Última actualización: 22 de octubre de 2026
- Terminal Bench, leaderboard oficial: puntuación, tokens y coste de la misma corrida para Astra y Fable 5.1 en la versión 4.0. Alojado por el Laude Institute con Stanford. Consultado el 7 de septiembre y de nuevo el 23 de septiembre de 2026, cuando Claude Opus 5.5, GPT 6 Sol y GPT 6 Luna aún no figuraban.
- Artificial Analysis, Terminal Bench v2.1: el 89,9% de los dos y los tokens de salida de cada corrida, que dividimos entre las 89 tareas de la prueba. Consultado el 8 de septiembre de 2026.
- Data API de Artificial Analysis: índice de programación, leído el 23 de septiembre de 2026, y el de trabajo agéntico, del 8 de septiembre.
- Fuente: Artificial Analysis (artificialanalysis.ai): índice de inteligencia v4.3, coste por tarea y latencias del tablero público, leído el 23 de septiembre de 2026 (Claude Sonnet 5.5, el 28, y GPT 6.1 Sol, el 29). Basado en datos de Artificial Analysis, leídos el 23, el 28 y el 29 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Anthropic, system card de Claude Opus 5.5: el 66,4% de Opus 5.5 en Terminal Bench 4.0 con su propio arnés y esfuerzo muy alto, y la tabla 8.1.A (página 174) con el SWE bench Pro de Opus 5.5, Opus 5 y Fable 5.1. 22 de septiembre de 2026.
- OpenAI, fichas de GPT 6 Sol y GPT 6 Luna: contexto, salida máxima, corte de conocimiento, precios y el mismo tramo de 272.000 tokens. Leídas el 22 de septiembre de 2026.
- OpenAI, anuncio de GPT 6.1 Sol, y su ficha: casi el nivel de Astra por la quinta parte de su tarifa, según OpenAI, 1.050.000 tokens de contexto, corte de conocimiento del 30 de abril de 2026, precios y caché a 0,10 dólares. 29 de septiembre de 2026.
- Scale AI, leaderboard de SWE bench Pro: el marcador oficial donde no aparece ninguno de los dos modelos. Consultado el 7 de septiembre de 2026.
- SWE bench, repositorio de envíos verificados: sin ningún modelo puntero de 2026. Consultado el 7 de septiembre de 2026.
- llm stats, SWE bench Verified: 113 resultados recopilados, todos autodeclarados y ninguno verificado por un tercero. Consultado el 7 de septiembre de 2026.
- OpenAI, auditoría de las evaluaciones de código: estima que alrededor del 30% de las tareas de SWE bench Pro están rotas y retira su recomendación de usarlo. Julio de 2026.
- OpenAI, anuncio de GPT 6 Astra: la tabla de código del lanzamiento, sin ninguna cifra de SWE bench. 3 de septiembre de 2026.
- Anthropic, anuncio de Claude Fable 5.1 y Mythos 5.1: su tabla de benchmarks, tampoco con SWE bench. 1 de septiembre de 2026.
- OpenAI, ficha de GPT 6 Astra: contexto, salida máxima, corte de conocimiento, precios y el tramo de los 272.000 tokens. Consultada el 7 de septiembre de 2026.
- OpenAI, calendario de retiradas de la API: el ajuste fino se cerró a cuentas nuevas el 7 de mayo de 2026 y a partir del 6 de enero de 2027 no admitirá trabajos nuevos; los modelos ya ajustados siguen funcionando hasta que se retire su modelo base. Leído el 22 de octubre de 2026.
- Anthropic, precios de la API: tarifas de Claude Fable 5.1 y de Claude Opus 5.5 y la nota de que todos los precios y pagos son en dólares. Consultada el 7 de septiembre de 2026.
- Banco Central Europeo, tipo de cambio de referencia: 1 EUR = 1,1463 USD el 22 de septiembre de 2026, usado en todas las conversiones de esta guía.