Anthropic lanzó Claude Opus 5.5 el 22 de septiembre de 2026, tres semanas después de Claude Fable 5.1, y su documentación trae un consejo directo: si no sabes cuál usar, empieza por Opus 5.5 y deja Fable 5.1 para razonamiento exigente o para cuando a más esfuerzo tus pruebas se queden cortas. En el duelo Claude Opus 5.5 vs Fable 5.1, quien fabrica los dos te manda primero al barato.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y los consejos de un fabricante los leo con lupa. Esta vez el índice independiente de Artificial Analysis lo respalda: Opus 5.5 a esfuerzo máximo supera a Fable 5.1 a máximo, y la tarea del índice le sale más barata. Aun así, Anthropic sigue mandando a Fable 5.1 el razonamiento exigente.
Las dos cosas son ciertas, y por eso esta guía no corona a nadie. Pasa a euros la tarifa y el coste por tarea, separa quién midió cada cifra y explica por qué el esfuerzo con el que arranca cada modelo cambia la factura. Si vienes de nuestra comparativa anterior, el escalón barato ha cambiado de nombre y de precio: ahora es Opus 5.5.
Qué es Claude Opus 5.5 y qué comparte con Fable 5.1
Claude Opus 5.5 es el primer modelo de la familia Claude 5.5, y Anthropic lo presenta como modelo para programación agéntica de largo recorrido y trabajo de conocimiento. A Fable 5.1 le reserva el razonamiento exigente y el trabajo agéntico largo. En el índice de Artificial Analysis, Opus 5.5 le quitó el número uno a Fable 5.1. Según el anuncio, Sonnet 5.5 y Haiku 5.5 llegarán en las próximas semanas, sin fecha.
Sobre el papel son casi gemelos: un millón de tokens de contexto, 128.000 de salida máxima, conocimiento cortado en junio de 2026 y pensamiento adaptativo siempre encendido. En su tabla comparativa, Anthropic solo los separa en tres cosas: el precio, la latencia según su propia etiqueta y el esfuerzo por defecto, medio frente a alto. Con Fable 5.1 no compras más memoria ni un conocimiento más fresco. Compras profundidad de razonamiento.
| Ficha | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Lanzamiento | 22 de septiembre de 2026 | 1 de septiembre de 2026 |
| Retirada | no antes del 22 de septiembre de 2027 | no antes del 1 de septiembre de 2027 |
| Contexto | 1.000.000 de tokens | 1.000.000 de tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Corte de conocimiento | junio de 2026 | junio de 2026 |
| Pensamiento | adaptativo, siempre activo | adaptativo, siempre activo |
| Esfuerzo por defecto | medio | alto |
| Latencia, en palabras de Anthropic | moderada | más lenta |
| Para qué, según Anthropic | programación agéntica de largo recorrido y trabajo de conocimiento | razonamiento exigente y trabajo agéntico de largo recorrido |
Documentación de modelos y ficha de Claude Opus 5.5 de Anthropic, leídas el 22 de septiembre de 2026. La latencia es una etiqueta del fabricante, no una medida.
Fable 5.1 no está de salida. Llegó el 1 de septiembre junto a Claude Mythos 5.1, como contamos en su lanzamiento, y sigue en la tabla de modelos actuales. Lo que cambia es el peldaño de abajo: Opus 5.5 ocupa la casilla de Claude Opus 5, que pasa a la lista de heredados y sigue disponible.
Cuánto cuestan y el selector de esfuerzo
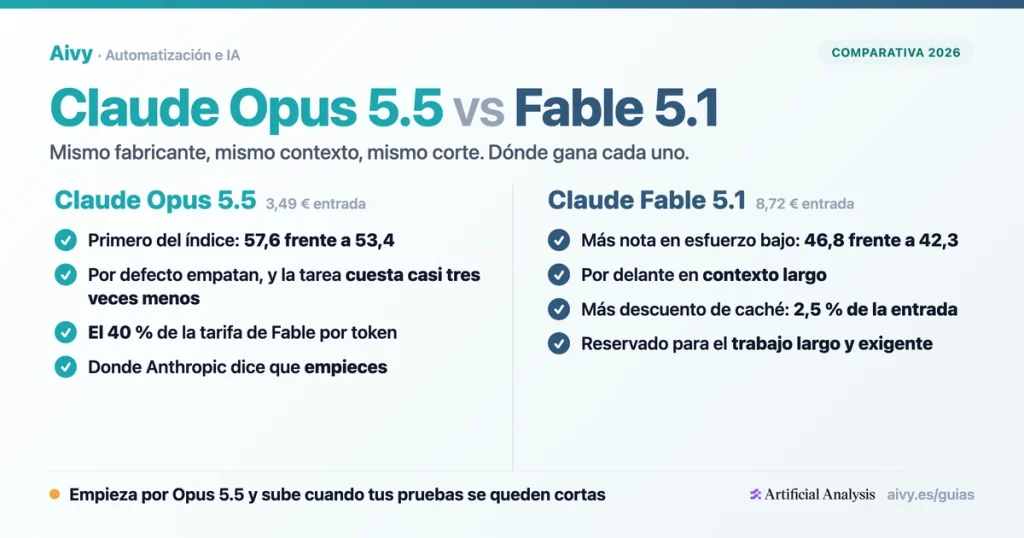
Anthropic publica sus tarifas en dólares y cobra en dólares, así que todos los importes de esta guía van convertidos a euros al tipo del BCE del 22 de septiembre de 2026. Opus 5.5 cuesta 3,49 € por millón de tokens de entrada y 17,45 € por millón de salida; Fable 5.1, 8,72 € y 43,62 €. Opus 5.5 sale un 60% más barato en las dos líneas o, dicho al revés, Fable 5.1 cuesta dos veces y media por token.
Opus 5.5 baja la tarifa de Opus 5 y cuesta un 60% menos que Fable 5.1
Euros por millón de tokens. Más bajo es más barato. Las seis barras a escala de la mayor, 43,62 €. Fuente: página de precios de Anthropic, leída el 22 y el 23 de septiembre de 2026. Anthropic publica y cobra en dólares; convertido al tipo del BCE del 22 de septiembre de 2026.
Entrada, por millón de tokens
Salida, por millón de tokens
Frente a Claude Opus 5, que cobra 4,36 € y 21,81 €, el nuevo baja un 20% por token. Ojo con el 40% del anuncio: Anthropic dice que ejecutar Opus 5.5 cuesta un 40% menos que ejecutar Opus 5 porque cobra menos por token y gasta menos tokens por tarea, en cargas típicas. Se mide contra Opus 5, no contra Fable 5.1, y no es una tarifa. Tokens un 40% más baratos no hay.
Con la caché hay que decir dos cosas ciertas. Leer de caché un millón de tokens cuesta 0,17 € con Opus 5.5, 0,22 € con Fable 5.1 y 0,44 € con Opus 5. Sobre la tarifa en dólares, sin redondeos, Opus 5.5 cobra un 20% menos que Fable 5.1 y un 60% menos que Opus 5. Pero sobre su propia tarifa de entrada, Fable 5.1 descuenta más: releer le cuesta el 2,5% de lo que cobra por un token nuevo, y a Opus 5.5 el 5%.
Leer de caché sale más barato con Opus 5.5, aunque Fable 5.1 descuente más sobre su entrada
Euros por millón de tokens leídos de caché. Más bajo es más barato. Barras a escala de la mayor, 0,44 €. Fuente: página de precios de Anthropic, leída el 22 y el 23 de septiembre de 2026, convertida al tipo del BCE del 22 de septiembre de 2026.
Respecto a su propia tarifa de entrada, la lectura cuesta el 10% en Opus 5, el 5% en Opus 5.5 y el 2,5% en Fable 5.1. Sobre la tarifa en dólares, sin el redondeo del cambio, Opus 5.5 lee un 60% más barato que Opus 5 y un 20% más barato que Fable 5.1.
Importa porque, según el anuncio de Anthropic, las lecturas de caché son la mayor parte del coste del trabajo agéntico y de programación. En esa línea Opus 5.5 aventaja a Fable 5.1 en un 20%, no en un 60%: a igualdad de tokens, cuanto más relea tu carga el mismo contexto, más se estrecha la distancia de tarifa. Para echar tus propias cuentas, tienes la calculadora de ROI.
El segundo mando es el esfuerzo: bajo, medio, alto, muy alto y máximo. El pensamiento no se apaga en ninguno de los dos, y no arrancan igual: Opus 5.5 viene en medio y Fable 5.1 en alto. Tampoco hay recargo por contexto largo: una petición de 900.000 tokens paga lo mismo por token que una de 9.000, al contrario que el tramo de 272.000 tokens de GPT 6 Astra.
Gasto de tokens en la práctica: lo que cuesta una tarea
La factura es la tarifa por los tokens que el modelo gasta hasta terminar, y el esfuerzo mueve mucho ese segundo número: con Opus 5.5 va de 0,48 € a 5,22 € la tarea. Artificial Analysis, un evaluador independiente, publica el coste por tarea de su índice de inteligencia v4.3 para cada modelo y cada esfuerzo. Es lo más parecido a una factura publicada, aunque no sea la tuya.
Empieza por los ajustes de fábrica, que es lo que te llevas si no tocas nada. Opus 5.5 en medio marca 51,24 y la tarea le sale a 1,17 €. Fable 5.1 en alto marca 51,15 por 3,41 €. Nueve centésimas son un empate, no una victoria, y aun así Fable 5.1 cuesta casi tres veces más por tarea: 3,41 € entre 1,17 € da 2,91.
Con el mismo ajuste en los dos, la distancia de coste sigue ahí. En alto contra alto, Opus 5.5 saca 2,43 puntos más y Fable 5.1 cuesta unas 2,1 veces lo que él, 3,41 € frente a 1,59 €. En medio contra medio son 2,32 puntos y unas 2,2 veces, 2,60 € frente a 1,17 €.
A cada nivel de esfuerzo, la tarea de Fable 5.1 cuesta más que la de Opus 5.5
Euros por tarea del índice de inteligencia v4.3. Más bajo es mejor. Barras a escala de la mayor, 6,66 €. Fuente: Artificial Analysis (artificialanalysis.ai), filas con desvío de salvaguardas, leído el 22 y el 23 de septiembre de 2026. Convertido al tipo del BCE del 22 de septiembre de 2026.
Opus 5.5 en máximo y Fable 5.1 en muy alto cuestan lo mismo, 5,22 € la tarea.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
La cuenta que más me interesa es otra. Opus 5.5 en alto marca 53,58 a 1,59 € la tarea; el mejor Fable 5.1, en máximo, 53,35 a 6,66 €. Son 0,23 puntos, un empate y no una victoria, pero Fable 5.1 cuesta unas 4,2 veces más por llegar al mismo sitio. Y arriba del todo, Opus 5.5 en máximo cuesta lo mismo que Fable 5.1 en muy alto, 5,22 € los dos, y saca 4,42 puntos más.
Anthropic suma una prueba interna: al traducir HAProxy de C a Rust, las dos reescrituras pasaron casi todas sus pruebas de regresión, pero Opus 5.5 terminó en 9,5 horas frente a 12 y costó un 51% menos. Una sola prueba, y del fabricante, no de campo.
Qué dicen los benchmarks y quién los ha medido
Aquí se mezclan tres fuentes, y conviene separarlas en tres montones: el fabricante, con la system card y el anuncio de Anthropic; Artificial Analysis, que mide por su cuenta; y Cursor y Proximal, cuyas cifras llegan publicadas en la system card. Los tres ponen a Opus 5.5 delante de Fable 5.1, pero no por el mismo margen.
Empiezo por el independiente. En el índice v4.3 de Artificial Analysis, tope contra tope, Opus 5.5 marca 57,62 y Fable 5.1 53,35: 4,27 puntos más, con la tarea un 21,6% más barata, 5,22 € frente a 6,66 €. Fíjate en la forma: Opus 5.5 va de 42,31 a 57,62, 15,31 puntos de punta a punta; Fable 5.1 va de 46,82 a 53,35, arranca más alto y sube solo 6,53. Por eso en bajo el orden se da la vuelta.
Opus 5.5 va delante desde medio hacia arriba; en bajo manda Fable 5.1
Índice de inteligencia v4.3 por nivel de esfuerzo. Más alto es mejor. Barras a escala de la mayor, 57,62 puntos. Fuente: Artificial Analysis (artificialanalysis.ai), filas con desvío de salvaguardas, leído el 22 y el 23 de septiembre de 2026.
Opus 5.5 en alto (53,58) y Fable 5.1 en máximo (53,35) están empatados: 0,23 puntos.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
En las pruebas que forman el índice, con dato de los dos a máximo y leídas el 22 de septiembre, Opus 5.5 gana en GDPval, Terminal Bench 4.0, Humanity’s Last Exam, SciCode y CritPt, y sobre todo en no alucinar, dentro de AA Omniscience: 0,4139 frente a 0,2742. Fable 5.1 se queda con dos, que cuento más abajo.
Ahora el fabricante. La tabla 8.1.A de la system card pone a Opus 5.5 delante de Fable 5.1 en todas las filas que traen a los dos. El margen más ancho es Terminal Bench 4.0, 66,4 frente a 55,8, con un error típico de 2,6 puntos para Opus 5.5 y de 1,6 a 2 para los demás: esa distancia sí es ancha. Los más estrechos, OSWorld 2.0 parcial y Humanity’s Last Exam con herramientas, se quedan en 1,1 y 2,1 puntos.
| Evaluación | Claude Opus 5.5 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|---|
| SWE bench Pro | 89,9 | 81,2 | 79,2 |
| SWE bench Multilingual | 93,9 | 89,1 | 89,5 |
| SWE bench Multimodal | 61,4 | 54,7 | 59,4 |
| FrontierCode v1.1 (Main) | 54,4 | 50,3 | 48,0 |
| Terminal Bench 4.0 (Opus 5.5 en muy alto) | 66,4 | 55,8 | 52,3 |
| Terminal Bench Science 0.1 | 58,7 | 52,6 | 29,0 |
| Humanity’s Last Exam, sin herramientas | 64,4 | 60,9 | 56,6 |
| Humanity’s Last Exam, con herramientas | 67,7 | 65,6 | 63,6 |
| OSWorld 2.0, parcial y estricta | 81,8 y 48,7 | 80,7 y 42,8 | 74,0 y 37,2 |
| HealthBench Professional | 65,6 | 62,1 | 59,8 |
| GDPval AA v2.1 (Elo) | 1846 | 1735 | 1708 |
| AA Briefcase v1.1 | 1822 | 1678 | 1673 |
| AutomationBench | 40,0 | 31,4 | 26,9 |
Cifras del fabricante, no independientes: system card de Claude Opus 5.5, tabla 8.1.A (página 174), 22 de septiembre de 2026. Opus 5.5 con pensamiento adaptativo a esfuerzo máximo y media de cinco intentos, salvo Terminal Bench 4.0, en muy alto. Las cifras de los demás modelos salen, según Anthropic, de sus fichas o de los marcadores publicados.
Las filas GDPval AA y AA Briefcase también las publica Anthropic en su system card: no son lecturas nuestras del tablero de Artificial Analysis, y Artificial Analysis no avala este análisis ni es responsable de él.
Y el propio Anthropic rebaja su tabla: en el anuncio escribe que, a este nivel de capacidad, los márgenes de los benchmarks guían peor las diferencias reales, y que en su uso la distancia entre los dos es más estrecha de lo que sugieren las notas.
El tercer montón no lo firma Anthropic. En CursorBench 4.0, medido por Cursor, Opus 5.5 saca un 57,8% en máximo y Fable 5.1 un 51,8%, a 15,07 € la tarea; Opus 5.5 en alto ya marca un 56,0%, por más o menos la cuarta parte de ese coste. Un matiz: el 52,5% de Opus 5.5 en medio frente al 51,8% de Fable 5.1 lo da el anuncio de Anthropic, no Cursor.
Proximal ejecutó FrontierSWE v2, 34 tareas de programación muy largas, con su propio arnés y todos los modelos en máximo. Opus 5.5 queda segundo con un 62,3%, detrás de GPT 6 Astra, con un 65,5%, y delante de Fable 5.1, con un 56,3%. Y queda un hueco: el índice de programación de Artificial Analysis no tiene nota de Opus 5.5 en ningún esfuerzo a 23 de septiembre.
Claude Opus 5.5 vs Fable 5.1 vs Opus 5 vs Sonnet 5
Ahora, los dos junto a Claude Opus 5, el escalón de abajo hasta ahora, y Claude Sonnet 5, el de tarifa más baja de los cuatro. Precio y ficha son de Anthropic; índice y coste por tarea, de Artificial Analysis. Donde falta un dato, lo digo.
| Claude Opus 5.5 | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 | |
|---|---|---|---|---|
| Estado | actual | actual | heredado, sigue disponible | actual |
| Entrada por millón de tokens | 3,49 € | 8,72 € | 4,36 € | 1,74 € |
| Salida por millón de tokens | 17,45 € | 43,62 € | 21,81 € | 8,72 € |
| Lectura de caché por millón | 0,17 € | 0,22 € | 0,44 € | no está en nuestras fuentes |
| Esfuerzo por defecto | medio | alto | alto | alto |
| Contexto | 1.000.000 de tokens | 1.000.000 de tokens | no está en nuestras fuentes | 1.000.000 de tokens |
| Índice AA v4.3 a esfuerzo máximo | 57,62, primero del tablero | 53,35 | 50,78 (leído solo el 22 de septiembre) | 38 (solo en entero, 23 de septiembre) |
| Coste por tarea del índice a máximo | 5,22 € | 6,66 € | 5,11 € (22 de septiembre) | 4,44 € |
| Para qué | la mayoría de cargas, según Anthropic | razonamiento exigente y trabajo agéntico de largo recorrido | lo que aún no has migrado | la tarifa por token más baja de los cuatro |
Estado, precios, esfuerzo y contexto: documentación y página de precios de Anthropic, leídas el 22 y el 23 de septiembre de 2026, con los precios convertidos al tipo del BCE del 22 de septiembre de 2026. Índice y coste por tarea: Artificial Analysis (artificialanalysis.ai), v4.3. La fila «Para qué» de Opus 5 y Sonnet 5 es criterio nuestro.
Basado en datos de Artificial Analysis (artificialanalysis.ai), leídos el 22 y el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
La columna de Sonnet 5 es la mejor prueba de que la tarifa no es la factura. Por token cuesta la mitad que Opus 5.5: 1,74 € y 8,72 € frente a 3,49 € y 17,45 €. Pero a esfuerzo máximo la tarea del índice le sale a 4,44 € y marca 38, mientras Opus 5.5 en medio marca 51,24 a 1,17 €. Para Haiku 4.5 y el resto de la gama, repasa nuestra guía de modelos.
Opus 5 tiene poco sentido para trabajo nuevo. Cuesta más que Opus 5.5 en entrada, salida y caché y el 22 de septiembre marcaba 50,78 a máximo, por debajo de Opus 5.5 en medio. Al día siguiente Artificial Analysis ya lo daba por obsoleto y lo había sacado de su tabla.
Qué recomienda Anthropic y dónde sigue ganando Fable 5.1
La documentación de modelos de Anthropic lo dice sin rodeos. Si no sabes cuál usar, empieza por Claude Opus 5.5 en la mayoría de las cargas. Usa Claude Fable 5.1 para razonamiento exigente y trabajo agéntico de largo recorrido, o cuando tus pruebas con Opus 5.5 a más esfuerzo se queden cortas. No es un relevo: Opus 5.5 no sustituye a Fable 5.1.
Yo lo leo como una escalera de tres peldaños: Opus 5.5 en medio, su ajuste de fábrica; el mismo Opus 5.5 subiendo a alto, muy alto y máximo, con tus pruebas en cada paso; y Fable 5.1. Lo importante es el orden. Salvo en razonamiento exigente o trabajo agéntico largo, que Anthropic manda directo a Fable 5.1, no pasas al tercero porque el trabajo parezca difícil, sino porque el segundo ha fallado en algo que puedes enseñar.
Y hay una razón técnica que juega a favor de ese sentido. En la API de Claude, Fable 5.1 lee los bloques de pensamiento de Opus 5.5, así que si subes a mitad de conversación el razonamiento hecho se conserva. Opus 5.5 no lee los de ningún modelo Fable: si bajas, esos bloques se descartan, la petición sale bien y no se cobran, pero el razonamiento se pierde. La escalera oficial va justo en la dirección que funciona.
Para los agentes de IA que se pasan trabajo entre modelos, esto pesa mucho. Mi regla: sube por fallos medidos sobre tu propio banco de pruebas, no por una impresión, y no bajes dentro de la misma conversación.
Donde Fable 5.1 conserva ventaja con datos de los dos es justo en el terreno que Anthropic le reserva. En el índice de Artificial Analysis, a máximo, gana el razonamiento en contexto largo, 0,8533 frente a 0,8467, y el acierto bruto de conocimiento en AA Omniscience, 0,6723 frente a 0,6622. Márgenes pequeños, pero medidos por quien no vende ninguno. Aparte queda el esfuerzo bajo, que ya has visto: 4,51 puntos, fuera del terreno que Anthropic le reserva.
El acierto bruto tiene letra pequeña: Fable 5.1 acierta algo más, pero Opus 5.5 alucina bastante menos: 0,4139 frente a 0,2742 en la prueba de no alucinación. La prueba de informes de Anthropic, otra cifra del fabricante, empuja al mismo lado: 16 de 18 informes de Opus 5.5 pasaron su listón de calidad, y ni Fable 5.1 ni Opus 5 lo pasaron en ningún intento. Si tu riesgo es una cifra falsa dicha con aplomo, quédate en Opus 5.5.
Qué significa para las empresas españolas
Lo primero es la moneda. Anthropic cobra en dólares, así que lo que pagas en euros se mueve con el cambio y estas cifras son la foto de un día. Lo que no se mueve es la proporción: Fable 5.1 cuesta dos veces y media lo que Opus 5.5 por token de entrada y de salida, haga lo que haga el euro.
Lo segundo, dónde se procesan los datos. La API directa de Anthropic solo admite hoy inferencia global, la de por defecto, o en Estados Unidos, que cuesta 1,1 veces la tarifa: no hay opción solo en Europa para ninguno de los dos. Amazon Bedrock y Google Cloud tienen puntos de acceso regionales con un 10% de recargo, pero no he comprobado qué regiones europeas sirven cada modelo. Eso se mira en cada consola.
Lo tercero es la retención. Anthropic dice que Opus 5.5, como los Opus anteriores, está disponible con retención cero de datos. Retención cero no quiere decir que los datos se procesen en Europa. Y la documentación de Claude Code avisa de que, bajo retención cero, algunas organizaciones no pueden usar Fable en Claude Code. Para el encaje legal, empieza por nuestra guía de cumplimiento.
Lo cuarto, el plan. Claude Code arranca en Opus 5.5, en esfuerzo medio, en Pro, Max, Team, Enterprise y la API de Anthropic, desde la versión 2.1.280; en Microsoft Foundry arranca en Sonnet 4.5. Ningún modelo Fable es el predeterminado: se elige con /model fable. En Pro, Fable 5.1 se paga aparte, con créditos de uso de pago por uso, y en una sesión interactiva Claude Code te pide permiso antes; en Max entra en el plan.
Lo quinto son las salvaguardas. Según Anthropic, Opus 5.5 es el primer Opus que sale con salvaguardas de una clase parecida a las de Fable 5.1 en ciberseguridad, biología y destilación, y todas desvían a otro modelo de forma transparente. Un rechazo, además, llega con un HTTP 200 y el motivo de parada «refusal», no como error. En una asesoría o gestoría que procesa facturas sin nadie mirando, conviene contar esos rechazos aparte.
Qué nivel de esfuerzo usar y cuándo
Mi punto de partida es el modelo por el que Anthropic aconseja empezar, en su esfuerzo de fábrica: Opus 5.5 en medio. Ojo con la trampa de migración número uno: si cambias Fable 5.1 por Opus 5.5 y tu código no fija el esfuerzo, el nuevo razona menos, porque arranca en medio y no en alto. Fija el esfuerzo a mano. Y como Opus 5.5 piensa más por turno que Opus 5 con el mismo esfuerzo, Anthropic pide repetir el barrido de esfuerzos y dejar margen en max_tokens.
| Esfuerzo | Índice Opus 5.5 | Tarea Opus 5.5 | Índice Fable 5.1 | Tarea Fable 5.1 | Para qué en Opus 5.5 |
|---|---|---|---|---|---|
| Bajo | 42,31 | 0,48 € | 46,82 | 2,07 € | tareas acotadas y de mucho volumen; aquí gana Fable 5.1 en nota, así que antes haz tus propias pruebas |
| Medio | 51,24 (por defecto) | 1,17 € | 48,92 | 2,60 € | el primer peldaño: el modelo que recomienda Anthropic, con su ajuste de fábrica |
| Alto | 53,58 | 1,59 € | 51,15 (por defecto) | 3,41 € | cuando medio falla en tus pruebas; empata con el mejor Fable 5.1 |
| Muy alto | 55,99 | 3,02 € | 53,20 | 5,22 € | si alto no basta; menos de la mitad del coste de Fable 5.1 en máximo |
| Máximo | 57,62 | 5,22 € | 53,35 | 6,66 € | el último peldaño antes de Fable 5.1; cuesta lo mismo que Fable 5.1 en muy alto |
Índice de inteligencia v4.3 y coste por tarea del índice de Artificial Analysis (artificialanalysis.ai), filas con desvío de salvaguardas, con el coste convertido al tipo del BCE del 22 de septiembre de 2026. La columna «Para qué» es criterio nuestro, no de Artificial Analysis ni de Anthropic.
Basado en datos de Artificial Analysis (artificialanalysis.ai), leídos el 22 y el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
El bajo es la única fila donde gana Fable 5.1: 46,82 frente a 42,31, a unas 4,3 veces el coste por tarea (2,07 € frente a 0,48 €). Pero Opus 5.5 en medio marca 51,24 por 1,17 €, más nota que Fable 5.1 en bajo y por menos dinero. Si pensabas poner Fable 5.1 en bajo para ahorrar en una automatización documental, prueba antes Opus 5.5 en medio.
Si las pruebas se quedan cortas, subiría a alto antes que cambiar de modelo: ahí Opus 5.5 empata con el mejor Fable 5.1. Muy alto, a 3,02 € la tarea, ya le saca 2,64 puntos a Fable 5.1 en máximo. Y el máximo lo dejaría para cuando cada punto cuenta, porque es el salto de coste más grande en euros de la escalera: de 3,02 € a 5,22 €.
Subir de esfuerzo tampoco mejora siempre. En FrontierCode, según Anthropic, el mejor resultado de Opus 5.5 está en medio, un 54,6%, y empeora al subir porque la corrección penaliza los cambios fuera del encargo; Fable 5.1 se queda en un 52,8% en su mejor esfuerzo. El peldaño correcto se mide, no se supone.
Sobre la velocidad, sin cifras: en las lecturas de Artificial Analysis del 22 y del 23 de septiembre, Opus 5.5 sacó la salida más rápido que Fable 5.1 en cada esfuerzo donde los dos están medidos. No doy cifras porque se mueven de un día a otro, y a máximo Opus 5.5 aún no tiene velocidad medida.
Quien venga de Opus 5 tiene además cuatro cambios que rompen código, y los tres primeros valen también para Fable 5.1: el pensamiento no se puede desactivar, forzar el uso de herramientas da un error 400 y los bloques de pensamiento van atados al modelo. El cuarto, solo de Opus 5.5, retira la versión antigua de la herramienta de uso del ordenador en la API de Claude y en Google Cloud. Y con la vista por defecto, una app que enseña el progreso entre herramientas se queda callada.
Empieza barato y sube con pruebas
La lectura rápida es que ganó el barato, y en el índice independiente así fue. La útil es otra: el fabricante pone a Opus 5.5 delante y avisa de que la distancia real es menor, Artificial Analysis enseña dos empates que valen dinero y Fable 5.1 conserva dos ventajas pequeñas justo en el terreno que Anthropic le reserva.
Si lo montara hoy, cogería un puñado de tareas reales, las pasaría por Opus 5.5 en medio, en alto y en muy alto, y solo entonces probaría Fable 5.1 con las que siguieran fallando. Como en la API de Claude subir a mitad de conversación no borra el razonamiento, no pierdes lo que ya ha pensado. Si prefieres no hacerlo solo, es el tipo de revisión que cubre nuestra consultoría de IA.
Ninguna de estas cifras sale de tus documentos ni de tu proceso, y a Opus 5.5 aún le falta nota en el índice de programación de Artificial Analysis. Mira la fecha al pie antes de fiarte de estos números. Si quieres que veamos juntos qué cargas tuyas van en cada peldaño, reserva una llamada cuando te venga bien.
Claude Opus 5.5 vs Fable 5.1: preguntas frecuentes
¿Cuánto cuestan Claude Opus 5.5 y Fable 5.1 en euros?
Al tipo del BCE del 22 de septiembre de 2026, Opus 5.5 cuesta 3,49 € por millón de tokens de entrada y 17,45 € por millón de salida; Fable 5.1, 8,72 € y 43,62 €. Leer de caché sale a 0,17 € y 0,22 €. Anthropic cobra en dólares, así que lo que pagas se mueve con el cambio.
¿Cuál de los dos gasta menos por tarea?
Opus 5.5, en cada esfuerzo frente al mismo esfuerzo de Fable 5.1. Según Artificial Analysis, cada uno en su ajuste de fábrica, empatan en nota, 51,24 frente a 51,15, pero la tarea cuesta 1,17 € con Opus 5.5 y 3,41 € con Fable 5.1. Incluso en bajo, donde Fable 5.1 puntúa más, su tarea cuesta unas 4,3 veces más.
¿Cuál es mejor para programar?
Empieza por Opus 5.5. En las cifras de Anthropic va delante en SWE bench Pro, 89,9 frente a 81,2, y en Terminal Bench 4.0. En CursorBench, medido por Cursor, y en FrontierSWE v2, que midió Proximal, también supera a Fable 5.1. Lo que falta es la nota de Artificial Analysis: su índice de programación aún no ha medido Opus 5.5.
¿Fable 5.1 entra en mi plan de Claude?
Depende del plan. En Max, Fable 5 y Fable 5.1 forman parte del plan; en Pro se pagan aparte, con créditos de uso de pago por uso. La documentación de Claude Code añade que, según el plan y el tipo de puesto, Fable puede cobrarse de esos créditos en vez de gastar los límites incluidos, y que en las sesiones interactivas Claude Code te pide permiso antes.
¿Claude Opus 5.5 sustituye a Fable 5.1?
No. Anthropic recomienda empezar por Opus 5.5 en la mayoría de las cargas, pero sigue mandando a Fable 5.1 el razonamiento exigente y el trabajo agéntico de largo recorrido, y también los casos en que tus pruebas con Opus 5.5 a más esfuerzo se quedan cortas. Los dos siguen en la tabla de modelos actuales.
¿Qué modelo usa Claude Code por defecto?
Claude Opus 5.5, en esfuerzo medio, en Pro, Max, Team, Enterprise y la API de Anthropic; necesita la versión 2.1.280 de Claude Code o una posterior. En Microsoft Foundry el predeterminado es Sonnet 4.5. Ningún modelo Fable es el predeterminado en ningún plan ni proveedor, así que Fable 5.1 hay que elegirlo a mano.
¿Qué cambia en la API al pasar a Opus 5.5?
El pensamiento ya no se desactiva: pedirlo apagado o fijar un presupuesto manual da un error 400, igual que forzar el uso de herramientas. Los bloques de pensamiento van atados al modelo y, en la API de Claude y en Google Cloud, cambia la versión de la herramienta de uso del ordenador. Y el esfuerzo por defecto baja a medio: vuelve a probar los niveles.
¿Sigue disponible Claude Opus 5?
Sí, como modelo heredado. Pero cuesta más que Opus 5.5 en entrada, salida y caché, 4,36 € y 21,81 € por millón, y el 22 de septiembre marcaba 50,78 en el índice de Artificial Analysis a máximo, frente a 57,62. Anthropic calcula que, en cargas típicas, ejecutar Opus 5.5 cuesta un 40% menos que ejecutar Opus 5.
Última actualización: 23 de septiembre de 2026
- Anthropic, ficha de Claude Opus 5.5: tabla comparativa de contexto, salida máxima, precio, latencia según Anthropic, pensamiento, esfuerzo por defecto y corte de conocimiento de Opus 5.5, Fable 5.1 y Sonnet 5. Leída el 22 de septiembre de 2026.
- Anthropic, novedades de Claude Opus 5.5: los cuatro cambios que rompen código, los bloques de pensamiento entre modelos, el esfuerzo por defecto, el barrido de esfuerzos y los rechazos con HTTP 200. Leída el 22 de septiembre de 2026.
- Anthropic, documentación de modelos: la recomendación de empezar por Opus 5.5, las descripciones de cada modelo, las listas de modelos actuales y heredados y las fechas de retirada. Leída el 22 de septiembre de 2026.
- Anthropic, precios de la API: tarifas de entrada, salida, caché y lotes, la nota de que todos los precios y pagos son en dólares, la ausencia de recargo por contexto largo y el recargo del 10% de los puntos de acceso regionales de Amazon Bedrock y Google Cloud. Leída el 22 y el 23 de septiembre de 2026.
- Anthropic, residencia de datos: las opciones de inferencia global y en Estados Unidos, su recargo de 1,1 veces. Leída el 23 de septiembre de 2026.
- Anthropic, system card de Claude Opus 5.5: la tabla 8.1.A (página 174), FrontierCode, FrontierSWE v2 de Proximal y CursorBench 4.0 de Cursor. 22 de septiembre de 2026.
- Anthropic, anuncio de Claude Opus 5.5: el 40% frente a Opus 5, la caché como mayor parte del coste, HAProxy, CursorBench en medio, la prueba de informes, salvaguardas, retención cero y la llegada de Sonnet 5.5 y Haiku 5.5. 22 de septiembre de 2026.
- Claude Code, configuración de modelos: el modelo por defecto en cada plan y proveedor, la versión 2.1.280, Fable fuera de los predeterminados, los créditos de uso y el aviso sobre retención cero. Leída el 23 de septiembre de 2026.
- Claude, modelos Fable en tu plan: Fable 5 y 5.1 sobre créditos de uso en Pro y como parte estándar del plan en Max. Leída el 23 de septiembre de 2026.
- Fuente: Artificial Analysis (artificialanalysis.ai): índice de inteligencia v4.3 y coste por tarea por nivel de esfuerzo, leídos el 22 y el 23 de septiembre de 2026; las pruebas que forman el índice y Claude Opus 5, del 22 de septiembre. Basado en datos de Artificial Analysis, leídos el 22 y el 23 de septiembre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Data API de Artificial Analysis: el índice de programación, sin medir para Claude Opus 5.5 en ningún esfuerzo. Leída el 23 de septiembre de 2026.
- Banco Central Europeo, tipo de cambio de referencia: 1 euro = 1,1463 dólares estadounidenses el 22 de septiembre de 2026, usado en todas las conversiones de esta guía.