Claude Opus 5.5 salió el 22 de septiembre de 2026 y GPT 6 Astra lleva en la calle desde el día 3, así que toda comparativa GPT 6 Astra vs Claude Opus 5.5 acaba en la misma duda: cambiar o quedarse. En el índice de Artificial Analysis, lo que más mueve la nota y el coste por tarea no es la marca: es el nivel de esfuerzo.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y me paso más horas cuadrando lo que promete el fabricante con lo que puede pagar el cliente que mirando benchmarks. Por eso esta guía no se queda en quién gana: mira cuánto cuesta cada nota y a qué nivel de esfuerzo se consigue.
Separo tres fuentes que no pesan lo mismo: el índice de Artificial Analysis, que mide a los dos con la misma batería; la tabla que Anthropic publicó con su modelo; y las dos tarifas de lista, pasadas a euros. Si vienes de la comparativa con Fable 5.1, aquí cambian las cuentas. Y donde algo no está medido, lo digo en vez de rellenar el hueco.
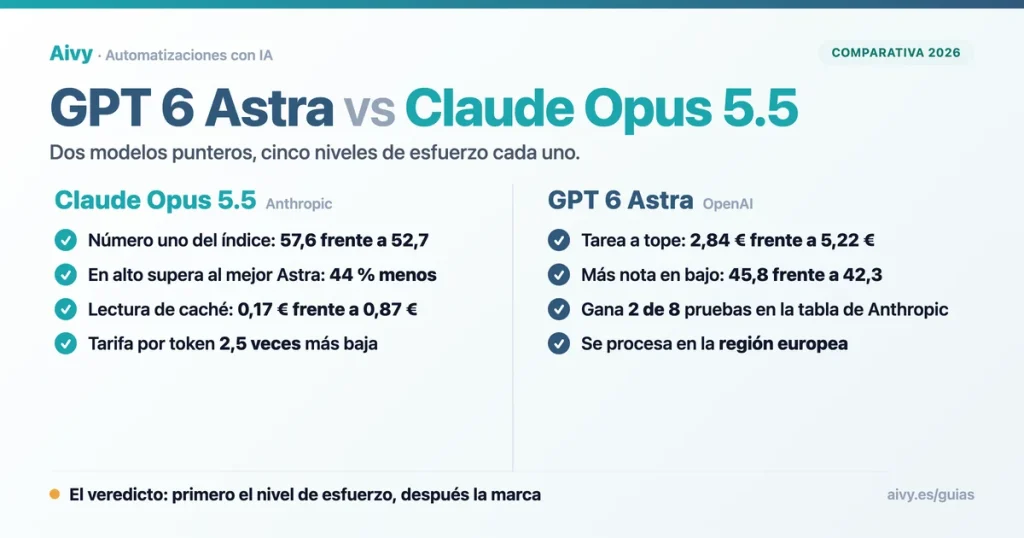
GPT 6 Astra vs Claude Opus 5.5 de un vistazo
Empiezo por el esfuerzo alto, porque ahí la comparación se tuerce. Según Artificial Analysis, Claude Opus 5.5 a esfuerzo alto saca 53,6 en su índice de inteligencia v4.3. GPT 6 Astra a máximo, su escalón más alto, se queda en 52,7. Opus 5.5, dos escalones por debajo de su techo, supera a Astra en el suyo. Y su tarea cuesta 1,59 € frente a 2,84 €: un 44 % menos.
Ahora dale la vuelta. A máximo contra máximo, Opus 5.5 saca 57,6 frente a 52,7, pero su tarea cuesta 5,22 € frente a 2,84 €: 1,84 veces más. Arriba del todo, la tarea más barata es la de Astra, aunque su tarifa por token sea 2,5 veces más cara. Las dos cosas son ciertas, y por eso el número uno del tablero merece matices.
| Cara a cara | Claude Opus 5.5 (high) | Claude Opus 5.5 (max) | GPT 6 Astra (high) | GPT 6 Astra (max) |
|---|---|---|---|---|
| Índice de inteligencia v4.3 | 53,6 | 57,6 | 50,9 | 52,7 |
| Coste por tarea del índice | 1,59 € | 5,22 € | 1,50 € | 2,84 € |
| Tokens por segundo (23 de septiembre) | 90 | sin medir | 50 | 58 |
| Tarifa de entrada, por millón | 3,49 € | 3,49 € | 8,72 € | 8,72 € |
| Tarifa de salida, por millón | 17,45 € | 17,45 € | 43,62 € | 43,62 € |
| Leer un millón de tokens de caché | 0,17 € | 0,17 € | 0,87 € | 0,87 € |
Índice, coste por tarea (tarifa estándar, lectura del 22 de septiembre) y velocidad: Fuente: Artificial Analysis (artificialanalysis.ai). Artificial Analysis mide Claude con su modelo de reserva activado. Las tres filas de tarifa son los precios publicados por Anthropic y OpenAI. Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Qué es cada modelo y por qué manda el nivel de esfuerzo
Claude Opus 5.5 es, según Anthropic, el primer modelo de la nueva familia Claude 5.5. Trae 1.000.000 de tokens de contexto y 128.000 de salida máxima, con el conocimiento cortado en junio de 2026, y no se retirará antes del 22 de septiembre de 2027. GPT 6 Astra, que OpenAI lanzó el 3 de septiembre, llega a 1.050.000 tokens de contexto, los mismos 128.000 de salida y el corte en el 30 de abril.
Los dos se regulan con un dial de cinco escalones: low, medium, high, xhigh y max, que aquí llamo bajo, medio, alto, muy alto y máximo. Opus 5.5 viene en medio por defecto, cuando Opus 5 venía en alto, y su pensamiento es adaptativo y siempre activo: ya no se puede apagar. Astra razona en todos los niveles, bajo es su escalón mínimo, y su ficha no publica el valor por defecto: mira qué envía tu integración.
El nivel de esfuerzo no es un detalle. En el índice de Artificial Analysis, Opus 5.5 recorre más de 15 puntos de bajo a máximo, de 42,3 a 57,6, y Astra menos de 7, de 45,8 a 52,7. En coste, Opus 5.5 va de 0,48 € a 5,22 € la tarea, casi 11 veces; Astra, de 0,71 € a 2,84 €, cuatro veces. Cambiar de nivel mueve más la nota que cambiar de modelo.
Índice de inteligencia v4.3 por nivel de esfuerzo
Más es mejor. Cada barra es un nivel de esfuerzo de un modelo. Barras a escala de 60 puntos. Crédito: Artificial Analysis, Intelligence Index v4.3, leído el 22 y el 23 de septiembre de 2026 (sin cambios entre los dos días).
Claude Opus 5.5 recorre más de 15 puntos de su nivel más bajo al más alto; GPT 6 Astra, menos de 7.
Artificial Analysis mide Claude Opus 5.5 con su modelo de reserva activado («with fallback»); GPT 6 Astra, sin esa condición.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Benchmarks: un árbitro independiente y la tabla de Anthropic
La primera prueba es el índice v4.3 de Artificial Analysis, que pasa a todos los modelos por la misma batería y publica un único índice compuesto. Consultado el 22 y el 23 de septiembre, da las mismas cifras los dos días. No tiene índice agéntico, y en su API el índice de programación de Opus 5.5 aparece sin medir: nadie puede decir que gane o pierda programando según Artificial Analysis.
Opus 5.5 es el número uno, pero no barre. En la tasa de no alucinación, una de las métricas de AA Omniscience, Astra saca 0,4866 frente a 0,4139 de Opus 5.5 a máximo (lectura del 22 de septiembre), y en GPQA Opus 5.5 está sin medir. Un matiz de montaje: a Claude lo mide con su modelo de reserva activado («with fallback») y a Astra sin esa condición.
La segunda fuente es la tabla 8.1.A de la system card de Opus 5.5, que publica el propio Anthropic. Ocho filas traen cifra para los dos y Astra gana dos: AutomationBench y Terminal Bench Science 0.1. Es una tabla favorable a Opus 5.5 de entrada, porque la eligió su fabricante, y Anthropic no hizo las pruebas de Astra: toma sus cifras de lo que publica cada desarrollador o de los tableros de cada prueba.
| System card, tabla 8.1.A | Claude Opus 5.5 | GPT 6 Astra | Lo que dice la letra pequeña |
|---|---|---|---|
| Terminal Bench 4.0 | 66,4 % | 57,9 % | No es el mismo esfuerzo: Claude a xhigh, Astra a high, que es lo que reportó OpenAI. Error típico de 2,6 puntos para Opus 5.5 |
| GDPval AA v2.1 (Elo) | 1846 | 1542 | La midió un tercero, según Anthropic |
| AA Briefcase v1.1 | 1822 | 1569 | La midió un tercero, según Anthropic |
| Humanity’s Last Exam, con herramientas | 67,7 % | 57,2 % | Las dos cifras con herramientas |
| HealthBench Professional | 65,6 % | 63,4 % | 2,2 puntos a favor de Claude |
| FrontierCode v1.1 (Main) | 54,4 % | 53,3 % | La fila más ajustada, 1,1 puntos. Claude puntúa más a esfuerzo medio (54,6 %) que a máximo |
| AutomationBench | 40,0 % | 41,4 % | La hizo Zapier sin modelos de reserva: según el anuncio de Anthropic, cada parada de las salvaguardas contó como fallo |
| Terminal Bench Science 0.1 | 58,7 % | 64,6 % | Error típico de 3,5 a 4,8 puntos por modelo según la card, cercano a la diferencia |
Cifras del fabricante. Anthropic no midió las de GPT 6 Astra: según su propia nota, salen de lo que publica cada desarrollador o de sus tablas de clasificación. Resultados de Claude Opus 5.5 a esfuerzo máximo salvo Terminal Bench 4.0.
La letra pequeña dice más que las cifras. La primera fila, Terminal Bench 4.0, compara la mejor nota de cada uno, pero a esfuerzos distintos, y en Terminal Bench Science el error típico se acerca a la diferencia. Fuera de la tabla, en FrontierSWE v2, 34 tareas larguísimas que midió Proximal, Astra saca un 65,5 % frente al 62,3 %, y Anthropic reconoce a su modelo segundo. Que un fabricante publique dónde pierde le da credibilidad.
El 89,9 % de Opus 5.5 en SWE bench Pro llega sin cifra de Astra al lado: no decide nada. Y Anthropic añade una frase: a estos niveles, los márgenes de los benchmarks son una guía menos fiable de las diferencias reales, y en su propio uso la distancia entre Opus 5.5 y Claude Fable 5.1 es menor de lo que dicen las cifras. Cómo se reparte esa familia lo cuento en qué modelo de Claude usar.
Precios y coste por tarea para una empresa española
OpenAI y Anthropic publican y facturan en dólares, y aquí todo está convertido al tipo del BCE del 22 de septiembre de 2026: un euro, 1,1463 dólares, el mismo en toda la guía. Lo que pague tu empresa se moverá con el cambio aunque la tarifa no se toque; si quieres echar números con tus volúmenes, está la calculadora de ROI.
De lista no hay color. Opus 5.5 cuesta 3,49 € por millón de tokens de entrada y 17,45 € por millón de salida; Astra cobra 8,72 € y 43,62 €, 2,5 veces más en las dos líneas. Los dos cobran la mitad por lotes: Opus 5.5, 1,74 € y 8,72 €; Astra, 4,36 € y 21,81 €. Anthropic tiene además un modo rápido en Claude Code y en su plataforma a 6,98 € y 34,89 €.
Tarifa de lista por millón de tokens, en euros
Menos es más barato. Precios publicados, no consumo medido. Los dos paneles a escala de 43,62 €. Fuentes: páginas de precios de Anthropic y OpenAI, 22 de septiembre de 2026. Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Entrada, por millón de tokens
Salida, por millón de tokens
Pero la tarifa no es la factura. Una tarea cuesta la tarifa por los tokens que el modelo gasta hasta acabarla, y ningún fabricante lo publica con una batería común para los dos. Artificial Analysis sí lo mide, a tarifa estándar, y ahí la ventaja de 2,5 veces se evapora. A esfuerzo alto contra alto, los dos quedan a 9 céntimos: 1,59 € Opus 5.5 y 1,50 € Astra, con más nota para Opus 5.5, 53,6 frente a 50,9.
A máximo contra máximo el orden se invierte: Astra acaba la tarea por 2,84 € y Opus 5.5 por 5,22 €. De alto a máximo, Opus 5.5 multiplica su coste por tarea por 3,28: dos peldaños, algo más del triple de gasto, para pasar de 53,6 a 57,6 puntos. Y a medio, su valor por defecto, se queda justo por debajo del mejor Astra, 51,2 frente a 52,7, por un 59 % menos: 1,17 € frente a 2,84 €.
Coste por tarea del índice según el nivel de esfuerzo
Menos es mejor. Barras a escala de 6 €. Crédito: Artificial Analysis, coste por tarea del Intelligence Index v4.3 a tarifa estándar, lectura del 22 de septiembre de 2026 (el índice no cambió el 23). Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Abajo del todo el orden vuelve a girar, esta vez en la nota: Astra a bajo saca 45,8 frente a 42,3 y cuesta 0,71 € frente a 0,48 €. Y queda el argumento del fabricante: Anthropic afirma que en FrontierCode, a su esfuerzo por defecto, Opus 5.5 le gana a Astra gastando alrededor de una quinta parte de su coste por tarea, y que en Terminal Bench 4.0 lo iguala con cerca del 40 %. Son cifras de Anthropic sobre su propio modelo.
La caché de prompts, donde se abre la brecha para los agentes
En la lectura de caché la brecha pasa de 2,5 a 5 veces. Opus 5.5 lee un millón de tokens cacheados por 0,17 € y Astra por 0,87 €. Es lo que un agente paga en cada paso, porque relee su contexto cada vez que decide algo. La escritura ocurre muchas menos veces: 4,36 € el millón en Opus 5.5 con la caché de cinco minutos y 10,90 € en Astra.
Por eso, en un proyecto de agentes de IA, esta fila suele pesar más que la de entrada. Por encima de 272.000 tokens de entrada la distancia se abre otra vez: Astra dobla su lectura de caché a 1,74 € por millón y la tarifa de Anthropic no se mueve. Diez veces, y justo en el trabajo que pasa de ese umbral: un agente que relee el manual interno o un año de correo con un cliente en cada paso.
Sin exagerar: es Opus 5.5 el que ha bajado, no Astra el que ha subido: Opus 5 leía caché a 0,44 € y Opus 5.5 a 0,17 €, un 60 % menos, como dice el propio anuncio. En porcentaje de su propia entrada gana Claude Fable 5.1, con un 2,5 % frente al 5 % de Opus 5.5. Y GPT 6 Sol, que OpenAI presentó junto a Luna, empata con Opus 5.5 a 0,17 € el millón.
Leer un millón de tokens de caché, en euros
Menos es más barato. Por encima de 272.000 tokens de entrada, OpenAI dobla la tarifa de caché de toda la petición; Anthropic cobra la ventana entera a tarifa normal. Los dos paneles a escala de 1,74 €. Fuentes: páginas de precios de Anthropic y OpenAI, 22 de septiembre de 2026. Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Petición de menos de 272.000 tokens
Petición de más de 272.000 tokens
El tramo de los 272.000 tokens de Astra
Astra tiene una cláusula que está en su ficha pero se pasa por alto con facilidad, y que cambia la factura. Cuando una petición pasa de 272.000 tokens de entrada, OpenAI la cobra entera al doble en entrada y en caché, y a 1,5 veces en salida. No solo el trozo que se pasa: toda la llamada, desde el primer token. En euros, 17,45 € de entrada, 65,43 € de salida y 1,74 € de lectura de caché por millón.
Anthropic hace lo contrario y lo pone por escrito: una petición de 900.000 tokens se cobra al mismo precio por token que una de 9.000. Con ventanas de un millón de tokens o más en los dos modelos, el umbral se cruza antes de lo que parece. En sectores como el de las asesorías y gestorías, donde cada cliente arrastra años de papeles, un expediente completo puede pasarlo en una sola llamada.
La consecuencia es de diseño antes que de compra. Si vas a meter documentos grandes en Astra, compensa trocear y recuperar solo lo necesario en vez de volcarlo todo en cada llamada, algo básico en cualquier proyecto de automatización documental.
Velocidad y latencia: lo que cambia de un día a otro
Aquí todo va con fecha. El índice y el coste por tarea salieron idénticos el 22 y el 23 de septiembre; la latencia, no. Lo que sí aguanta los dos días es el ritmo de escritura: según Artificial Analysis, en tokens por segundo Opus 5.5 va más rápido que Astra en todos los esfuerzos medidos para los dos. A esfuerzo alto, el 23 de septiembre, 90 frente a 50.
Tokens de salida por segundo según el nivel de esfuerzo
Más es mejor. Mediana medida por Artificial Analysis el 23 de septiembre de 2026. Barras a escala de 100.
Falta una barra: Claude Opus 5.5 a esfuerzo máximo no tiene velocidad medida, ni el 22 ni el 23 de septiembre. Sin medir no es cero.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Empezar a responder es otra historia. El tiempo hasta el primer fragmento de respuesta de Opus 5.5 a esfuerzo alto pasó de 12,65 segundos el 22 de septiembre a 39,80 el 23: se triplicó de un día para otro. Aun así, ese día seguía arrancando antes que Astra a alto, que tardó 79,00 segundos. Bajando el esfuerzo se invierte: a medio, el 23 de septiembre, Astra soltó su primer fragmento en 6,19 segundos y Opus 5.5 en 24,35.
| Primer fragmento de respuesta, en segundos | 22 de septiembre | 23 de septiembre |
|---|---|---|
| Claude Opus 5.5 (xhigh) | 170,23 | 160,33 |
| Claude Opus 5.5 (high) | 12,65 | 39,80 |
| Claude Opus 5.5 (medium) | 22,48 | 24,35 |
| Claude Opus 5.5 (low) | 7,03 | 7,03 |
| GPT 6 Astra (max) | 323,74 | 342,30 |
| GPT 6 Astra (high) | 79,00 | 79,00 |
| GPT 6 Astra (medium) | 6,36 | 6,19 |
| GPT 6 Astra (low) | 2,86 | 2,79 |
Tiempo hasta el primer fragmento de respuesta, en dos lecturas del tablero público. Claude Opus 5.5 a esfuerzo máximo no tiene latencia medida en ninguna de las dos. Fuente: Artificial Analysis (artificialanalysis.ai).
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Así que «Opus 5.5 es más rápido» es falso como regla general. A esfuerzo bajo, la respuesta completa del 23 de septiembre quedó en 13,19 segundos para Astra y 13,49 para Opus 5.5, prácticamente un empate. En lo medido arriba, los dos tardan minutos: ese día, Opus 5.5 a muy alto necesitó 160,33 segundos hasta el primer fragmento y Astra a máximo 342,30. Opus 5.5 a máximo sigue sin medir en las dos lecturas, y sin medir no es cero.
Para una empresa española esto se decide más por el horario que por el proveedor. Lo que una persona espera en horario de oficina, como un chatbot con clientes, va en alto o por debajo, y la espera se mide con tus prompts, porque la tabla de un día no vale para el siguiente. Lo que se procesa de noche puede subir a muy alto o máximo.
Dónde se procesan tus datos si tu empresa está en Europa
Ningún benchmark contesta una pregunta que pesa en cualquier revisión seria en España: dónde se procesan los datos. Y aquí la comparación se da la vuelta. OpenAI tiene una región Europa, que cubre el Espacio Económico Europeo y Suiza, con almacenamiento y procesamiento, y GPT 6 Astra figura en su lista de modelos con procesamiento europeo para respuestas, chat y lotes, según su guía de datos consultada el 22 de septiembre.
Tiene letra pequeña: hay que pasar por ventas para ver si eres elegible, estar aprobado para los controles de vigilancia de abusos (abuse monitoring) y firmar una Modified Retention amendment. Los endpoints de residencia cobran además un recargo del 10 % en los modelos publicados desde el 5 de marzo de 2026, Astra incluido. Y la residencia no cubre los datos de sistema, como metadatos, uso o facturación, que pueden salir de la región.
En la API de Anthropic no hay opción europea. Su documentación, consultada el 23 de septiembre, solo admite Estados Unidos o enrutado global como geografía de inferencia, y hoy los datos en reposo del espacio de trabajo solo pueden estar en Estados Unidos. Fijarlo en Estados Unidos cuesta 1,1 veces la tarifa. Anthropic dice que los endpoints regionales de Bedrock y Google Cloud llevan un 10 % de sobreprecio, pero no he comprobado si Opus 5.5 está en alguna región europea de esas nubes.
Anthropic dice que Opus 5.5 se puede usar con retención de datos cero, como los Opus anteriores, y OpenAI también la contempla: es una de las dos vías que pide para su región europea. Pero residencia y retención son preguntas distintas para el RGPD: una dice dónde se guarda y se procesa el dato, y la otra si se guarda y cuánto tiempo. Ninguna, por sí sola, te hace cumplir nada. El marco general está en la guía de RGPD y AI Act.
Un aviso más. Anthropic declara que Opus 5.5 es más propenso que modelos anteriores a seguir instrucciones maliciosas en texto que el usuario pega en su propio prompt. Por separado, OpenAI dice en su card que Astra es su primer modelo en llegar al nivel «Critical» de capacidad en ciberseguridad. Son marcos distintos y no se comparan. Si en tu empresa se pegan documentos sin control, terreno de la shadow AI, lo primero importa.
Qué modelo elegiría para un proyecto de cliente
Cada fabricante habla de sus propios modelos. Anthropic escribe que, si no sabes cuál usar, empieces por Claude Opus 5.5 para la mayoría de cargas, y pases a Claude Fable 5.1 para el razonamiento exigente, el trabajo agéntico largo o cuando tus pruebas con Opus 5.5 se queden cortas. OpenAI, en su índice de modelos, dice que si no sabes por dónde empezar uses GPT 6 Astra, su modelo insignia para razonamiento complejo y programación.
Si buscas más nota que el mejor Astra pagando menos, empezaría por Opus 5.5 a esfuerzo alto: lo supera y la tarea cuesta un 44 % menos. Si hay una persona esperando, mide antes la espera: el 23 de septiembre, Opus 5.5 a alto tardó 39,80 segundos en su primer fragmento y Astra a medio, 6,19. Y si nadie espera la respuesta, la cuenta sale al revés: Astra a máximo termina la tarea por 2,84 € frente a 5,22 €.
Opus 5.5 a máximo te da el primer puesto del tablero, y eso se paga a sabiendas, para trabajo donde equivocarse sale caro. Astra tiene además bazas que no salen en el índice. En FrontierSWE v2, una prueba de 34 tareas larguísimas, saca más nota; las herramientas de programación las comparo en Claude Code frente a Codex. Y si el procesamiento en Europa por la API propia del fabricante es requisito, de los dos solo OpenAI lo documenta hoy.
| Lo que vas a montar | Por dónde empezaría | Coste por tarea del índice | Por qué |
|---|---|---|---|
| Más nota que el mejor Astra pagando menos | Claude Opus 5.5, high | 1,59 € | Supera al mejor Astra en el índice. Si hay alguien esperando, mide la espera: cambia de un día a otro |
| Agentes que releen un contexto largo | Claude Opus 5.5, el nivel que pida la tarea | según el nivel | La lectura de caché cuesta 0,17 € el millón frente a 0,87 €, y la distancia sube a diez veces por encima de 272.000 tokens |
| Trabajo desatendido a esfuerzo máximo | GPT 6 Astra, max | 2,84 € | 52,7 puntos en el índice por poco más de la mitad de lo que cuesta el máximo de Claude. Por lotes, los dos cobran la mitad |
| Clasificar y enrutar a volumen | GPT 6 Astra, low | 0,71 € | 45,8 puntos frente a 42,3 de Claude a low. En las lecturas del 22 y el 23 de septiembre, la respuesta completa tardó prácticamente lo mismo en los dos: elige por nota y precio |
| Datos que deben procesarse en Europa | GPT 6 Astra, con residencia europea | el del nivel elegido, más el recargo del 10 % de OpenAI | OpenAI lo procesa en su región europea si pasas por ventas; la API de Anthropic solo ofrece Estados Unidos o enrutado global |
Coste por tarea a tarifa estándar, lectura del 22 de septiembre: Fuente: Artificial Analysis (artificialanalysis.ai). El recargo del 10 % es de OpenAI. Convertido a 1 euro = 1,1463 dólares, tipo del BCE del 22 de septiembre de 2026.
Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
Una advertencia: ninguna de estas cifras sale de tus documentos, tu idioma ni tu proceso. Por eso las pruebas propias pesan más que cualquier clasificación pública, más aún con diferencias de uno o dos puntos. Para eso sirve una consultoría de IA bien planteada: medir con tu carga real, escalón por escalón, antes de firmar nada.
Preguntas frecuentes sobre GPT 6 Astra vs Claude Opus 5.5
¿Cuál es mejor, GPT 6 Astra o Claude Opus 5.5?
En el índice independiente de Artificial Analysis, Claude Opus 5.5: saca 57,6 a esfuerzo máximo frente a 52,7 de GPT 6 Astra, y a esfuerzo alto ya supera al mejor Astra. Pero en la tabla del propio Anthropic, Astra se lleva dos de las ocho pruebas con cifra para los dos, y puntúa más en FrontierSWE v2.
¿Cuál sale más barato?
Depende del esfuerzo. Astra cobra 2,5 veces más por token, pero a esfuerzo máximo su tarea del índice cuesta 2,84 € frente a 5,22 € de Opus 5.5. A esfuerzo alto casi empatan, 1,50 € y 1,59 €, con más nota para Opus 5.5. Y Opus 5.5 a alto supera al mejor Astra y cuesta un 44 % menos.
¿Cuánto cuestan GPT 6 Astra y Claude Opus 5.5 en España?
Los dos facturan en dólares. Al tipo del BCE del 22 de septiembre de 2026, Claude Opus 5.5 cuesta 3,49 € por millón de tokens de entrada y 17,45 € de salida. GPT 6 Astra, 8,72 € y 43,62 €, y por encima de 272.000 tokens cobra toda la petición a 17,45 € y 65,43 €.
¿Cuál conviene para agentes?
Por coste, Claude Opus 5.5. Un agente relee su contexto en cada paso, y la lectura de caché cuesta 0,17 € por millón en Opus 5.5 frente a 0,87 € en GPT 6 Astra: cinco veces menos, y diez por encima de 272.000 tokens. Pero en FrontierSWE v2, con tareas ultralargas, puntúa más Astra: prueba los dos con tus flujos largos.
¿Cuál responde antes?
Depende del esfuerzo y del día. Según Artificial Analysis, el 23 de septiembre de 2026 Claude Opus 5.5 a esfuerzo alto tardaba 39,80 segundos en soltar el primer fragmento de respuesta frente a 79,00 de GPT 6 Astra a alto; el día anterior, Opus 5.5 a alto había tardado 12,65. A esfuerzo medio, Astra respondía antes: 6,19 segundos frente a 24,35. Opus 5.5 a máximo sigue sin medir.
¿Puedo procesar los datos en Europa con alguno de los dos?
Por la API directa del fabricante, solo con GPT 6 Astra: OpenAI tiene una región Europa con procesamiento, sujeta a pasar por ventas para ver si eres elegible, a una Modified Retention amendment y a un recargo del 10 %. La API de Anthropic solo ofrece Estados Unidos o enrutado global. Y la residencia, por sí sola, no garantiza el cumplimiento del RGPD.
¿Claude Opus 5.5 es tan bueno como Claude Fable 5.1?
Anthropic dice que rinde a su nivel en la mayoría del trabajo y aconseja, si no sabes cuál usar, empezar por Opus 5.5 y pasar a Fable 5.1 para el razonamiento exigente o el trabajo agéntico largo. Cómo quedaban en la generación anterior lo cuento en Opus 5 frente a Fable 5.
¿Se puede usar Claude Opus 5.5 en AWS, Google Cloud o Azure?
Sí. Anthropic dice que Opus 5.5 está disponible en todas las plataformas, incluidas AWS, Google Cloud y Microsoft Azure. Por separado, dice que se puede usar con retención de datos cero, sin precisar en qué plataformas. No he comprobado si está en alguna región europea de Bedrock o Google Cloud, y la propia Anthropic avisa de que los endpoints regionales de esas nubes llevan un 10 % de sobreprecio.
Primero el nivel de esfuerzo, después la marca
Opus 5.5 a esfuerzo alto le ganó a Astra a máximo y costó un 44 % menos. Súbelo dos peldaños, hasta máximo, y su tarea cuesta 3,28 veces más, lo bastante para que la barata pase a ser la del rival. Abajo del todo, lo que se da la vuelta es el orden de la nota. Con una excepción: si tu agente relee mucho contexto, la caché vuelve a poner la marca por delante.
Si revisara hoy un proyecto, lo primero que buscaría es un agente que sigue en el esfuerzo del día en que se montó. No parece roto, pero gasta de más o piensa de menos. El arreglo es pequeño: cada tarea, al escalón más barato que siga pasando tus pruebas. Si quieres que lo revisemos con tus prompts reales, reserva una llamada y lo miramos juntos.
Última actualización: 23 de septiembre de 2026
- Anthropic, anuncio de Claude Opus 5.5: tarifas de lista y de caché, modo rápido, el 40 % menos que Opus 5 en cargas típicas, las afirmaciones de coste frente a GPT 6 Astra en FrontierCode y Terminal Bench 4.0, la nota de que Zapier hizo AutomationBench sin modelos de reserva, la cautela sobre los márgenes de los benchmarks, las plataformas y la retención de datos cero. 22 de septiembre de 2026.
- Anthropic, documentación de Claude Opus 5.5: ventana de contexto, salida máxima, corte de conocimiento, niveles de esfuerzo y el medio por defecto, pensamiento adaptativo siempre activo y el compromiso de no retirarlo antes del 22 de septiembre de 2027. Consultada el 22 de septiembre de 2026.
- Anthropic, resumen de modelos: la recomendación de empezar por Claude Opus 5.5 y reservar Claude Fable 5.1, y el paso de Claude Opus 5 a la lista de modelos heredados. Consultado el 22 de septiembre de 2026.
- Anthropic, system card de Claude Opus 5.5: la tabla 8.1.A (página 174) con su nota metodológica, y del capítulo 8 los resultados de FrontierSWE v2, SWE bench Pro, FrontierCode por nivel de esfuerzo y el error típico de Terminal Bench Science, además de la regresión con instrucciones pegadas en el prompt. 22 de septiembre de 2026.
- Anthropic, precios de la API: lectura de caché de Claude Opus 5.5 y su porcentaje frente al de Claude Fable 5.1, lotes, precio de la ventana larga y el 10 % de sobreprecio de los endpoints regionales de Bedrock y Google Cloud. Consultada el 22 y el 23 de septiembre de 2026.
- Anthropic, residencia de datos: las geografías de inferencia disponibles, Estados Unidos o global, la del espacio de trabajo y el multiplicador de 1,1 por fijar Estados Unidos. Consultada el 23 de septiembre de 2026.
- OpenAI, ficha de GPT 6 Astra: tarifas de entrada, salida y entrada en caché, ventana de contexto, salida máxima, corte de conocimiento, niveles de esfuerzo y el recargo por encima de 272.000 tokens de entrada. Consultada el 22 de septiembre de 2026.
- OpenAI, precios de la API: tarifas de tramo largo y por lotes de GPT 6 Astra, lectura de caché de GPT 6 Sol y escritura de caché. Consultada el 22 de septiembre de 2026.
- OpenAI, índice de modelos: la recomendación de empezar por GPT 6 Astra si no sabes por dónde empezar. Consultado el 22 de septiembre de 2026.
- OpenAI, guía de datos y residencia: la región Europa (Espacio Económico Europeo y Suiza) con almacenamiento y procesamiento, la lista de modelos con procesamiento europeo, los requisitos de ventas, abuse monitoring y Modified Retention amendment, la exclusión de los datos de sistema y el recargo del 10 % para modelos publicados desde el 5 de marzo de 2026. Consultada el 22 de septiembre de 2026.
- OpenAI, system card de GPT 6 Astra: su clasificación como primer modelo de OpenAI en el nivel «Critical» de capacidad en ciberseguridad según su marco de preparación. Consultada el 22 de septiembre de 2026.
- Fuente: Artificial Analysis (artificialanalysis.ai): índice de inteligencia v4.3, coste por tarea, tokens por segundo, primer fragmento de respuesta y respuesta completa, en el tablero público leído el 22 y el 23 de septiembre de 2026, y la subpuntuación de no alucinación de AA Omniscience del 22 de septiembre. El índice de programación, sin medir para Claude Opus 5.5, sale de su Data API, leída el 23 de septiembre de 2026. Las gráficas y tablas basadas en estos datos llevan su logotipo o su crédito. Basado en datos de Artificial Analysis. Artificial Analysis no avala, valida ni aprueba este análisis ni sus conclusiones, y no es responsable de ellos.
- Banco Central Europeo, tipo de cambio de referencia: 1 euro = 1,1463 dólares el 22 de septiembre de 2026, usado en todas las conversiones de esta guía.
Las cifras del índice reflejan el tablero tal como estaba el 22 y el 23 de septiembre de 2026 y cambian cuando los modelos se vuelven a medir. Las cifras de benchmarks atribuidas a Anthropic son del propio fabricante.