Todos los modelos actuales de Claude traen un selector de esfuerzo y casi nadie lo toca. Los niveles de esfuerzo de Claude deciden cuánto trabaja el modelo en cada respuesta: bajo, medio, alto, muy alto o máximo. Si eliges mal, pagas un razonamiento que no necesitabas o recibes una respuesta floja justo en la tarea que importaba. Para una pyme que paga la API por tokens, este ajuste ya mueve la factura más que el propio modelo.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y me paso buena parte de la semana leyendo tablas de benchmarks al lado de las facturas. El esfuerzo es justo donde las dos cosas se separan. Con la familia Claude 5.5, Anthropic cambió los valores por defecto, así que una petición que no fija el esfuerzo puede correr hoy un nivel por debajo de lo que corría.
En esta guía tienes qué hace cada nivel, el valor por defecto de cada modelo, lo que cuesta y lo que tarda una tarea terminada en cada ajuste, cuándo compensa cambiar de modelo y cómo se compara con los niveles de razonamiento de ChatGPT. Si aún dudas entre modelos, empieza por qué modelo de Claude usar. Los datos clave van aquí abajo.
Basado en datos de Artificial Analysis (artificialanalysis.ai), que no avala este análisis ni es responsable de él. Índice de inteligencia, coste por tarea y tiempo de respuesta completo, datos leídos el 18 de octubre de 2026. Convertido a 1 € = 1,1253 dólares estadounidenses (BCE, 16 de octubre de 2026).
Qué controla el nivel de esfuerzo de Claude
El esfuerzo es un único ajuste que le dice a Claude cuántos tokens puede gastar en una respuesta. Anthropic es muy concreta: afecta a todos los tokens de salida, es decir, a la respuesta que ves, a las llamadas a herramientas y a sus argumentos, y al razonamiento previo. Con menos esfuerzo, además, hace menos llamadas a herramientas y más escuetas. Es una señal de comportamiento, no un presupuesto cerrado: a bajo, Claude sigue razonando ante un problema difícil, solo que menos.
Conviene no confundirlo con el interruptor del pensamiento. En Opus 5.5 el pensamiento está siempre encendido y no se puede apagar; el esfuerzo es lo que regula hasta dónde llega. Si usas Claude Code verás la misma idea en su control de esfuerzo, calibrado por modelo: alto en Haiku 5.5 no equivale al mismo trabajo que alto en Opus 5.5.
| Nivel | Qué dice Anthropic | Para qué sirve | Modelos |
|---|---|---|---|
| bajo (low) | El más eficiente: ahorra muchos tokens a cambio de algo de capacidad | Tareas sencillas y subagentes donde mandan la velocidad y el coste | Todos los que tienen esfuerzo |
| medio (medium) | Equilibrado, con un ahorro moderado de tokens | Agentes que necesitan equilibrio entre velocidad, coste y calidad | Todos los que tienen esfuerzo |
| alto (high) | Gasta los tokens que la tarea necesite | Razonamiento complejo, código difícil, agentes | Todos los que tienen esfuerzo |
| muy alto (xhigh) | Capacidad ampliada para trabajos largos | Programación y agentes de más de 30 minutos, con millones de tokens | Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1 y otros; no todos |
| máximo (max) | Sin ningún límite de gasto de tokens | El razonamiento más profundo para los problemas más difíciles | Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1 y otros |
Fuente: Anthropic, documentación del parámetro effort de la API de Claude, leída el 18 de octubre de 2026. Descripciones resumidas de la tabla de Anthropic.
Un detalle práctico para cualquier empresa española: el esfuerzo cambia el número de tokens, nunca el precio por token. Una pyme de Valencia que usa la API paga lo mismo por millón de tokens a bajo que a máximo; lo que cambia es cuántos millones se come cada encargo. Si todavía estás viendo dónde encaja la IA en tu negocio, nuestro test de madurez digital se hace en unos minutos.
El esfuerzo por defecto en cada modelo de Claude y en Claude Code
El valor por defecto es el que van a usar la mayoría de tus peticiones, así que merece la pena conocerlo bien. En la API de Claude, casi todos los modelos arrancan en alto. Las excepciones son Claude Opus 5.5 y Claude Haiku 5.5, que arrancan en medio. Anthropic avisa de que una petición a Opus 5.5 sin esfuerzo fijado corre ahora un nivel por debajo de la misma petición a Opus 5, que arrancaba en alto.
Claude Code tiene sus propios valores: medio en Opus 5.5, Sonnet 5.5 y Haiku 5.5, muy alto en Opus 4.7 y alto en todo lo demás. En las apps de Claude, cada modelo marca su nivel por defecto en el propio menú. Y si llegas a Claude a través de Amazon Bedrock o Google Cloud, el esfuerzo funciona igual que en la API.
| Modelo | API de Claude | Claude Code | Pensamiento |
|---|---|---|---|
| Claude Opus 5.5 | medio | medio | Adaptativo, siempre encendido |
| Claude Sonnet 5.5 | alto | medio | Adaptativo; se recorta con between_tools hasta alto |
| Claude Haiku 5.5 | medio | medio | Encendido; se puede apagar hasta alto |
| Claude Fable 5.1 | alto | alto | Adaptativo |
| Opus 5 y Opus anteriores | alto | alto (Opus 4.7: muy alto) | Depende del modelo |
Fuentes: Anthropic, documentación del parámetro effort; Claude Code, configuración de modelos. Ambas leídas el 18 de octubre de 2026. En las apps de Claude cada modelo marca su propio nivel por defecto en el menú de esfuerzo.
Las pruebas de la propia Anthropic dan un motivo para no alarmarse con el nivel más bajo: en Claude Code, Opus 5.5 a medio iguala o supera a Opus 5 a alto en programación y trabajo de conocimiento. El problema son los ajustes heredados de modelos anteriores. Anthropic recomienda volver a probar los niveles con tus propias tareas en cada modelo nuevo, que es justo el tipo de revisión con el que suele empezar nuestra consultoría de inteligencia artificial.
Niveles de esfuerzo de Opus 5.5: nota, coste y espera
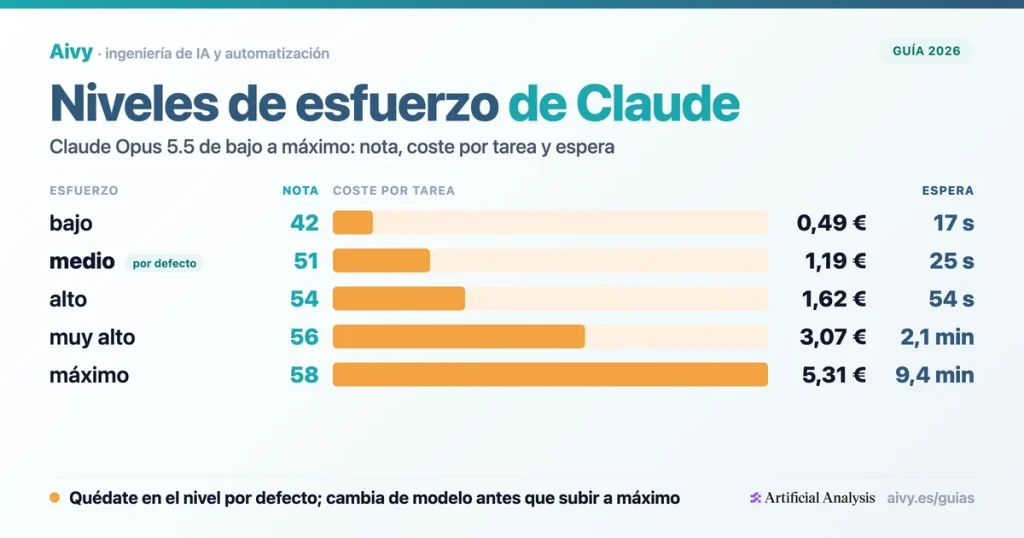
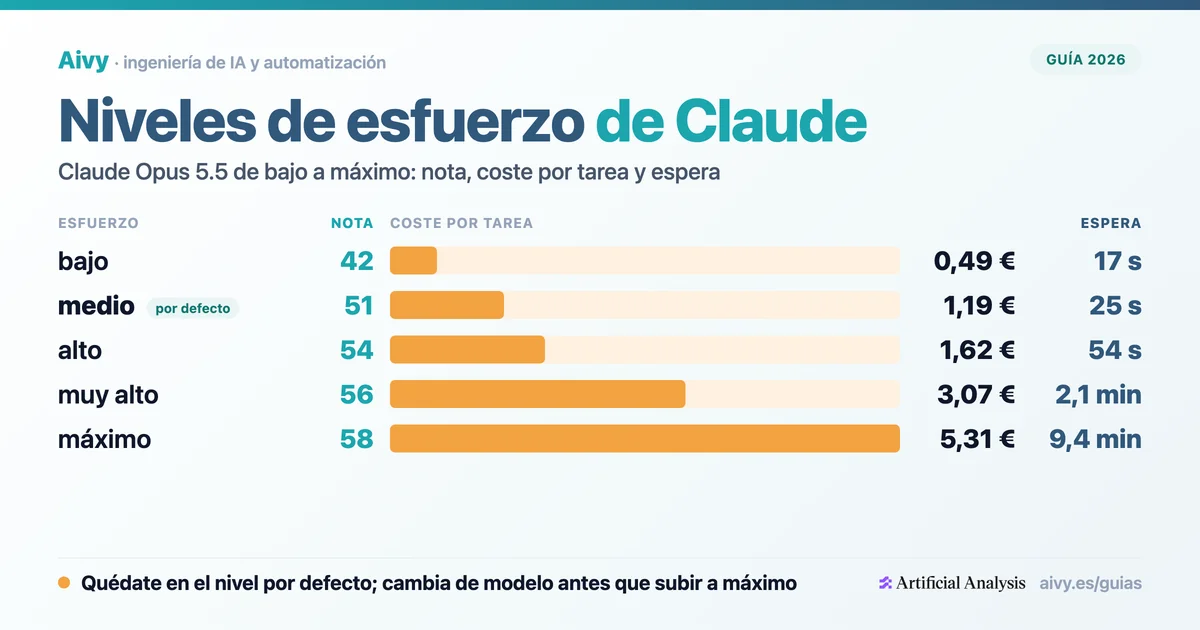
Artificial Analysis pasa cada modelo de Claude, en todos sus niveles de esfuerzo, por su índice de inteligencia, y publica la nota, el coste de una tarea terminada y el tiempo hasta la respuesta completa. El 18 de octubre de 2026, Opus 5.5 a medio sacaba un 51 por 1,19 € la tarea y 25 s de espera. A alto subía a 54 por 1,62 €, con el doble de espera.
La curva se aplana enseguida. De bajo a medio se ganan 9 puntos; de medio a alto, 3; de alto a muy alto, 2, por un 90 % más por tarea. Es el mismo patrón que vimos entre modelos en Opus 5.5 vs Fable 5.1: a partir de cierto punto, gastar más compra muy poco.
Claude Opus 5.5 en cada nivel de esfuerzo: nota, coste por tarea y espera
En negrita, medio, el nivel por defecto. Los paneles de coste y tiempo van a escala de la fila de máximo. Fuente: Artificial Analysis, índice de inteligencia, coste por tarea y tiempo de respuesta completo, datos leídos el 18 de octubre de 2026. Convertido a 1 € = 1,1253 dólares estadounidenses (BCE, 16 de octubre de 2026).
Índice de inteligencia, eje de 0 a 100
Coste por tarea
Tiempo hasta la respuesta completa
La espera es la cifra que casi todo el mundo pasa por alto. A máximo, Opus 5.5 tardó 9,4 min en dar una respuesta completa, frente a 25 s a medio. Para alguien que espera delante de la pantalla, es la diferencia entre una herramienta y una cola. Antes de cambiar el nivel por defecto a todo un equipo, mete el sobrecoste en nuestra calculadora de ROI de la IA junto al tiempo que ahorra.
Muy alto vs máximo: lo que compra el último escalón de esfuerzo
Muy alto y máximo son los dos niveles por los que más se pregunta, y la respuesta honesta es que el máximo rara vez compensa. La propia Anthropic describe muy alto como el nivel para programación y agentes de más de 30 minutos, y el máximo como el techo absoluto, sin límite de gasto. En modelos Opus anteriores ya avisaba de que el máximo añade mucho coste a cambio de poca mejora, y de que puede llevar a darle demasiadas vueltas.
Basado en datos de Artificial Analysis (artificialanalysis.ai), que no avala este análisis ni es responsable de él. Datos leídos el 18 de octubre de 2026. Convertido a 1 € = 1,1253 dólares estadounidenses (BCE, 16 de octubre de 2026).
Los números lo confirman. En Opus 5.5, pasar de muy alto a máximo suma 2 puntos por un 73 % más por tarea, y la espera se multiplica por 4,4. En Sonnet 5.5, el mismo paso suma 4 puntos por un 172 % más, y la espera se multiplica casi por diez, de 40 s a 6,4 min.
Veredicto: el máximo es una herramienta para un problema difícil concreto, no un ajuste para todo un equipo. Si muy alto falla, mira por qué antes de pagar un 73 % más por dos puntos.
Donde muy alto sí tiene sentido es en el trabajo largo que, si no, se quedaría a medias: un agente que revisa una cola de tareas durante la noche o una migración grande, como los que repasamos en los mejores agentes de IA. En Claude Code, el máximo dura solo la sesión en curso salvo que lo fijes con una variable de entorno, y es una buena protección.
Sonnet 5.5 a alto vs Opus 5.5 a medio: cambia de modelo, no de esfuerzo
Mucha gente compara Sonnet 5.5 a alto con Opus 5.5 a medio, y es la pregunta correcta. Sonnet 5.5 a alto saca un 47 por 0,78 € la tarea y responde en 16 s. Opus 5.5 a medio saca un 51 por 1,19 € en 25 s. Es decir, Opus con su nivel por defecto es la opción más fuerte y más lenta, y cada tarea sale más o menos un 50 % más cara.
Por encima de ese punto, la lógica se da la vuelta a favor de Opus. Subir Sonnet 5.5 a muy alto le lleva a un 52 por 1,79 €, más caro que Opus 5.5 a medio para casi la misma nota. Lo mismo pasa un escalón más arriba, y es la regla más clara de toda la guía. En nuestra comparativa de Sonnet 5.5 y Opus 5.5 tienes el resto de diferencias.
| Si usas | Nota, coste, espera | Prueba con | Nota, coste, espera | Por qué |
|---|---|---|---|---|
| Sonnet 5.5 a muy alto | 52 por 1,79 €, 40 s | Opus 5.5 a medio | 51 por 1,19 €, 25 s | Casi la misma nota por un tercio menos, y más rápido |
| Sonnet 5.5 a máximo | 56 por 4,85 €, 6,4 min | Opus 5.5 a muy alto | 56 por 3,07 €, 2,1 min | La misma nota por un tercio menos y tres veces más rápido |
| Fable 5.1 a máximo | 53 por 6,78 €, 3,0 min | Opus 5.5 a alto | 54 por 1,62 €, 54 s | Más nota por menos de una cuarta parte |
| Opus 5.5 a bajo | 42 por 0,49 €, 17 s | Haiku 5.5 a máximo | 43 por 0,19 €, 5,3 min | Un punto más por menos dinero, pero con mucha más espera |
Basado en datos de Artificial Analysis (artificialanalysis.ai), que no avala este análisis ni es responsable de él. Datos leídos el 18 de octubre de 2026. Convertido a 1 € = 1,1253 dólares estadounidenses (BCE, 16 de octubre de 2026).
La última fila es la rara. Haiku 5.5 a máximo supera por un punto a Opus 5.5 a bajo y cuesta menos, pero tardó 5,3 min en responder frente a 17 s. Para una asesoría o gestoría que revisa documentos por la noche, puede valer. Para cualquier cosa que un cliente esté esperando, no.
Haiku 5.5 y Fable 5.1 en cada nivel de esfuerzo
Los dos extremos de la gama se comportan de forma distinta. Haiku 5.5 es tan barato por tarea que incluso a máximo cuesta 0,19 €, frente a 0,02 € a bajo. Lo que se dispara es la espera, que pasa de 12 s a 5,3 min. Para un chatbot de atención al cliente con mucho volumen, bajo o medio es el punto de partida sensato.
La guía de Anthropic para Haiku 5.5 va en la misma línea. Propone medio para casi todo, bajo para chat y peticiones sencillas a volumen, y alto para trabajo de conocimiento y agentes largos. También avisa de que, a bajo y con instrucciones de agente largas, el modelo tiende más a saltarse una búsqueda, parar antes de tiempo o saltarse una comprobación.
| Esfuerzo | Haiku 5.5, nota | Haiku, por tarea | Haiku, espera | Fable 5.1, nota | Fable, por tarea | Fable, espera |
|---|---|---|---|---|---|---|
| bajo | 29 | 0,02 € | 12 s | 47 | 2,11 € | 11 s |
| medio | 34 | 0,04 € | 17 s | 49 | 2,65 € | 23 s |
| alto | 38 | 0,07 € | 28 s | 51 | 3,47 € | 28 s |
| muy alto | 41 | 0,11 € | 62 s | 53 | 5,31 € | 86 s |
| máximo | 43 | 0,19 € | 5,3 min | 53 | 6,78 € | 3,0 min |
Basado en datos de Artificial Analysis (artificialanalysis.ai), que no avala este análisis ni es responsable de él. Datos leídos el 18 de octubre de 2026. Convertido a 1 € = 1,1253 dólares estadounidenses (BCE, 16 de octubre de 2026).
Fable 5.1 está en el otro extremo. Arranca en alto, y en estas mediciones saca 53 tanto a muy alto como a máximo: el máximo en Fable 5.1 solo añadió coste y espera. Más revelador todavía, Opus 5.5 a alto sacó 54 por 1,62 €, por encima de Fable 5.1 en cualquier ajuste. En GPT 6 Astra vs Fable 5.1 explicamos dónde sigue teniendo sentido Fable.
Cómo cambiar el esfuerzo en la app de Claude y en Claude Code
En las apps de Claude, pulsa el nombre del modelo junto al botón de enviar y entra en Effort. El menú ofrece Low, Medium, High, Extra high y Max, con el nivel por defecto de cada modelo marcado. El centro de ayuda de Claude es claro con el precio que se paga: más esfuerzo tarda más y gasta más tokens, así que llegas antes al límite de uso, mientras que bajo y medio lo estiran más.
En Claude Code hay más caminos: el comando /effort y su control deslizante, el control dentro de /model, la opción –effort al arrancar y la variable de entorno CLAUDE_CODE_EFFORT_LEVEL. Dos palabras clave confunden mucho. Escribir ultrathink pide más razonamiento solo en ese turno, sin tocar el ajuste. Y ultracode no es un nivel de esfuerzo: es un ajuste que organiza un flujo de trabajo para tareas grandes. Lo demás de la herramienta está en Claude Code vs Codex.
| Dónde | Cómo se cambia | Lo que conviene saber |
|---|---|---|
| Apps de Claude | Pulsa el nombre del modelo junto al botón de enviar y entra en Effort | Low, Medium, High, Extra high y Max; los niveles altos gastan antes el límite de tu plan |
| Claude Code | /effort, el control de /model, –effort al arrancar o CLAUDE_CODE_EFFORT_LEVEL | Max dura solo la sesión salvo con la variable; ultrathink profundiza un único turno |
| API de Claude | output_config.effort en la petición | En Opus 5.5, Sonnet 5.5 y Haiku 5.5 se puede cambiar por mensaje sin perder la caché (beta) |
| Claude Enterprise | El administrador fija un tope por rol y modelo | Los niveles por encima del tope no aparecen |
Fuentes: centro de ayuda de Claude, cambiar el modelo, el esfuerzo y el pensamiento; Claude Code, configuración de modelos; Anthropic, documentación del parámetro effort. Leídas el 18 de octubre de 2026.
En Claude Enterprise, el administrador puede poner un tope de esfuerzo por rol y por modelo, de modo que un puesto de colaborador externo no pueda tirar de máximo todo el día. Conviene dejarlo fijado antes de un despliegue amplio, por ejemplo en una empresa de Madrid que reparte Claude Code entre cuarenta programadores.
Niveles de razonamiento de ChatGPT y esfuerzo de GPT
OpenAI usa la misma idea con otros nombres. En ChatGPT, con GPT 6 seleccionado, un control de pensamiento ofrece Instant, Medium para el razonamiento estándar, High para el ampliado, Extra High y Pro. GPT 6 Sol mueve todo lo que va de Instant a Extra High, y Pro usa GPT 6 Pro, que funciona con GPT 6 Astra. OpenAI añade que pedirle a ChatGPT que piense más no cambia el nivel por ti. Precios en planes de ChatGPT en España.
Aquí el plan pesa más que en Claude. Plus tiene Medium y High, pero no Extra High ni Pro; Pro, Business y Enterprise los tienen todos. Free y Go usan GPT 5.6 Luna, con una opción Think. En Claude vs ChatGPT comparamos lo que cuesta cada plan en España.
| Plan de ChatGPT | Instant | Medium y High | Extra High | Pro (GPT 6 Astra) |
|---|---|---|---|---|
| Free y Go | GPT 5.6 Luna | No incluido (Think usa Luna) | No incluido | No incluido |
| Plus | Incluido | Incluido | No incluido | No incluido |
| Pro | Incluido | Incluido | Incluido | Incluido |
| Business y Enterprise | Incluido | Incluido | Incluido | Incluido |
Fuente: centro de ayuda de OpenAI, GPT 6 y otros modelos en ChatGPT, leído el 18 de octubre de 2026. Con GPT 6 elegido, GPT 6 Sol mueve de Instant a Extra High.
En la API, el esfuerzo de razonamiento de OpenAI va de none a max según el modelo, con medium por defecto en GPT 6.1 Sol. Su curva de coste es mucho más plana que la de Claude: GPT 6.1 Sol a máximo sacó 52 por 0,64 € la tarea, por debajo de Opus 5.5 a alto en nota pero por bastante menos de la mitad. La familia completa está en GPT 6 Astra, Sol y Luna.
Coste por tarea en cada nivel de esfuerzo, Claude Opus 5.5 y GPT 6.1 Sol
Menos es más barato; barras a escala de Opus 5.5 a máximo. El rótulo de cada pareja da la nota de los dos en el índice de inteligencia. Fuente: Artificial Analysis, datos leídos el 18 de octubre de 2026. Convertido a 1 € = 1,1253 dólares estadounidenses (BCE, 16 de octubre de 2026).
Qué nivel de esfuerzo de Claude usar en cada tarea
Si te quedas con una sola idea, que sea el orden: primero eliges el modelo, lo dejas en su nivel por defecto y solo cambias el esfuerzo después de un fallo real que sepas describir. Subir el esfuerzo arregla un razonamiento que se queda corto. No arregla una instrucción vaga, un contexto que falta ni una herramienta equivocada.
| Tarea | Modelo y esfuerzo para empezar | Sube cuando |
|---|---|---|
| Respuestas de chat, clasificar y etiquetar a volumen | Haiku 5.5 a bajo o medio | Se salte pasos o instrucciones |
| Correos, resúmenes y documentos del día a día | Sonnet 5.5 a medio | Los borradores necesiten mucha corrección |
| Programación diaria y corrección de fallos | Sonnet 5.5 a alto, u Opus 5.5 a medio | Los arreglos no pasen las pruebas |
| Análisis que pide criterio | Opus 5.5 a medio, el nivel por defecto | El razonamiento tenga huecos que sepas señalar |
| Agentes largos y refactorizaciones grandes | Opus 5.5 a alto o muy alto | El agente pare antes de tiempo o se salte comprobaciones |
| El único problema que justifica esperar | Opus 5.5 a máximo | Casi nunca: prueba antes muy alto |
Puntos de partida sacados de la guía de esfuerzo de Anthropic y de los datos de Artificial Analysis de esta página. Pruébalos con tus propias tareas antes de fijar nada.
En la automatización contable, con miles de pasos pequeños al mes, las filas de bajo y medio son las que se llevan el presupuesto, y subir un escalón a todo puede doblar la factura. En una clínica que usa IA para el papeleo, lo sensato suele ser un modelo más barato con más esfuerzo, y no al revés.
Mi recomendación: fija el esfuerzo por tarea, no por equipo. Pasa una semana de trabajo real con el nivel por defecto y uno por encima, compara resultados y factura, y quédate con el ajuste más barato que cumpla.
Niveles de esfuerzo de Claude: empieza por el valor por defecto y mide
El esfuerzo es la palanca más barata que tienes y la más fácil de desperdiciar. Los valores por defecto de la familia Claude 5.5 son sensatos, lo que se gana por encima de alto es poco y el máximo es para un problema difícil concreto, no un ajuste para todo un equipo. Cuando un modelo barato a alto deja de bastar, cambiar a Opus 5.5 suele ganar a seguir subiendo el selector.
Imagina una asesoría de Valencia que usa Claude para redactar correos a clientes y revisar conciliaciones. Con estos datos, pasar ese trabajo de Opus 5.5 a medio a máximo subiría cada tarea de 1,19 € a 5,31 € y cada respuesta de 25 s a 9,4 min. Nuestra agencia de inteligencia artificial en Valencia suele encontrar mejor destino para ese dinero.
Basado en datos de Artificial Analysis (artificialanalysis.ai), que no avala este análisis ni es responsable de él. Datos leídos el 18 de octubre de 2026. Convertido a 1 € = 1,1253 dólares estadounidenses (BCE, 16 de octubre de 2026).
Artificial Analysis vuelve a medir estos modelos cuando cambian, así que mira la fecha al pie de esta página antes de fiarte de las cifras. Si quieres una segunda opinión sobre con qué modelo y con qué esfuerzo debería ir cada una de tus tareas, puedes reservar una reunión con nosotros cuando te venga bien.
Preguntas frecuentes sobre los niveles de esfuerzo de Claude
¿Qué nivel de esfuerzo de Claude conviene usar?
Para casi todo, el que trae por defecto: medio en Opus 5.5 y Haiku 5.5, alto en Sonnet 5.5 y Fable 5.1. Súbelo solo cuando sepas decir qué ha fallado, por ejemplo un agente que para antes de tiempo o un razonamiento con huecos.
¿Qué diferencia hay entre los niveles muy alto (xhigh) y máximo (max)?
Muy alto es el nivel que Anthropic propone para programación y agentes largos; máximo quita cualquier límite al gasto de tokens. En Opus 5.5, máximo sacó 2 puntos más que muy alto, con un 73 % más de coste por tarea y mucha más espera.
¿Merece la pena el esfuerzo máximo en Claude Opus 5.5?
Pocas veces. Encaja con un problema difícil concreto en el que esperar no importa. A máximo, Opus 5.5 tardó 9,4 min en dar una respuesta completa en la medición de Artificial Analysis, frente a 2,1 min a muy alto.
¿Un esfuerzo más alto gasta antes el límite de mi plan de Claude?
Sí. Más esfuerzo produce más tokens, así que en un plan de Claude llegas antes al límite de uso. El centro de ayuda de Claude lo dice claro: los niveles bajo y medio estiran más tu uso.
¿Qué hace ultrathink en Claude Code?
Escribir ultrathink pide a Claude Code que razone más a fondo solo en ese turno. El nivel de esfuerzo que se envía a la API no cambia, y frases como «piensa más» se tratan como texto normal.
¿Ultracode es lo mismo que el esfuerzo máximo?
No. Ultracode es un ajuste de Claude Code que organiza un flujo de trabajo para las tareas grandes, con el esfuerzo que tenga la sesión. Si arrancas con ultracode, se enciende y el esfuerzo pasa a muy alto.
¿Es mejor Sonnet 5.5 a alto u Opus 5.5 a medio?
Opus 5.5 a medio sacó 51 frente a 47 de Sonnet 5.5 a alto, pero cuesta más y tarda más. Si Sonnet 5.5 a alto se te queda corto, cambia a Opus 5.5 en vez de subir el esfuerzo de Sonnet.
¿Qué esfuerzo usa Claude Code por defecto?
Medio en Opus 5.5, Sonnet 5.5 y Haiku 5.5; muy alto en Opus 4.7, y alto en el resto de modelos que admiten esfuerzo. El nivel activo se consulta con /effort status.
¿El esfuerzo cambia el precio por token?
No. La tarifa por millón de tokens es la misma en todos los niveles. Lo que cambia es cuántos tokens gasta cada respuesta, y por eso el coste de una tarea terminada se dispara en la parte alta.
¿Qué niveles de razonamiento tiene ChatGPT?
Instant, Medium, High, Extra High y Pro, que se eligen con el control de pensamiento cuando está seleccionado GPT 6. Plus incluye Medium y High; Extra High y Pro piden Pro, Business o Enterprise.
Última actualización: 18 de octubre de 2026
- Anthropic, documentación del parámetro effort: qué controla el esfuerzo, los cinco niveles y su uso típico, qué modelos admiten muy alto y máximo, medio por defecto en Opus 5.5 y Haiku 5.5 y alto en el resto, las recomendaciones por modelo y el cambio de esfuerzo por mensaje. Leída el 18 de octubre de 2026.
- Claude Code, configuración de modelos: el esfuerzo por defecto de cada modelo en Claude Code, el comando /effort, la opción –effort y la variable de entorno, el máximo solo para la sesión, ultrathink, ultracode, los topes de Enterprise y Opus 5.5 a medio frente a Opus 5 a alto. Leída el 18 de octubre de 2026.
- Centro de ayuda de Claude, cambiar el modelo, el esfuerzo y el pensamiento: dónde está el menú de esfuerzo en las apps, qué modelos y niveles ofrece y su efecto en los límites de uso. Leído el 18 de octubre de 2026.
- Centro de ayuda de OpenAI, GPT 6 y otros modelos en ChatGPT: los niveles del control de pensamiento, qué modelo mueve cada uno, la disponibilidad por plan y que pedir que piense más no cambia el nivel. Leído el 18 de octubre de 2026.
- OpenAI, guía de modelos de razonamiento: los valores de esfuerzo de none a max, medium por defecto en GPT 6.1 Sol y cuándo usar cada nivel. Leída el 18 de octubre de 2026.
- Fuente: Artificial Analysis (artificialanalysis.ai): índice de inteligencia, coste por tarea y tiempo de respuesta completo en cada nivel de esfuerzo de Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1 y GPT 6.1 Sol, datos leídos el 18 de octubre de 2026. Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
- Banco Central Europeo, tipo de cambio de referencia: 1 euro = 1,1253 dólares estadounidenses el 16 de octubre de 2026, usado en todas las conversiones de esta guía.